Python命令-u参数作用与缓存机制解析
本文解析Python命令中-u参数的作用,解释标准输出(stdout)与标准错误(stderr)的缓存差异。通过代码示例说明-u如何强制无缓冲输出,并对比Python 2与Python 3的行为差异,帮助开发者理解日志重定向时的输出顺序问题。
2026-10-13
21

本文解析Python命令中-u参数的作用,解释标准输出(stdout)与标准错误(stderr)的缓存差异。通过代码示例说明-u如何强制无缓冲输出,并对比Python 2与Python 3的行为差异,帮助开发者理解日志重定向时的输出顺序问题。
本文介绍如何使用 Python 编写程序自动求解数独。通过将数独转换为矩阵,利用递归和回溯算法,依次寻找空白格并尝试填入符合行列及九宫格规则的数字。文章包含从数据预处理到核心求解逻辑的完整代码示例,帮助开发者理解算法实现细节。
本文详细记录了在 Windows 7 系统中为 Python 2.7 和 Python 3.5 版本安装 OpenCV 的具体步骤。针对 Python 2.7,介绍了手动配置环境变量及复制 cv2.pyd 文件的方法;针对 Python 3.5,重点讲解了通过下载对应版本的 .whl 文件并使用 pip 命令进行离线安装的解决方案,确保 import cv2 无报错。
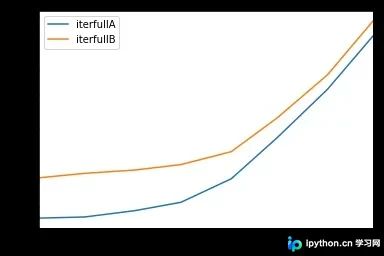
本文详细介绍pandas中遍历Dataframe的三种核心方法:iterrows、itertuples和iteritems。通过对比分析,说明iterrows按行返回(index, Series)对,itertuples按行返回元组且效率更高,iteritems按列返回(列名, Series)对。文章提供具体代码示例,帮助开发者根据性能需求和访问方式选择最合适的数据遍历方案。

本文介绍在Python中使用Pandas库遍历DataFrame每个元素的两种方法。第一种利用applymap函数结合逻辑索引,实现全表快速筛选;第二种通过遍历列名并使用Series.str.contains进行逐列处理。文章对比了两种方式的适用场景,并强调高阶函数在提升数据处理效率方面的优势。
本文详细解析在 Pandas 中遍历 DataFrame 行的多种方法。重点对比了 iterrows()、itertuples()、apply() 以及 iloc 的性能差异与适用场景。文章指出 itertuples() 通常比 iterrows() 更快,并强调避免在迭代中修改数据的重要性,同时提供自定义 namedtuple 迭代器以进一步提升处理效率。
本文解析Python中广度优先搜索(BFS)的实现原理。BFS适用于无权图,按层遍历节点,时间复杂度O(V+E)。通过Python队列(deque)和字典构建图结构,演示如何查找特定目标节点,并提供完整可运行代码示例。
本文介绍了如何使用Python和Matplotlib库绘制温度变化雷达图。通过定义标签、数据及角度,利用polar子图展示每三小时取样的气温趋势,并提供了完整的可运行代码供参考学习。

本文深入解析 Python 异常处理机制,涵盖异常参数的捕获与元组结构、使用 raise 语句手动触发异常,以及通过继承 Exception 或 RuntimeError 创建自定义异常类。详细讲解实例化、参数传递及错误信息输出,帮助开发者掌握更精准的异常控制技巧。
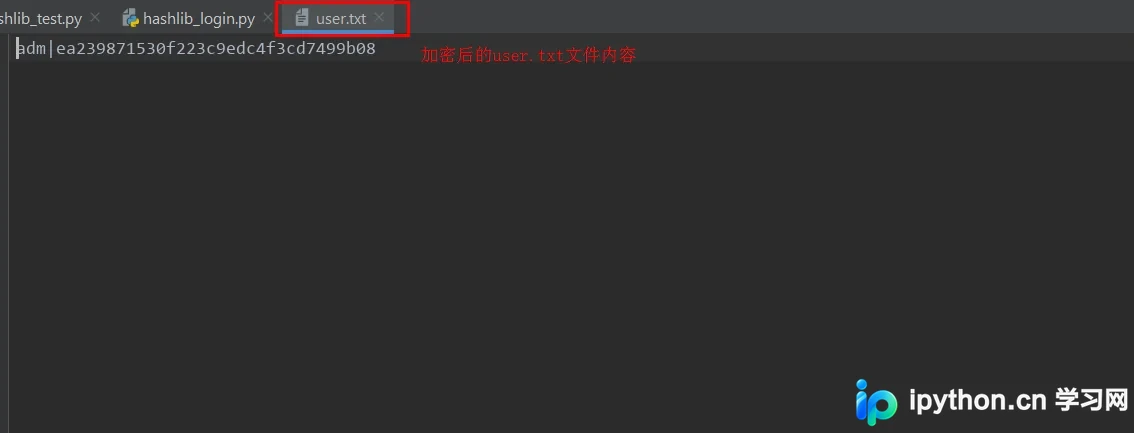
本文详细介绍Python中hashlib模块的用法,涵盖MD5、SHA1至SHA512及SHA3系列算法的加密实现。通过具体代码示例展示各算法的输出结果,并深入解析如何利用hashlib.md5()结合加盐技术实现用户注册与登录验证功能,包含完整的代码逻辑与文件处理细节。
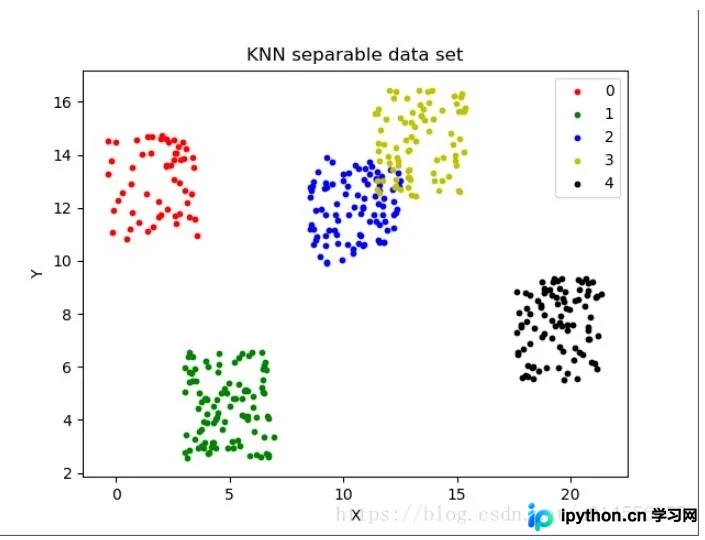
本文通过Python的Matplotlib和Numpy库,详细演示如何可视化实现KNN(最近邻)分类算法。内容涵盖算法核心逻辑、模拟数据集生成、数据可视化展示以及完整的KNN分类代码实现,帮助读者直观理解机器学习基础算法原理。
本文介绍如何在Python脚本中使用requests库发送JSON格式参数。关键在于设置Header中的Content-Type为application/json,并在请求方法中直接使用json参数传入字典数据。通过完整代码示例展示如何构建请求、处理响应及避免中文乱码,适用于API接口测试与自动化脚本开发。