

Python中scipy.stats.norm正态分布函数的使用指南
本文详细解析Python中scipy.stats.norm函数的用法。介绍通过直接调用与实例化两种方式设置均值与标准差的方法,对比概率密度(pdf)与随机抽样(rvs)的差异,并列出cdf、ppf等核心统计方法,帮助快速掌握正态分布建模与数据可视化。
2026-10-12
21

本文详细解析Python中scipy.stats.norm函数的用法。介绍通过直接调用与实例化两种方式设置均值与标准差的方法,对比概率密度(pdf)与随机抽样(rvs)的差异,并列出cdf、ppf等核心统计方法,帮助快速掌握正态分布建模与数据可视化。
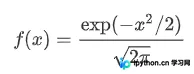
本文通过Python基础实战案例,详细演示了如何安全读取本地文本文件,并使用字典(dict)进行高效的词频统计。借助内置的sorted()函数与列表切片技术,将复杂的键值对数据进行排序,最终精准提取出文件内出现次数最多的前10个单词。非常适合初学者熟悉Python的数据结构与文件流处理。
在 Python 3.7 环境中使用 Sanic 时,安装 sanic-ext 后 /docs 路由无法访问且服务静默不报错。本文通过分析启动日志中的 packages 字段定位问题根源,发现是第三方元数据管理包 importlib-metadata 版本与扩展插件不匹配所致,并提供快速验证与升级建议。
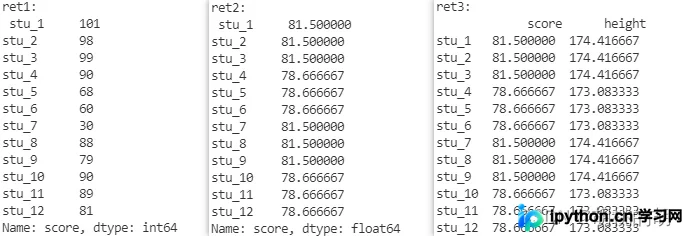
本文详细解析Pandas中transform与apply方法在分组聚合中的区别与应用。通过示例展示如何利用自定义函数处理Series和DataFrame,包括数值计算、字符串操作及多列聚合。重点阐述transform保持原索引长度与apply返回聚合结果的特性,帮助开发者根据需求选择合适方法,提升数据处理效率。
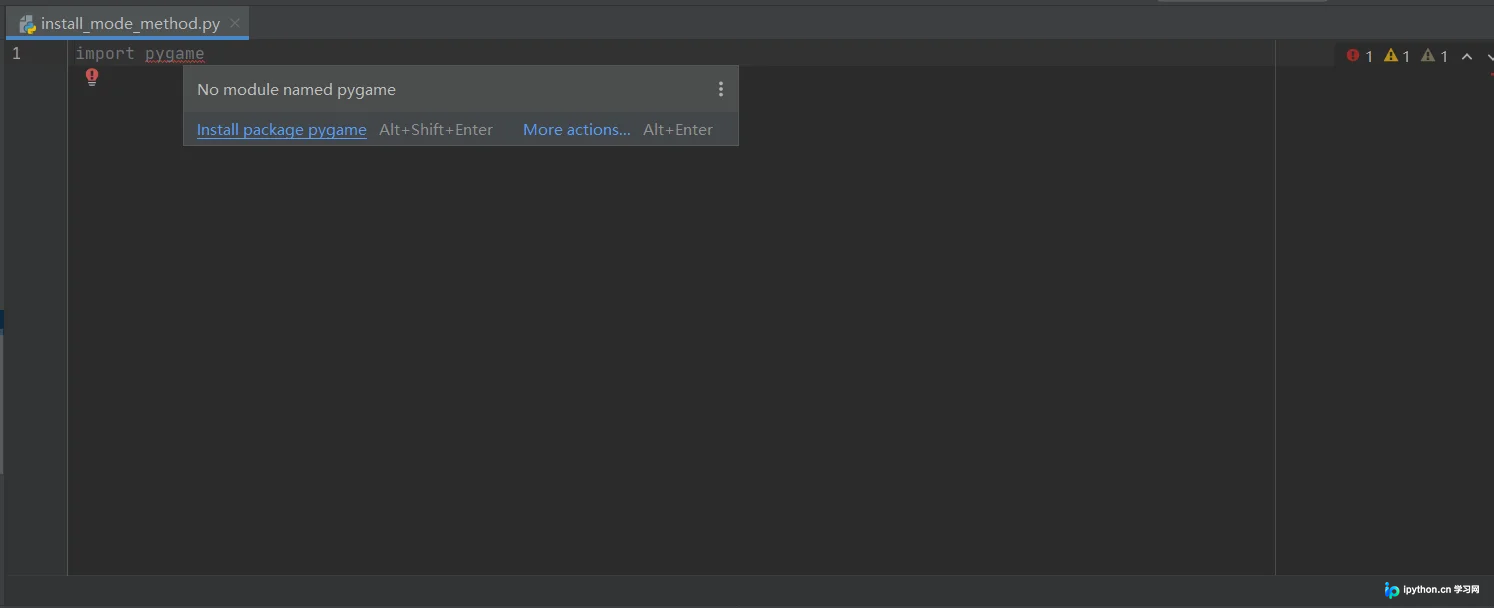
本文详细解析Python模块的安装与卸载方法,涵盖PyCharm图形界面操作、终端pip命令行工具以及第三方whl文件安装三种主流方式。通过pygame模块实例,逐步演示如何从IDE设置中管理依赖、使用指定版本与源进行安装,以及处理非官方库的本地部署流程,帮助开发者高效解决环境配置问题。
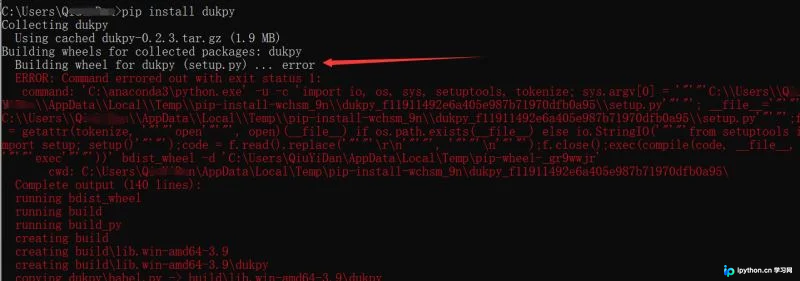
本文详细解析在使用pip安装Python库时遇到的“Failed building wheel for xxx”错误原因及解决方案。该错误通常因缺少预编译的.whl文件导致。通过访问第三方资源网站下载对应Python版本和系统的.whl文件,并手动执行安装命令,可有效绕过编译问题,确保依赖库正常部署。
本文系统梳理Pandas在数据分析中的核心应用,涵盖数据导入导出、重复值与缺失值处理、字符串清洗、数据筛选与抽样、多表合并、时间序列解析及标准化等关键步骤。通过具体代码示例,帮助开发者快速掌握高效处理表格型数据的方法,提升数据预处理效率。
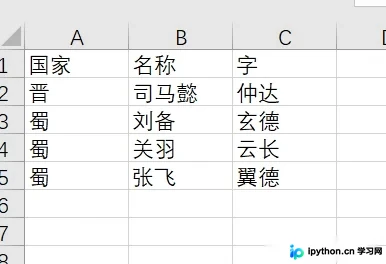
本文详解如何利用Python的Pandas库在Excel和CSV文件中实现类似VLOOKUP的数据关联功能。内容涵盖删除指定行、获取最大行数、上下拼接表格以及使用merge函数进行左连接合并。通过具体代码示例,展示如何高效处理三国人物数据,解决大数据量下的性能问题,并提供从数据清洗到最终合并的完整操作流程。
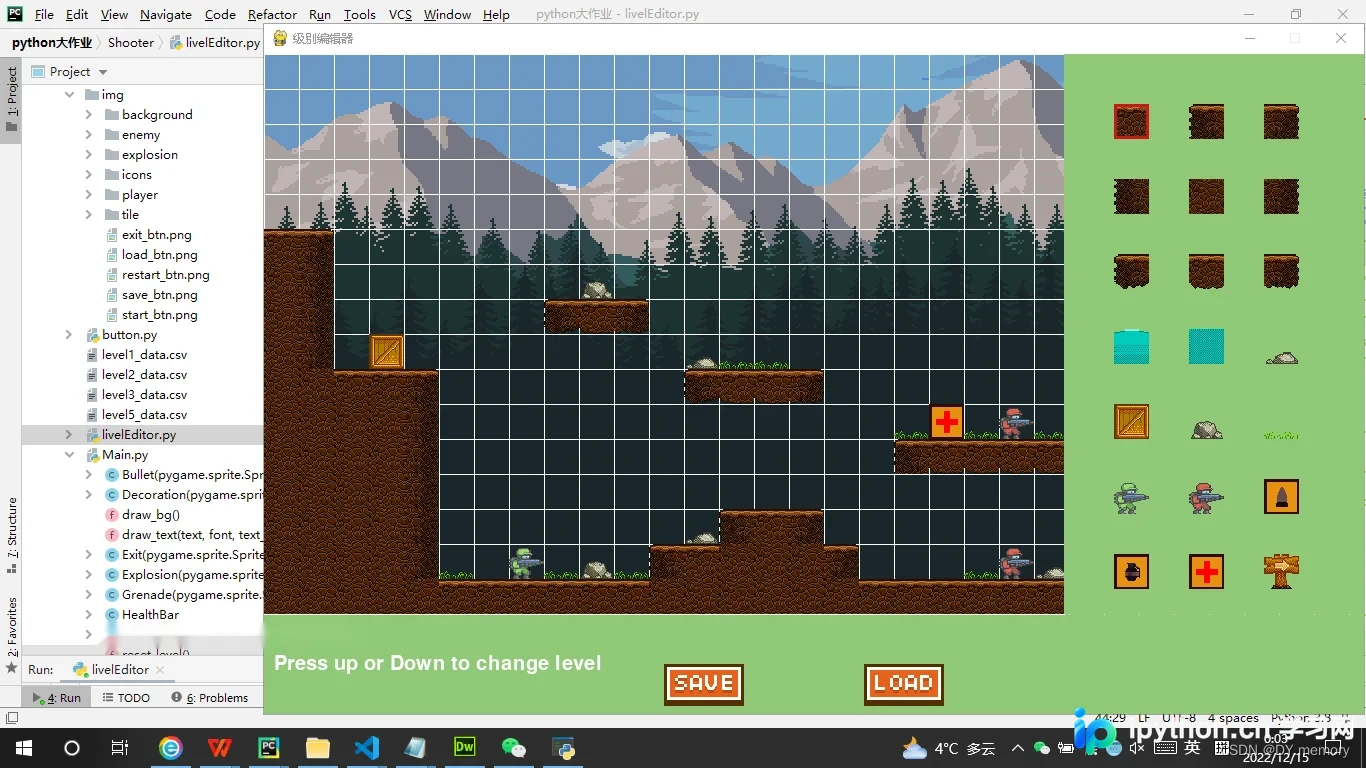
本文介绍使用Python和Pygame开发射击闯关游戏的全过程。项目包含自定义地图编辑器,支持关卡样式与难度定制。游戏实现玩家移动、跳跃、射击及投掷手雷,敌人具备AI行为。内含道具系统、动画音效及地形障碍,总代码约1100行,提供完整源码与运行截图供参考。
本文详细解析Python中lambda匿名函数的定义语法、适用边界及其与def语句的差异,并系统说明apply函数的参数解包机制、现代替代方案以及Pandas DataFrame中的应用逻辑。通过标准代码示例与版本兼容性排查指引,帮助开发者快速掌握高阶函数调用与数据框映射技巧。
在Python中处理文本数据时,经常需要按特定规则拆分字符串。本文详细介绍split()与rsplit()函数的核心机制,重点解析sep分隔符与maxsplit切分次数的参数逻辑,通过对比示例展示从左向右与从右向左分割的差异,帮助开发者高效掌握字符串分割技巧。
本文详细介绍Python中random.shuffle()函数的用法,重点说明其原地打乱列表顺序且不生成新列表的特性。通过代码示例展示具体操作,并深入解析源码实现逻辑,包括随机数生成器的可选参数及Fisher-Yates洗牌算法的核心步骤,帮助开发者正确使用该函数。