Python调用百度识图API完整指南
本文详解如何在Python中调用百度识图API。首先指导用户前往百度智能云注册并获取AK和SK密钥,随后提供完整的Python代码模板,涵盖Token获取、图片Base64编码及API请求流程,帮助开发者快速实现图像识别功能。
2026-10-14
20

本文详解如何在Python中调用百度识图API。首先指导用户前往百度智能云注册并获取AK和SK密钥,随后提供完整的Python代码模板,涵盖Token获取、图片Base64编码及API请求流程,帮助开发者快速实现图像识别功能。
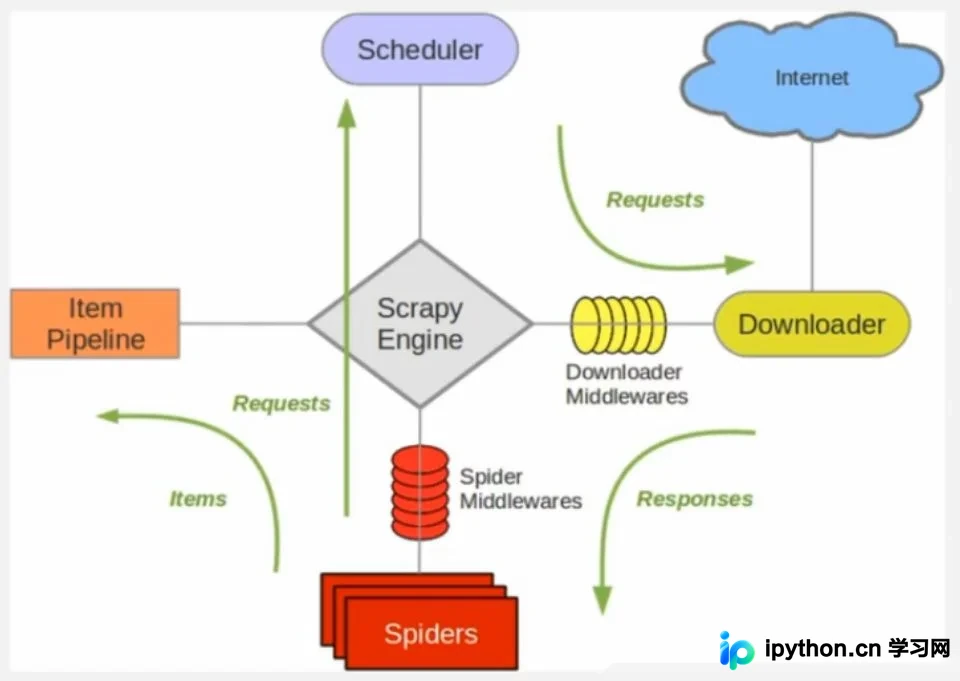
本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
本文详细解析在 Python 中创建守护进程(Daemon)的方法与核心原理。通过两次 Fork 机制、会话组管理、文件描述符重定向及权限掩码设置,实现服务脱离终端控制并常驻后台。文章提供完整 Python 代码示例,并深入剖析守护进程与后台进程的区别,帮助开发者构建稳定的 Linux 后台服务。
本文介绍如何在Scrapy框架中配置动态代理IP以应对网站反爬机制。通过设置DOWNLOADER_MIDDLEWARES启用ProxyMiddleware和CheckProxyMiddleware,并在settings中定义PROXIES列表,实现请求IP的随机切换与基础验证,帮助爬虫稳定获取数据。
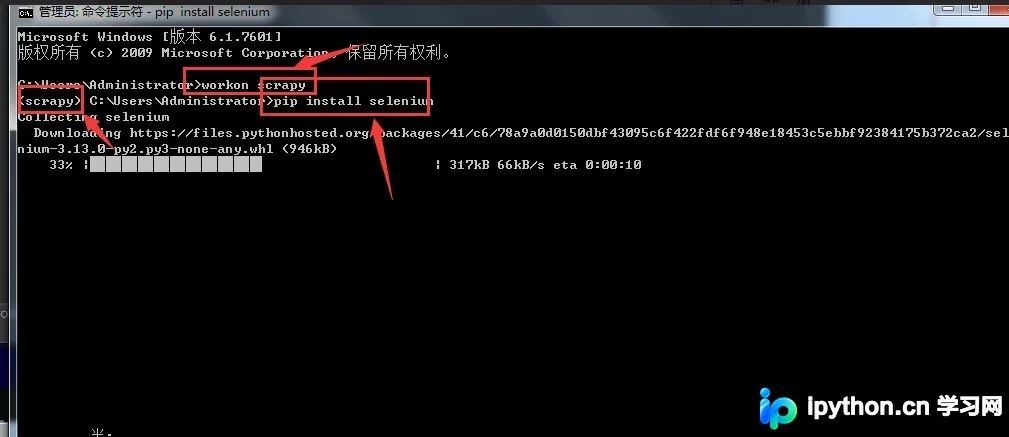
本文详解如何利用Scrapy框架结合Selenium解决动态网站数据抓取问题。通过自定义下载中间件,在Request阶段使用Selenium渲染JS并获取源码,直接返回Response对象,从而跳过默认Downloader。文章提供了middlewares.py和taobao.py的完整代码示例,并针对单爬虫与多爬虫场景下的Driver初始化策略进行了对比分析,帮助开发者高效实现动态内容抓取。
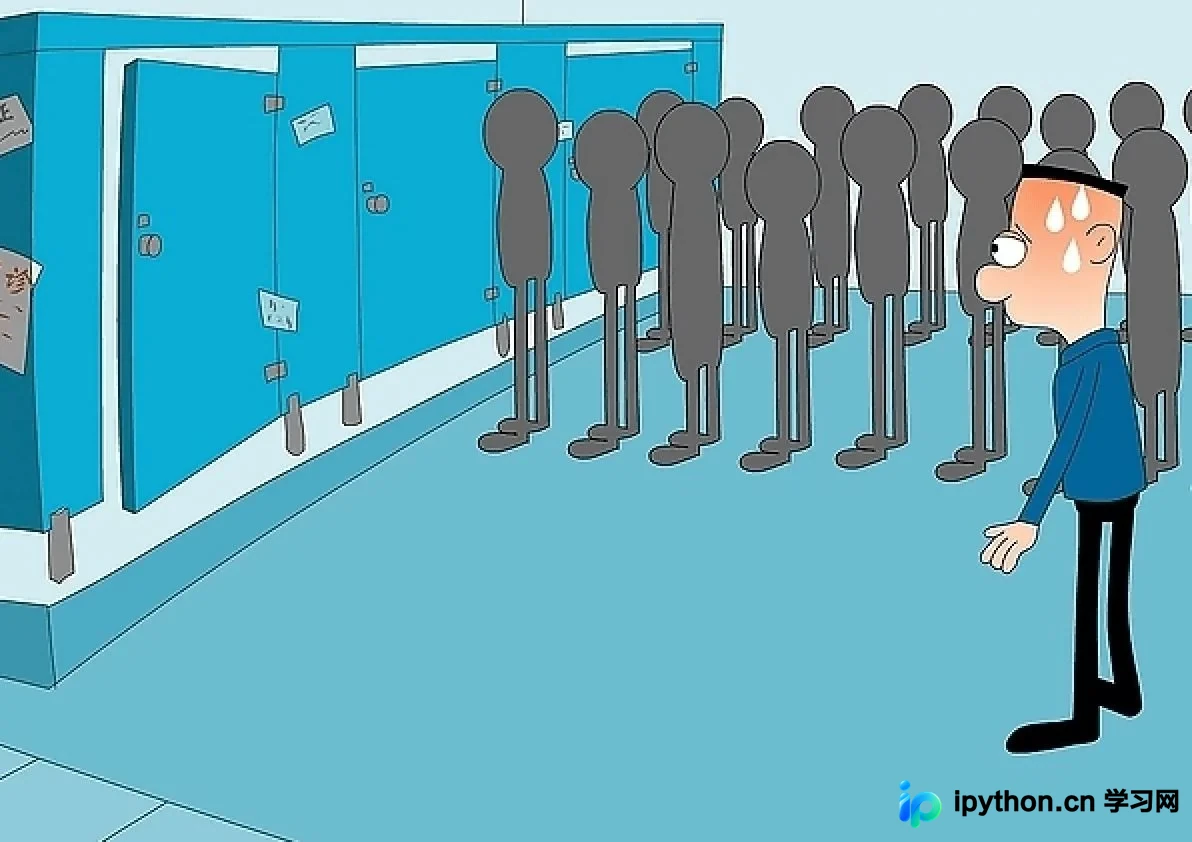
本文深入解析Python多线程编程中共享全局变量引发的数据竞争问题。通过引入互斥锁(Mutex)机制,确保多个线程安全访问共享资源。文章详细阐述了同步概念、互斥锁的工作原理及acquire/release方法的使用,并提供了完整的代码示例,展示如何正确使用上锁与解锁来保证数据一致性,同时强调了最小化锁范围以优化性能的最佳实践。
本文提供Python单向链表的完整代码示例,涵盖节点类Node与链表类SLinkList的定义。详细解析了头插、尾插、中间插入及节点删除等核心操作方法,并包含遍历输出功能。通过具体实例演示链表的构建与基本操作,帮助开发者掌握Python中链表数据结构的实现细节。
本文提供了基于何凯明博士理论的Python暗通道去雾算法完整实现,代码仅60余行且含详细注释。重点解析了计算密集的最小值滤波环节,指出纯Python实现的性能瓶颈,并建议通过C语言扩展或调用OpenCV的erode函数进行优化。文章附带运行效果对比,展示了从原图到去雾后图像的显著改善,适合希望快速掌握该算法原理及工程落地的开发者参考。
本文详细介绍Python中发送邮件的两种主流方法。首先讲解第三方库zmail的简易安装与使用,包括基础邮件发送;随后深入原生smtplib模块,演示如何配置SMTP服务器、构建邮件对象,并重点解析发送带附件邮件的完整代码逻辑与参数设置,帮助开发者快速掌握Python邮件自动化技能。
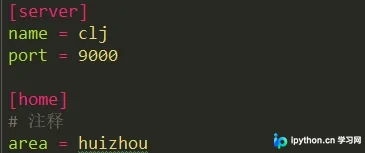
本文详细介绍Python中ConfigObj模块的使用方法。相比ConfigParser,ConfigObj操作更直观,支持以字典形式读写配置文件。内容涵盖安装、读取现有配置、修改值、增删条目、导出不同格式文件以及创建新配置文件等核心功能,帮助开发者简化运维配置管理。
本文详解Python中金额数字的人性化显示方法,解决浮点数精度及整数无小数位问题。介绍两种实现方案:基础代码处理与xToolkit库调用,并附带将数字转换为中文大写金额的完整脚本,帮助开发者实现符合阅读习惯的金额展示。
本文以Nameberry网站为例,详细演示使用Python抓取网页评论数据的完整流程。内容涵盖从分析网页结构、自动生成A-Z链接、处理分页逻辑,到解析HTML提取姓名、用户名、时间及评论内容的全过程。文中提供了基于requests和BeautifulSoup的核心代码片段,并强调了遵守爬虫协议及异常处理的重要性,帮助开发者掌握基础爬虫技巧。