

Python处理数据并导入Hive表的完整流程
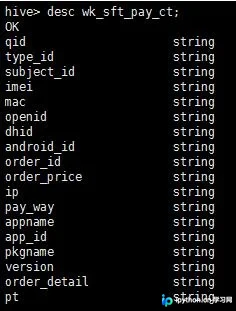
本文详细介绍如何利用Python将本地TXT文件中的数据清洗并导入Hive表。核心步骤包括:分析源数据与目标Hive表结构的差异,通过字段筛选与重排序实现结构对齐,处理JSON字段及空值,最后创建对应Hive表并使用LOAD DATA命令完成数据加载。
2026-10-13
19

本文详细介绍如何利用Python将本地TXT文件中的数据清洗并导入Hive表。核心步骤包括:分析源数据与目标Hive表结构的差异,通过字段筛选与重排序实现结构对齐,处理JSON字段及空值,最后创建对应Hive表并使用LOAD DATA命令完成数据加载。
本文介绍在Python中将mat文件转换为csv文件的两种常用方法。第一种利用h5py库直接读取HDF5格式数据并转为DataFrame;第二种通过scipy.io.loadmat加载结构体后提取数据。两种方案均使用pandas将结果保存为csv文件,适用于数据预处理及格式转换场景。
本文深入解析Django框架中的多表查询机制,重点阐述ForeignKey与ManyToManyField的使用。通过官方示例代码,详细说明外键约束、反向查询、自定义关联表及多对多关系的添加删除操作,帮助开发者掌握Django模型层的核心关联查询技巧。
本文介绍使用 pandas 将字典转换为 DataFrame 的方法。当字典值为标量时直接转换会引发 ValueError 错误,可通过指定 index 或将字典放入列表两种方式进行修正,确保数据正确生成表格结构。
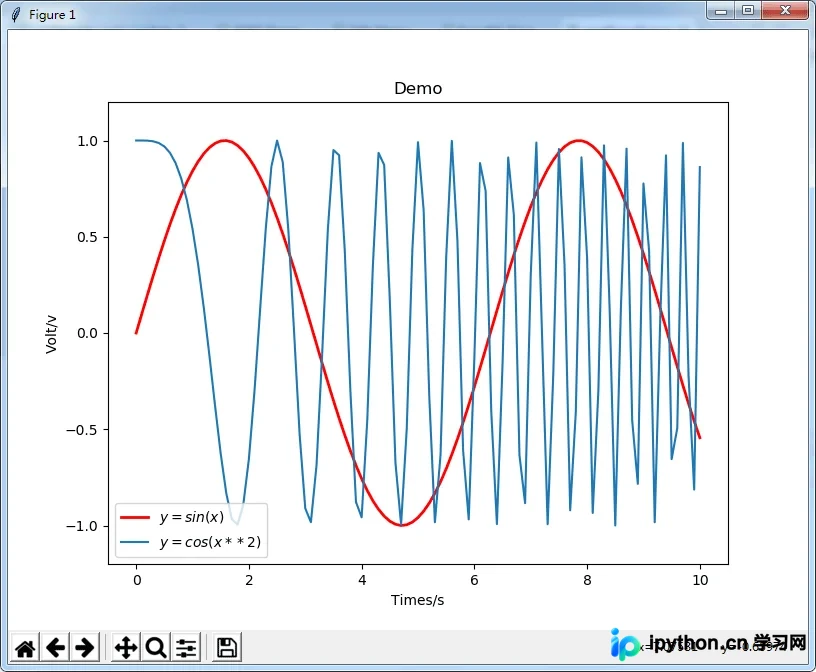
本文介绍Python中matplotlib库的基础绘图功能,详细解析plot函数的关键字参数如label、color及linewidth等用法,并深入讲解subplot函数如何划分绘图区域以绘制多轴图,帮助开发者掌握图表定制与布局技巧。
本文介绍如何利用Python pandas库中的DataFrame.corr()方法计算数据列间的相关系数。支持Pearson、Kendall Tau及Spearman秩相关三种算法,通过实际代码示例展示不同参数下的计算结果与输出格式,帮助开发者快速掌握数据相关性分析技巧。
本文详解Python Pandas库中DataFrame的drop函数,用于删除指定的行或列。通过axis参数控制删除方向(0为行,1为列),并解释inplace参数对原数据的影响。提供代码示例展示如何删除指定索引的行或特定列,帮助开发者高效处理数据。
本文介绍Django中利用母板页面实现代码复用的核心机制。通过{% block %}定义占位符,子页使用{% extends %}继承母板并填充具体HTML内容。文章提供base.html基础模板及两个具体继承页面的代码示例,展示如何统一导航样式并差异化显示主体内容,帮助开发者构建结构清晰的Web应用界面。
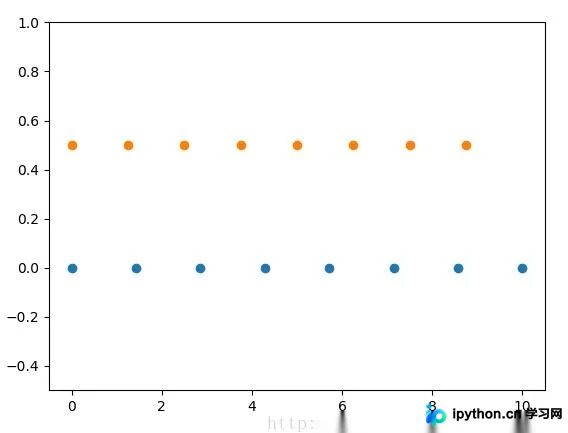
本文详细介绍Python中numpy库的linspace函数,用于生成指定数量的等差数列。重点解析start、stop、num、endpoint、retstep及dtype等核心参数的含义与默认值,并通过代码示例展示其用法。同时对比了arange函数通过步长生成数组的区别,帮助开发者根据需求选择合适的数组生成方式。
本文介绍在Python中统计列表元素出现次数的实现方式。通过集合去重后遍历,利用字典的update方法结合列表的count方法,构建包含元素及其频次的字典。该方法直观展示了Python基础数据结构的操作技巧,适合初学者参考学习。
本文介绍Python3中对List元素进行统一处理的两种常用方法:循环遍历与Map函数。通过代码示例展示具体实现,并对比50万数据量下的运行时间,结果显示Map函数效率更高,推荐在大数据量场景下使用。
本文详细介绍Python内置模块filecmp的使用方法,涵盖cmp函数进行单文件内容比对、cmpfiles函数批量比较指定文件以及dircmp类递归分析目录结构差异。通过具体代码示例,解析匹配、不匹配及错误文件的判定逻辑,帮助开发者高效实现文件同步与差异检测功能。