

Python 跨文件夹导入自定义包的正确配置方法
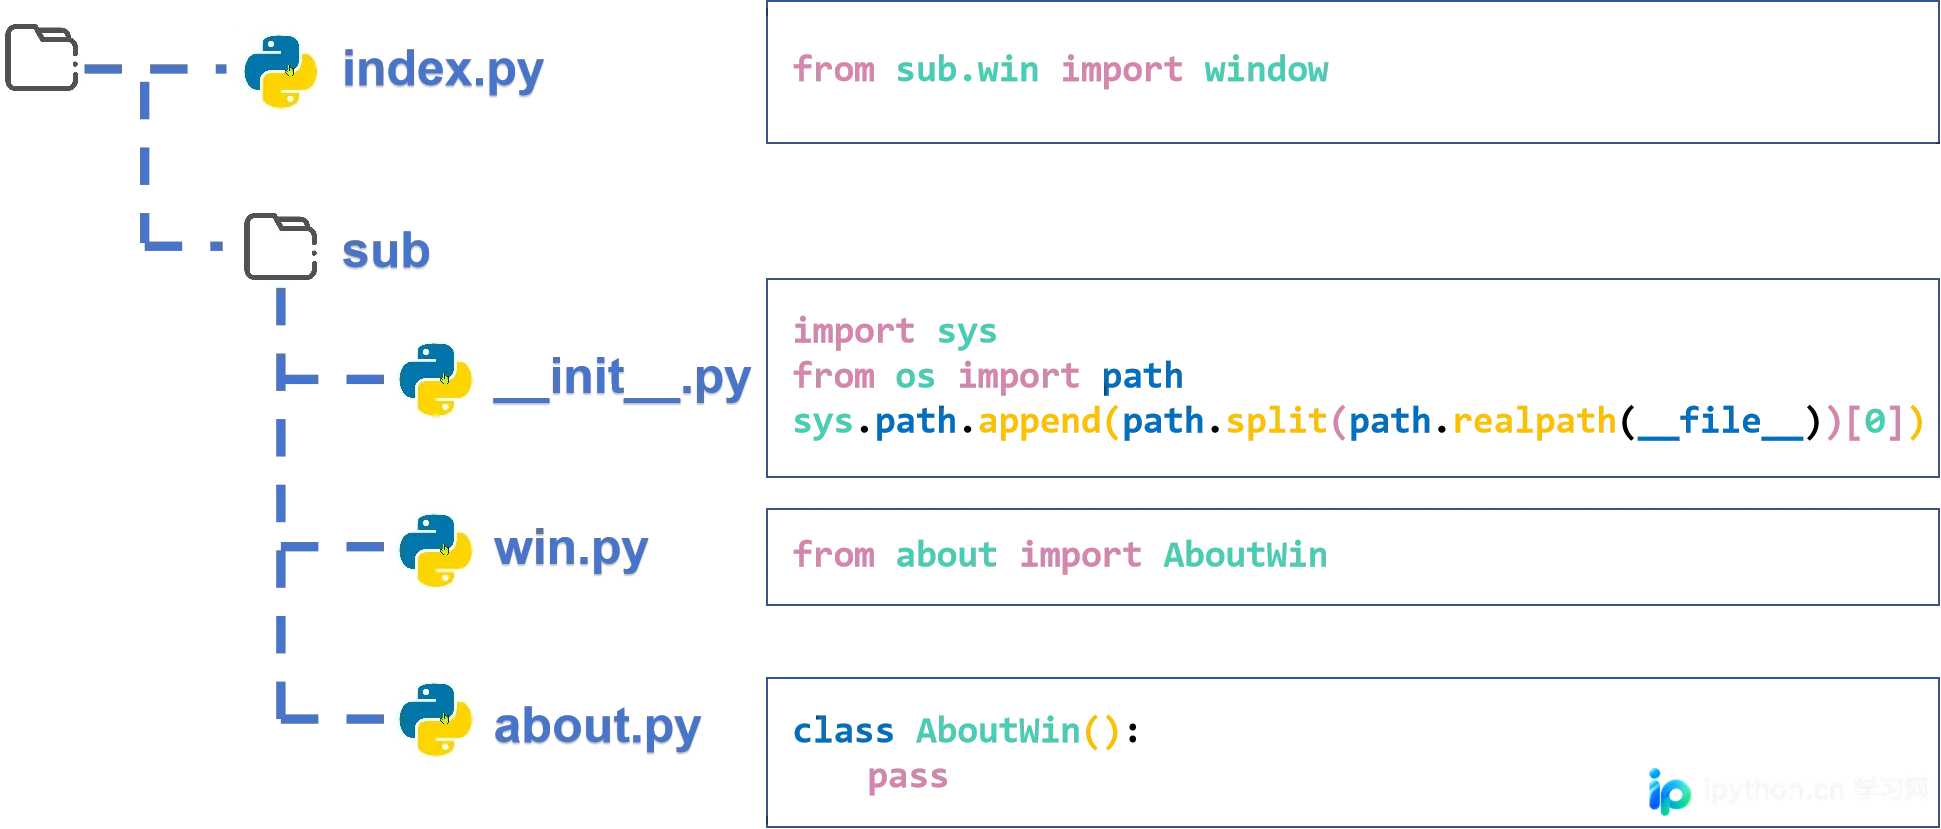
在 Python 项目中跨文件夹调用自定义模块时,常因解释器默认搜索路径不包含当前工程目录而触发 ModuleNotFoundError。本文通过规范包层级结构、在 __init__.py 中注入动态路径注册代码以及编写标准导入语法,提供一套可直接复用的修复流程,确保任意层级模块均能被正确解析。
2026-10-11
19

在 Python 项目中跨文件夹调用自定义模块时,常因解释器默认搜索路径不包含当前工程目录而触发 ModuleNotFoundError。本文通过规范包层级结构、在 __init__.py 中注入动态路径注册代码以及编写标准导入语法,提供一套可直接复用的修复流程,确保任意层级模块均能被正确解析。
针对网站频繁访问同一IP导致封禁的问题,本文详细说明如何通过requests库构建代理池、在HTTP请求中切换IP,并结合随机User-Agent、控制请求间隔与完善异常重试机制,有效提升Python数据采集任务的稳定性与存活率。
本文系统梳理Python日常开发中最常调用的10个内置函数,涵盖终端输出、数据长度统计、用户输入、序列生成、结构转换、极值查找、数值求和、绝对值计算、排序及类型检测等核心场景。通过标准参数说明与可运行代码示例,帮助开发者快速掌握高效编写Python脚本的基础工具。
本文提供Anaconda的完整安装与配置教程,涵盖官网及镜像下载、Windows系统下的详细安装步骤、环境变量配置方法,以及通过conda命令创建、激活和管理Python虚拟环境的实操指南,帮助用户高效解决多版本共存与依赖冲突问题。
本文详细讲解如何使用Python结合pycryptodome库进行AES加密。通过完整代码示例演示密钥配置、随机IV生成、PKCS7标准填充及CBC模式下的加解密流程,并对比说明cryptography库的用法,附带生产环境中的排错指南与安全规范。
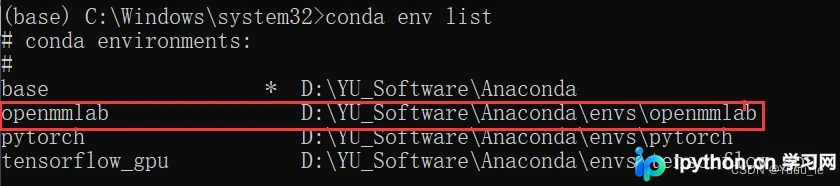
本文详细演示如何通过正确指令彻底删除Anaconda虚拟环境,解决传统命令导致的路径残留问题。文中包含标准清理步骤、结果验证方法及环境管理常用命令速查表,助您高效维护本地开发空间。
本文详解在单台Linux服务器上部署Python项目的完整流程。通过手动配置环境与Docker容器化两种主流方案,逐步涵盖虚拟环境创建、依赖包安装、代码上传、防火墙放行及进程守护。结合实际命令与状态检查标准,帮助开发者快速实现项目上线并保持服务稳定可用。
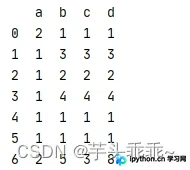
Pandas 提供的 drop_duplicates() 方法专为 DataFrame 数据去重设计。通过调整 subset 指定查重范围、keep 控制保留策略以及 inplace 决定修改方式,可灵活清理冗余记录。本文结合标准示例数据,逐步演示默认去重、全量剔除、单列或多列组合去重的完整操作逻辑,助力高效完成数据预处理。
本文详细对比Python标准库threading中Lock与RLock的核心差异。通过底层原理分析与实战代码,阐明Lock不记录线程所有权,而RLock支持同一线程多次安全加锁。附带完整操作流程与参数说明,助您在多线程同步场景中精准选型,彻底规避死锁风险。
使用 Python 批量合并多个 Excel 工作表或按固定行数拆分大型表格是日常数据处理的常见需求。本文通过 pandas 与 xlrd/xlwt 库提供两段可直接运行的核心代码,演示如何实现多文件纵向拼接生成新 xlsx 文件,以及如何将超长 xls 表格按指定行数切割并保留原表头。
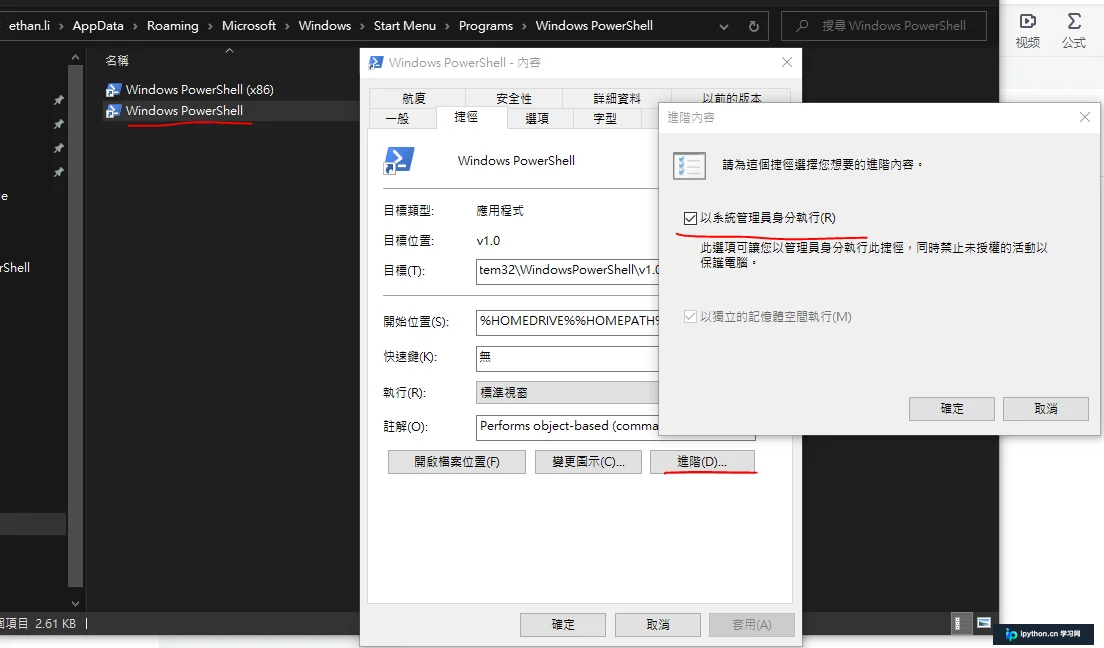
在配置本地Python或AI环境时,常遇到PyCharm终端执行conda激活时报错profile.ps1无法加载,或提示不含activate指令。本文通过修改PowerShell脚本执行策略、提升终端管理员权限及调整IDE配置,快速解决环境激活受阻问题。
讲解如何借助Python的theffuzz库解决名称拼写不一、格式混乱带来的字符串匹配难题。涵盖环境配置、fuzz模块四种核心相似度算法的适用场景,以及process模块在列表批量提取与自定义打分器中的应用,附完整可运行代码与性能优化建议。