Python读取Word指定位置表格及数据提取实战
本文介绍如何使用Python的python-docx库读取Word文档中指定位置的表格数据。通过定位特定文本段落后的表格元素,提取单元格内容并处理,适用于自动化办公场景。
2026-10-13
4


本文介绍如何使用Python的python-docx库读取Word文档中指定位置的表格数据。通过定位特定文本段落后的表格元素,提取单元格内容并处理,适用于自动化办公场景。
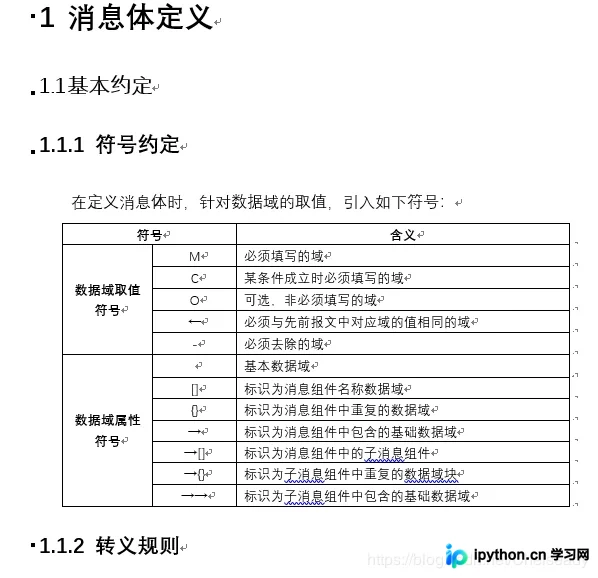
本文介绍如何利用Python的python-docx库处理Word文档,确保在内容替换或处理后,原有的格式、线段、图片、页眉页脚等元素保持不变。文章提供了从.doc转换为.docx的预处理方法,以及针对超链接处理的源码修改建议,帮助开发者在自动化文档处理中保留原始排版样式。
本文详细介绍如何利用Python解析HTML网页内容并生成Word文档。通过安装setuptools和python-docx组件,结合sgmllib与urllib获取数据,实现了从网页抓取到文档生成的自动化流程。文中提供了完整的代码示例及安装步骤,适用于需要批量处理网页数据并导出为Word格式的场景。
本文介绍如何利用Python脚本批量修复因硬盘格式化恢复后丢失名称的Word文件。通过安装python-docx库,程序读取文档第一段文字作为新文件名实现自动重命名。针对部分恢复的.doc格式文件,文中提供了转换为.docx格式的解决方案,并包含完整代码示例及注意事项,帮助用户高效处理大量文档。
本文对比了Python中生成Word和PDF的几种主流方案。针对Word导出,分析了unoconv对静态HTML的支持及其对异步数据和JS图表的局限,以及python-docx在格式控制上的不足。针对PDF导出,重点介绍了基于WebKit内核的pdfkit,指出其高保真度优势及对JS生成图表支持的缺失,并简要提及weasyprint等替代方案。
针对多人协作或模板制作中Word文档图片尺寸不一、排版杂乱的问题,本文介绍如何利用Python配合python-docx库实现一键批量调整指定尺寸并将所有图片统一居中对齐。通过厘米转EMU单位换算与XML层级遍历,提供可直接运行的脚本代码、参数配置说明及兼容性排错指南,帮助快速完成办公自动化流程。
本文详细介绍如何利用Python的python-docx库从Word文档中批量提取所有嵌入图片。涵盖环境准备、核心代码编写、安全保存逻辑及常见报错排查,并提供后续图像二次处理的扩展建议,助力开发者高效实现文档内容自动化抓取。
在使用 python-docx 进行 Word 文档自动化处理时,官方并未直接提供段落删除与完整样式复制接口,且默认行距限制常导致插入的图片显示不全。本文通过底层元素操作实现无残留段落移除,演示按属性迁移 Run 数据以保留字体样式,并提供修正行距规则与尺寸参数的完整代码,帮助开发者避开常见排版陷阱。
本文介绍如何使用Python的python-docx库,自动遍历指定目录下的特定后缀代码文件(如.cs),并将读取到的代码内容整理保存为Word文档。脚本支持处理中文编码,通过打印日志监控文件处理状态,确保生成包含标题、代码块及总行数的完整文档,适用于快速整理项目代码以申请专利或归档。
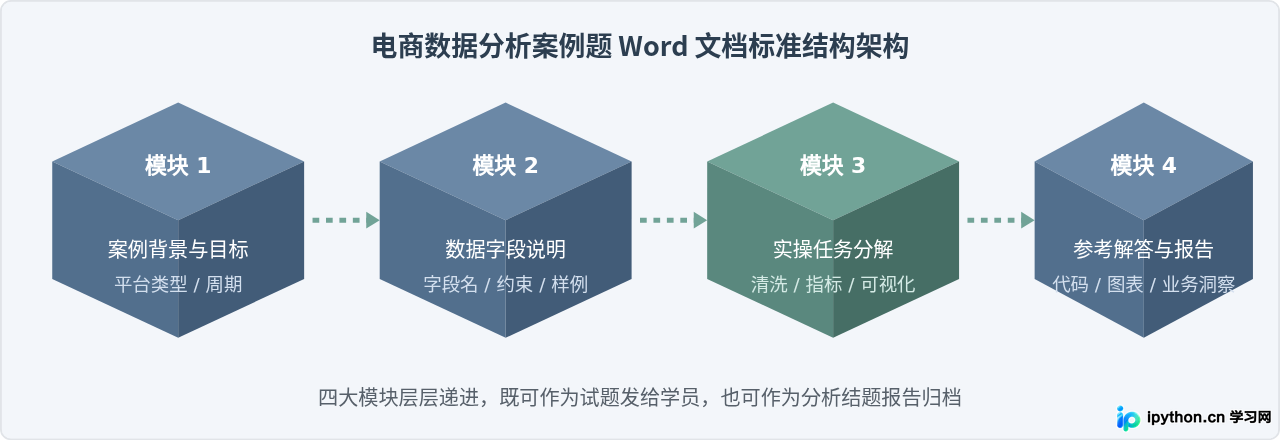
提供一份标准的Python电商销售数据分析案例题Word文档结构规范与生成示例,包含题目背景、数据字典、任务要求、解答代码及Word文档自动化导出方案。
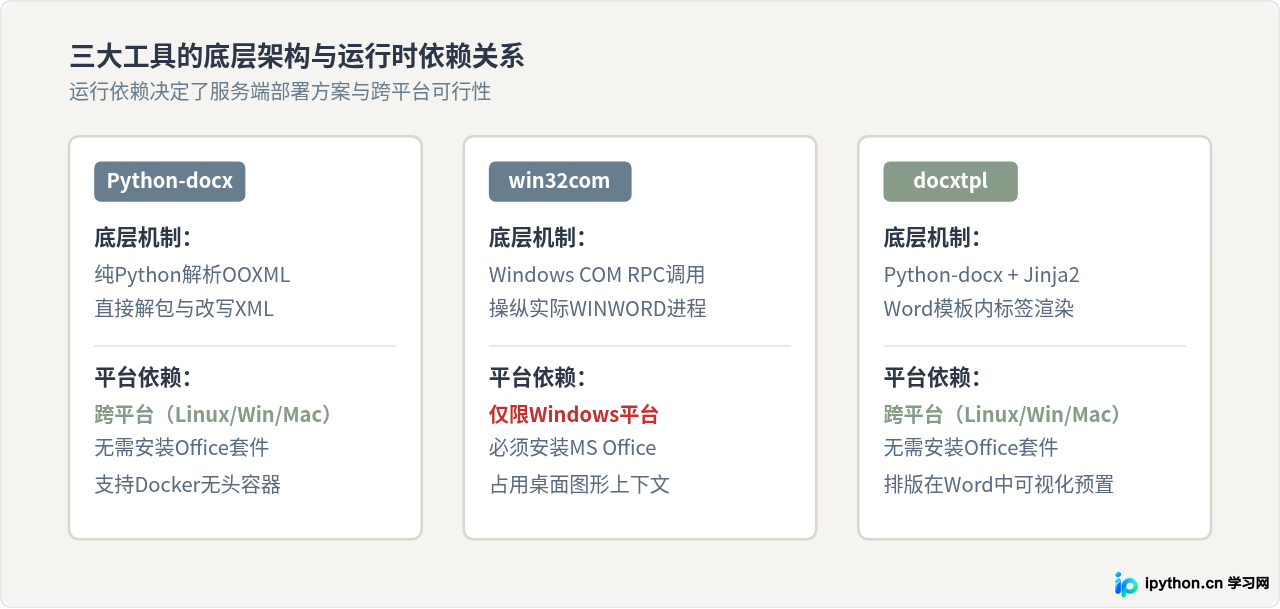
深入对比Python处理Word文档的三大主流方案python-docx、win32com与docxtpl,分析底层机制、核心功能、适用场景与局限性,帮助开发者根据实际业务需求做出最佳技术选型。
系统介绍如何使用Python-docx库创建和写入Word文档,包含文档层级结构、段落与Run样式控制、表格构建及常见报错排查等实用操作指南。