

Python-docx、win32com与docxtpl处理Word文件的适用场景对比

在Python自动化办公与文档工程开发中,处理Word文件有三套应用广泛的成熟工具:Python-docx、win32com与docxtpl。三者并非简单的替代品,而是立足于完全不同的技术架构,分别解决纯代码跨平台构建、宿主软件驱动与可视化模板渲染的核心诉求。选择不当往往会导致服务在Linux服务器崩溃、复杂排版严重跑样,或后台进程无故挂起。本文将系统剖析三者的底层原理、适用边界与性能表现,为具体项目选型提供明确可落地的决策参考。
一、底层原理与运行依赖差异
明确三种库在操作系统与运行时层面的依赖关系,是做技术选型的首要前提。很多团队在本地Windows测试成功后部署到Linux生产环境却直接报错,根源就在于底层依赖机制的根本差异。
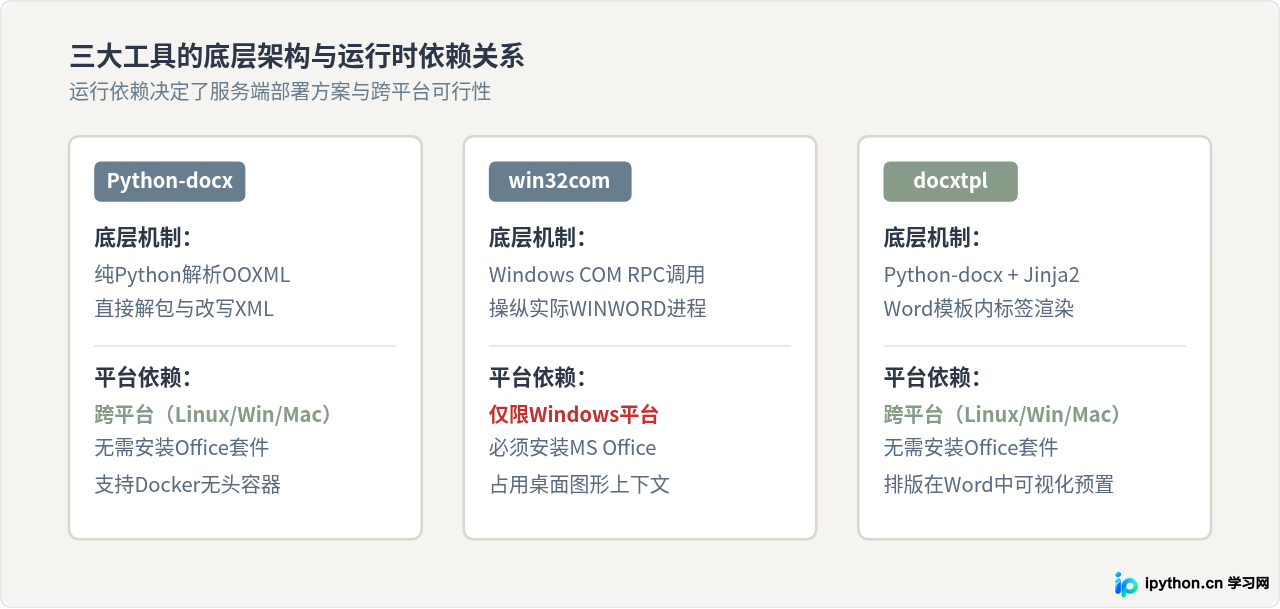
Python-docx 是一个完全用Python编写的纯原生库。现代Word文档(.docx)本质上是一个遵循OOXML(Open Office XML)标准的ZIP压缩包,内部包含了一系列描述文本、表格、样式和媒体关系的XML文件。Python-docx直接解包读取或重组这些XML文件,整个运行过程不需要操作系统预装Microsoft Office,也不依赖任何图形界面,天然支持Linux、macOS、Windows以及Docker容器环境。
win32com(即pywin32扩展包中的COM组件)的工作机制则截然不同。它并不直接读写文档的原始字节流,而是通过Windows系统的组件对象模型(COM)接口,唤起本机后台运行的Microsoft Word软件进程(WINWORD.EXE),并通过分发接口向Word发送指令来打开、修改或保存文档。因此,win32com的使用前提是运行平台必须为Windows,且机器上必须安装有正版Microsoft Office软件。
docxtpl(python-docx-template)则是一个建立在Python-docx基础之上的高级模板引擎库。它融合了Jinja2模板引擎的语法逻辑,将.docx文档内部的XML流视作模板文本,通过在Word中预先留出的占位符标签,把外部结构化数据动态插值渲染到文档中。它继承了Python-docx无需安装Office和完全跨平台的优势,但将繁重的排版工作前置到了Word可视化设计阶段。
二、Python-docx:轻量纯代码构建与解析
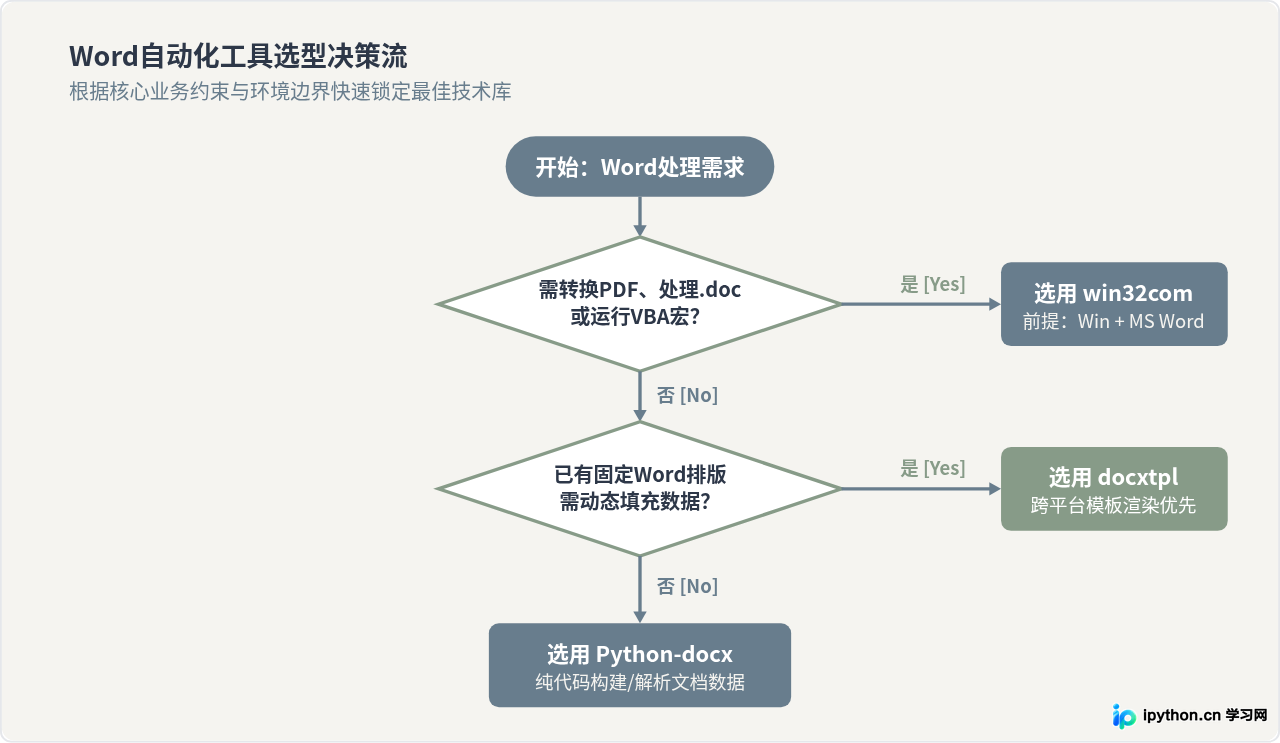
Python-docx最大的优势在于轻量与纯粹。如果你需要在服务器端后台从无到有生成一个标准化文档,或者需要批量读取成百上千份.docx文档提取其中的表格与段落数据,它是最干净利落的工具。
1. 典型应用场景
- 无图形界面的服务端运行:运行在Ubuntu、CentOS或Docker容器中的后端Web服务,需要批量生成基础数据报告。
- 文档结构化提取:需要解析现有Word文件,提取其中的标题层级、段落文本、表格行数据并写入数据库。
- 简单的流水线文本追加:按照特定规律批量拼装文本段落、插入基本表格和统一段落样式。
2. 操作步骤与代码示例
在任意安装了Python 3的环境中安装依赖并执行基础生成脚本:
# 依赖安装(终端执行)
pip install python-docx
以下代码演示从零创建一个包含标题、带样式段落和数据表格的Word文档:
# 文件名:demo_docx.py
from docx import Document
from docx.shared import Pt, Inches, RGBColor

# 1. 初始化文档对象
doc = Document()

# 2. 添加一级标题
doc.add_heading("系统运行每日简报", level=1)

# 3. 添加段落并控制文字块(Run)的细节格式
p = doc.add_paragraph("今日系统整体运行指标稳定,重点监控服务均无报警。")
run = p.add_run("(状态:正常)")
run.font.bold = True
run.font.color.rgb = RGBColor(0x34, 0x8A, 0x56)

# 4. 创建表格并逐行填充数据
table = doc.add_table(rows=1, cols=3)
table.style = "Table Grid"
hdr_cells = table.rows[0].cells
hdr_cells[0].text = "服务节点"
hdr_cells[1].text = "响应时长"
hdr_cells[2].text = "CPU占用率"

data = [
    ("API网关", "24ms", "18%"),
    ("数据库主库", "12ms", "42%"),
    ("缓存集群", "3ms", "15%")
]
for node, latency, cpu in data:
    row_cells = table.add_row().cells
    row_cells[0].text = node
    row_cells[1].text = latency
    row_cells[2].text = cpu

# 5. 保存文档
doc.save("daily_report.docx")Python-docx只认现代.docx格式,完全无法直接打开旧版二进制.doc文件;此外,由于不包含排版渲染引擎,它无法计算页面实际渲染后的总页数,更无法把文档导出为PDF格式。若要用代码维持一份极其复杂的带封面、复杂多级页眉页脚与特定对齐要求的排版,纯代码编写和维护成本极高。
三、docxtpl:复杂格式模板渲染的最优解
在实际企业业务中,合同、通知书、正式凭单等文件往往具备非常复杂的排版格式——包括公司抬头、页眉页脚、特定行距边距、图章预留位等。如果用纯代码逐行构建,工作量极其庞大且稍微改动版面就得重构代码。docxtpl正是为了化解这一痛点而生。
1. 典型应用场景
- 合同协议与确认书生成:非技术人员(行政或法务)在Word中做好版式设计,留出
{{ company_name }}、{{ contract_amount }}等占位符,开发人员只需提供字典数据即可完成渲染。 - 动态复杂表格报表:通过
{% for row in items %}标签在模板内部动态扩展表格行,自动继承模板单元格设定的背景色、边框与字体。 - 条件判断块动态呈现:通过
{% if has_discount %}灵活控制文档中特定条款段落的显示或隐藏。
2. 操作步骤与代码示例
docxtpl的使用分为两步:首先在Microsoft Word或WPS中制作好模板文件template.docx,随后通过Python脚本加载并渲染。
# 依赖安装(终端执行)
pip install docxtpl
在Word模板中录入带有Jinja2语法的文字后,执行如下Python脚本:
# 文件名:demo_docxtpl.py
from docxtpl import DocxTemplate

# 1. 载入预置好版式的Word模板文档
doc = DocxTemplate("contract_template.docx")

# 2. 准备业务结构化上下文数据
context = {
    "contract_no": "HT-2026-10-0901",
    "party_a": "上海未来数据技术有限公司",
    "party_b": "北京宏图智能科技有限公司",
    "signed_date": "2026年10月09日",
    "has_appendix": True,
    "products": [
        {"name": "企业级数据分析节点", "quantity": 4, "price": "12,000"},
        {"name": "实时流处理网关", "quantity": 2, "price": "28,000"}
    ],
    "total_amount": "104,000"
}

# 3. 渲染模板并将数据填充进XML占位符
doc.render(context)

# 4. 输出最终生成文件
doc.save("final_contract_2026.docx")在Word中编辑模板时,若反复修改、输入撤销或使用输入法,Word可能会把看似连贯的{{ variable }}切分成多个底层的<w:r>文本块,导致Jinja2解析标签失败。遇到此类语法解析报错时,可以在Word中将标签全部剪切并使用纯文本粘贴,或使用docxtpl提供的doc.patch_xml()机制排查。
四、win32com:原生Word能力调用与格式转换终结者
当业务需求超越了纯文件编辑,涉及文档渲染、页面计算、旧格式兼容或跨格式转换时,前两者都无能为力。此时,基于Windows宿主软件COM调用的win32com是唯一的原生解决方案。
1. 典型应用场景
- 批量无损将Word导出为PDF:只有真正的Word排版引擎才能完全精确地计算分页符、字体间距并生成与打印完全一致的高保真PDF。
- 旧版.doc格式批量升级:将历史遗留的二进制.doc格式批量转换为.docx以供后续自动化程序处理。
- 执行VBA宏与文档保护:运行文档内置的宏代码、执行复杂域(Field)更新、统计精确总页数。
2. 操作步骤与代码示例
注意:该方案仅在Windows环境有效,必须预先安装Microsoft Office并安装pywin32扩展。
# 依赖安装(Windows命令提示符)
pip install pywin32
使用win32com执行格式转换的标准健壮代码结构如下(务必使用try...finally确保后台进程退出):
# 文件名:demo_win32com.py
import os
import win32com.client as win32

def convert_docx_to_pdf(input_path, output_path):
    # 转换必须使用绝对路径,COM接口不识别相对路径
    abs_input = os.path.abspath(input_path)
    abs_output = os.path.abspath(output_path)

    word_app = None
    doc = None
    try:
        # 1. 启动Word后台进程
        word_app = win32.gencache.EnsureDispatch("Word.Application")
        # 2. 设置界面为不可见,关闭警告弹窗
        word_app.Visible = False
        word_app.DisplayAlerts = 0

        # 3. 打开目标文档
        doc = word_app.Documents.Open(abs_input)

        # 4. 导出为PDF格式(常量 17 代表 wdExportFormatPDF)
        wdExportFormatPDF = 17
        doc.ExportAsFixedFormat(abs_output, wdExportFormatPDF)
        print(f"成功导出PDF至: {abs_output}")

    except Exception as e:
        print(f"处理过程中出现异常: {e}")
        raise
    finally:
        # 5. 严格释放文档对象与进程,防止后台产生僵尸WINWORD.EXE
        if doc:
            doc.Close(SaveChanges=False)
        if word_app:
word_app.Quit()WINWORD.EXE最初是为桌面单用户交互设计的,并非服务端并发程序。如果将其置于高并发Web后台或多线程环境中,一旦某个文档损坏或弹窗挂起,后台进程堆积会导致服务器CPU和内存迅速耗尽。因此win32com适合单机离线批量任务或单线程顺序处理管道。
五、关键技术特性与适用边界对照
为了帮助读者在面临具体技术架构决策时能快速定位评估依据,我们将三大类库在平台跨度、环境依赖、排版灵活性、格式兼容性及执行性能等核心维度进行横向对比。
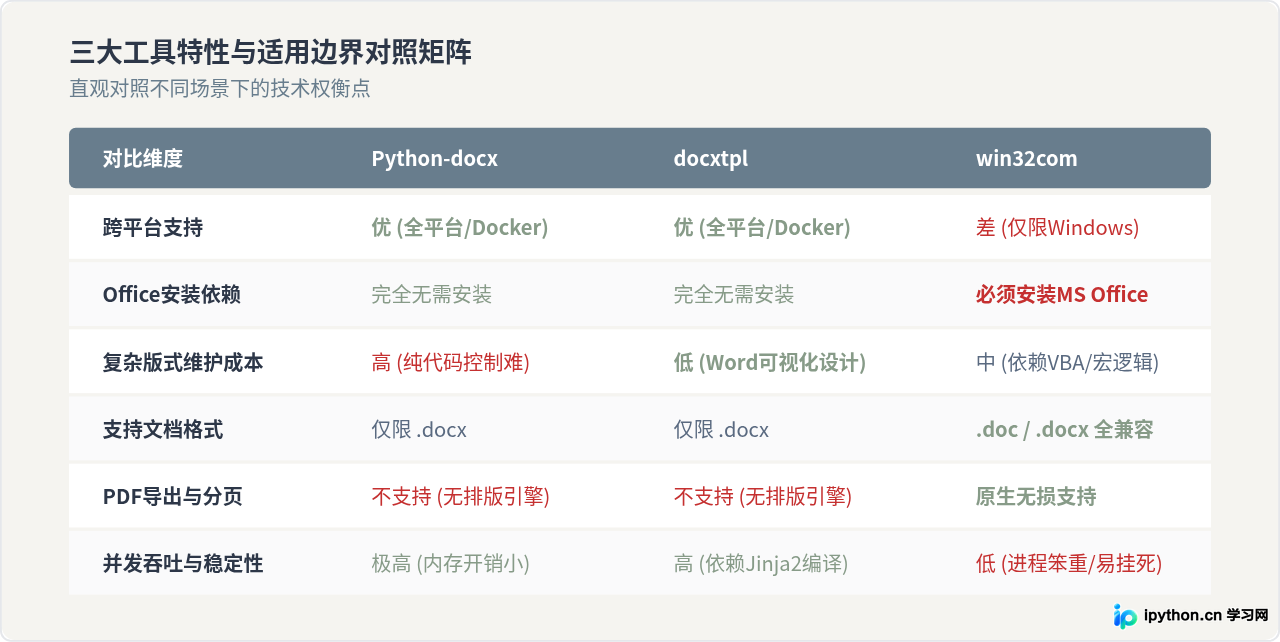
结合上述维度,可以清晰总结三者的核心差异及其背后原因:
- 开发与维护效率差异:面对合同、证明等固定版式文件,docxtpl将排版权交给设计人员,开发者仅需维护数据字典;而使用Python-docx则需要编写成百上千行代码去指定字体、边距和对齐方式,一旦甲方微调版式,代码修改极为繁琐。
- 系统部署与架构风险差异:Python-docx和docxtpl轻量可控,部署在容器云环境毫无压力;而win32com受限于Windows桌面环境的单进程特性,一旦引入到Web后端线程池中,极容易因文档受损、权限弹窗导致工作线程耗尽。
- 渲染真实性差异:只有win32com真正具备Word的排版引擎能力。若业务需要计算“第N页开始换章”或需要将Word文档100%原样输出为印刷级PDF,只有win32com能给出最可靠的排版结果。
六、生产环境中的组合流水线实践
在实际企业生产环境中,最优解往往不是单一类库的孤立使用,而是基于各自优势构建协作流水线。最经典的实践是:“docxtpl负责模板生成 + win32com(或无头LibreOffice)负责最终定稿转换”。
例如,在一套自动化合同出具系统中:
首先由商务或行政人员在桌面端设计好标准的contract_master.docx,并标注Jinja2插值标签;后端微服务接收到签约请求后,在Linux容器内使用docxtpl在毫秒级内完成数据注入与动态表格拼装,输出临时的.docx文件。随后,若用户需要下载无法篡改的PDF定稿,再将该文件推送到专用的转换节点(Windows下调用win32com,或Linux下调用无头LibreOffice命令行)完成高保真PDF转换。
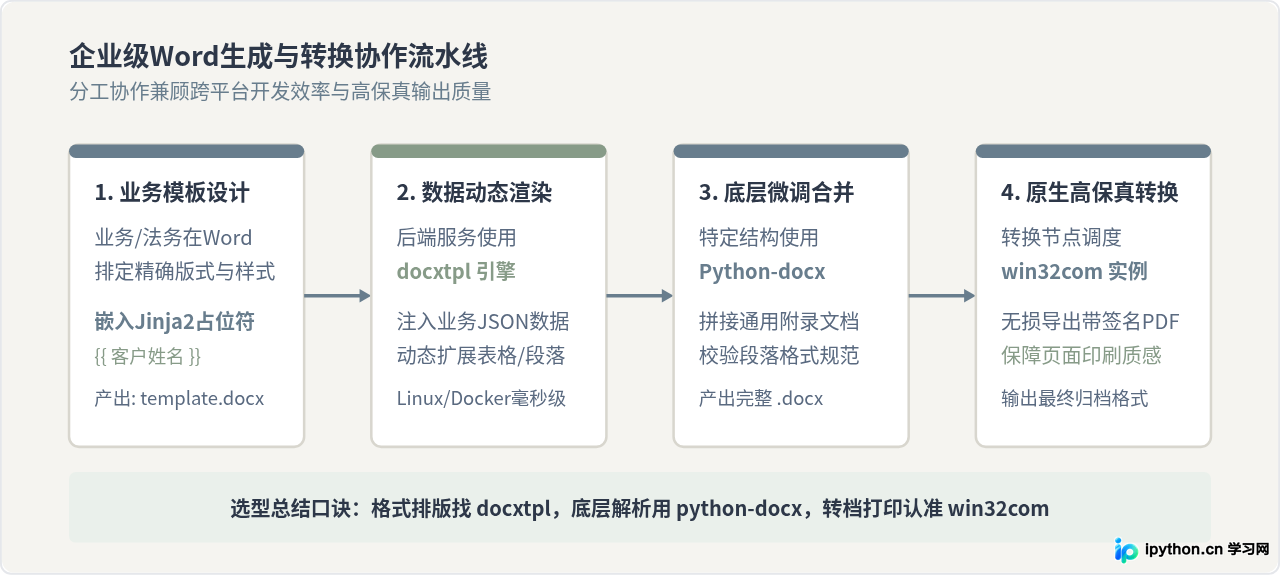
综上所述,三者各有其明确的立足点:日常数据提取与无模板服务端生成,首选 Python-docx;需要高度保持既有版式的合同、报表与凭证自动化,首选 docxtpl;而一旦涉及旧版格式兼容、宏运行以及对排版一致性要求极高的PDF转换,则必须借助 win32com。掌握三者的核心边界与配合方式,能够显著降低系统架构复杂度并提升自动化文档工程的稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









