

Python截取中文乱码怎么办?理解str与bytes的长度区别
针对Python截取中文字符串时出现的乱码、UnicodeDecodeError问题,深入解析str字符长度与bytes字节长度的区别,并提供按字符切片、安全按字节截断及网络封包处理的完整解决方案。
2026-10-10
3

针对Python截取中文字符串时出现的乱码、UnicodeDecodeError问题,深入解析str字符长度与bytes字节长度的区别,并提供按字符切片、安全按字节截断及网络封包处理的完整解决方案。
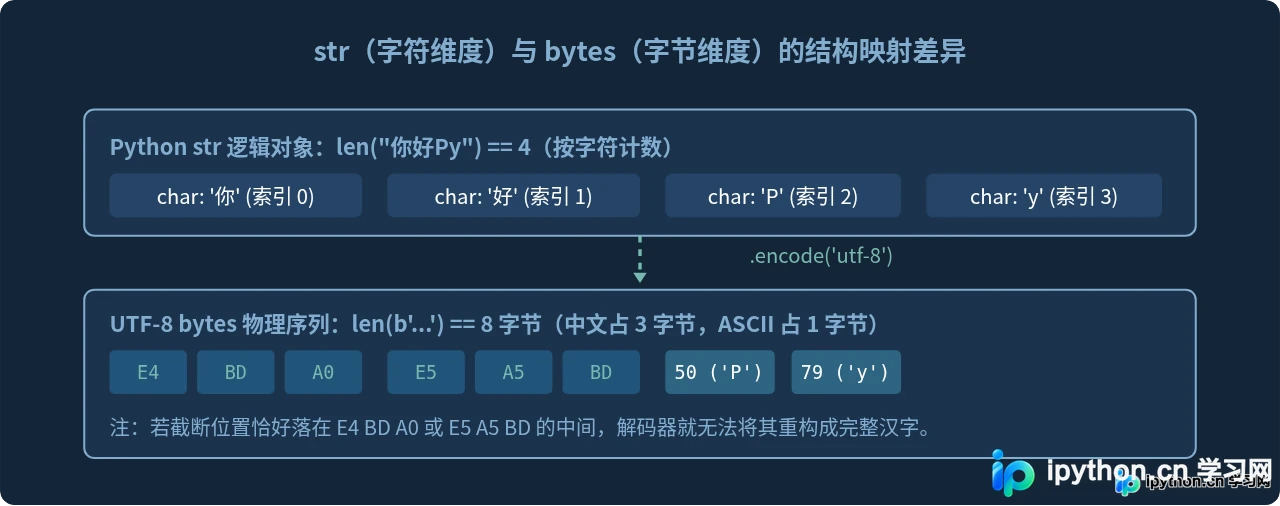
本文详解Python 3中bytes与str类型的区别及转换方法。通过示例展示如何创建bytes数据,分别使用UTF-8和GB2312编码字符串,并演示解码回字符串的过程。重点说明Python 3严格区分文本与二进制数据,禁止隐式混用,确保编码解码操作准确无误。
详细讲解Python 3中str与bytes的相互转换方法,剖析encode()与decode()在处理中文字符时的机制、UTF-8与GBK编码规则、错误处理策略及常见乱码报错排查。
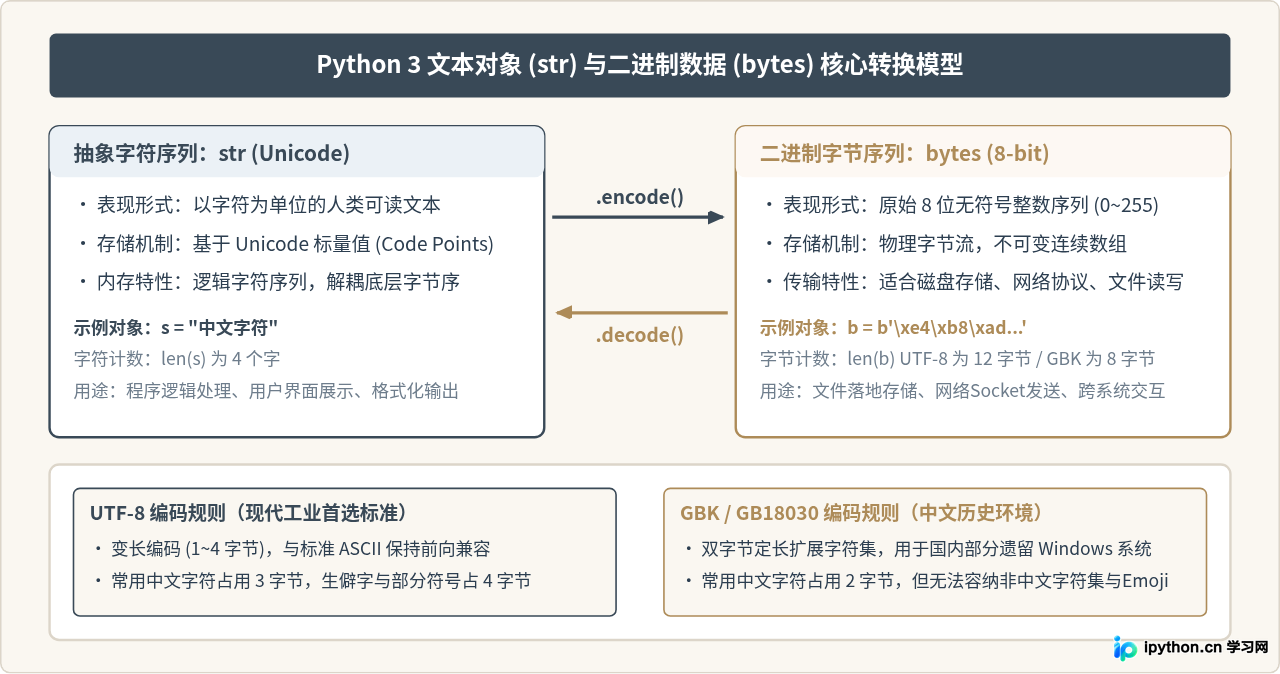
本文详解Python中str与bytes的区别、Unicode编码原理及UTF-8/BOM处理。涵盖字符串创建、编码转换、文件读写中的编码指定及常见字符串方法,帮助开发者正确处理文本数据。