Python实现两个有序数组中位数计算:算法与代码详解
本文介绍如何使用Python计算两个有序数组的中位数,重点讲解时间复杂度为O(log(m+n))的算法要求。通过示例演示了合并排序后的中位数提取逻辑,并提供了基于NumPy库的简洁实现方案及完整交互代码,帮助开发者快速掌握列表均值与中位数的处理方法。
2026-10-13
11

本文介绍如何使用Python计算两个有序数组的中位数,重点讲解时间复杂度为O(log(m+n))的算法要求。通过示例演示了合并排序后的中位数提取逻辑,并提供了基于NumPy库的简洁实现方案及完整交互代码,帮助开发者快速掌握列表均值与中位数的处理方法。
本文详细介绍Python中数据概括性度量的核心概念,涵盖集中趋势(众数、中位数、四分位数、平均数)与离散趋势(四分位差、极差、方差、标准差、离散系数)的计算方法,以及偏度与峰度的分布特征分析。结合Python3.5环境下的numpy和stats库代码示例,展示如何批量计算各项统计指标,为数据分析提供量化依据。
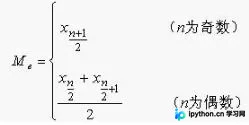
本文详细解析pandas.cut与pandas.qcut两个函数的参数与区别,涵盖等宽与等深分箱原理。针对信用风控建模中常见的qcut边界重复报错,提供设置duplicates='drop'的解决方案,并展示变量离散化及WOE计算的实际代码示例。
本文深入解析Python中函数嵌套运行的核心机制,重点阐述局部变量与全局变量的作用域区别。通过代码示例演示如何使用global关键字修改全局变量,并探讨嵌套函数与闭包的关联特性,帮助开发者理解多函数共同运行时的变量访问规则。
本文介绍如何使用Python的openpyxl库将Excel文件中的Sheet1数据完整复制到新表的Sheet1中。涵盖测试环境配置、.xlsx与.xls格式处理差异,并提供完整代码示例,包括工作簿加载、单元格遍历赋值及保存关闭操作,适用于Python 3.7及以上版本。
本文提供基于Python的简易购物车程序实现方案。程序支持用户输入工资、浏览商品列表、根据编号选购商品,并实时检测余额是否充足。若余额不足则提示,支持随时退出并打印已购商品及剩余金额。代码包含完整的商品数据定义、购物逻辑判断及退出机制,适合Python初学者理解列表操作、条件判断与循环结构。
本文详细介绍Python中uuid模块的四种生成方法(uuid1、uuid3、uuid4、uuid5)的区别与应用场景,重点解析基于时间戳、随机数及哈希算法的生成原理。同时提供去除UUID中连字符'-'的实用代码示例,帮助开发者在数据库主键或唯一标识处理中更高效地使用UUID。
本文详解利用Python计算KS(Kolmogorov-Smirnov)指标的三种主要方法:基于pandas.crosstab、sklearn.roc_curve以及scipy.stats.ks_2samp。重点分析当数据包含NaN值时各方法的差异,指出直接调用内置函数可能因排序机制导致误差或报错,并提供提前清洗数据或使用自定义累积分布计算的正确解决方案,确保风控模型评估的准确性。
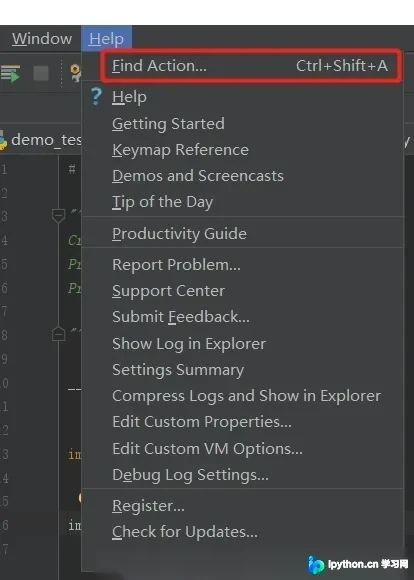
PyCharm 运行程序时提示 Out of Memory 错误,通常因默认分配的 1024M 内存不足导致。本文介绍两种修改 pycharm.exe.vmoptions 配置文件的方法:通过 Help 菜单直接编辑或手动修改安装目录文件,将 -Xmx 参数调整为更大值(如 2048m)以解决内存溢出问题。
本文介绍了在Python中生成大写32位UUID的方法,通过uuid模块生成标准UUID并去除连字符后转换为大写。同时补充了生成32位纯数字随机数的思路,涉及随机数生成与字符串拼接操作,提供相关代码参考。
本文通过Python代码示例,演示如何构建一个简易的快递价格查询系统。内容涵盖利用条件判断语句处理不同地区(如东三省、新疆等)及重量区间的计费逻辑,结合死循环实现持续交互。文章提供了两段不同实现的源码,分别展示了基于首重与续重计算的逻辑以及模块化函数设计的思路,适合Python初学者理解基础语法在实际场景中的应用。
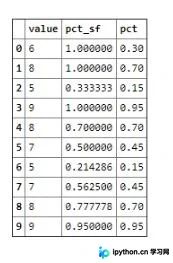
本文介绍利用Python中的numpy.percentile和pandas.cut函数,通过计算数据百分位数实现等频数据分箱的方法。文章提供了生成随机数据、确定分位点、自定义标签及统计结果的完整代码示例,并补充了动态时点与静态时点百分位数的计算逻辑,适用于需要按分布比例划分数据区间的场景。