6个高效Pandas数据处理技巧:从缺失值到列重排
本文总结了6个常用的Pandas数据处理技巧,帮助开发者高效处理数据。内容涵盖快速定位含缺失值的行、根据条件替换列值、使用pd.cut进行数据分箱统计、利用split拆分文本列、通过正则表达式筛选中文字段,以及调整列顺序的两种方法。掌握这些代码片段能显著提升数据清洗与处理的效率。
2026-10-16
6

本文总结了6个常用的Pandas数据处理技巧,帮助开发者高效处理数据。内容涵盖快速定位含缺失值的行、根据条件替换列值、使用pd.cut进行数据分箱统计、利用split拆分文本列、通过正则表达式筛选中文字段,以及调整列顺序的两种方法。掌握这些代码片段能显著提升数据清洗与处理的效率。
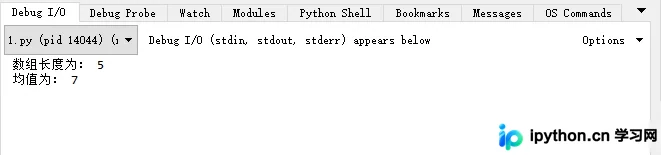
本文介绍在Python环境中如何计算数组元素的累加值与平均值。通过Python 2.7.12及Wing IDE环境,展示了使用内置sum函数与手动循环两种方式的实现代码,旨在为开发者提供基础的数组处理参考。
本文详细介绍在Python中计算1到100累加和的三种实现方式。通过for循环、while循环以及内置函数sum与reduce的组合应用,展示不同场景下的代码写法。内容涵盖基础语法示例及结果输出,帮助初学者理解循环结构与数值计算逻辑。
本文详解Python中利用scipy和h5py库读取及保存MATLAB .mat数据的方法。重点解决savemat需传入字典格式的问题,并深入分析uint8数据在Python与Matlab运算中的溢出差异。通过对比int8与float类型转换结果,推荐在涉及图像加减运算时使用float格式以保证精度,避免数据错误。
本文详细解析Python解决三数之和问题的核心思路,采用排序结合双指针策略。文章对比了基础实现与修正后代码,重点指出并修复了循环边界、重复元素跳过逻辑及提前终止条件等常见错误,提供了完整的可运行代码与性能测试结果,帮助开发者掌握高效解题技巧。
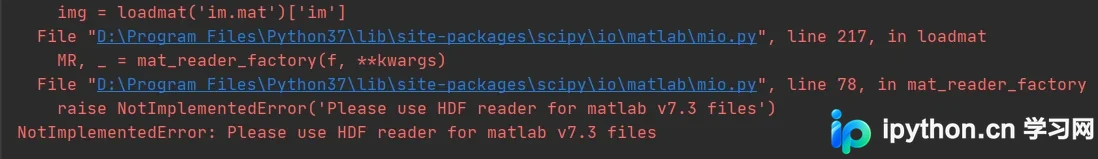
本文总结了Python中读取.mat文件的三种主流方式:scipy、h5py和mat73。针对matlab v7.3版本文件,scipy会抛出异常,需改用h5py,但调试不便。推荐mat73库,因其兼容性好且返回字典格式,便于提取数据。文章还包含从ITC_VD数据集读取标签及将矩阵转为图片的实战代码示例。
本文介绍Python中向JSON文件追加数据的两种实现方式。第一种方法通过List Dump将JSON转换为列表后追加,但会改变原始结构,不推荐使用;第二种方法利用Dict Update直接更新字典对象,操作简洁高效,是推荐的最佳实践。文章详细对比了两种方法的步骤与优缺点,帮助开发者选择合适的数据处理方案。
本文介绍如何使用Python和百度PaddleHub库,通过20行代码实现基于DeepLabv3+模型的人像批量抠图。无需复杂训练,直接加载预训练模型即可处理任意尺寸图片,适用于背景清晰的人像处理场景,虽在色彩相近背景下存在局限,但整体效率与效果显著优于手动操作。
本文介绍Python中设置步长的多种方法。重点讲解List切片语法nums[a:b:c]中c参数的作用,以及range(a,b,c)在Python2与3中的区别。针对小数步长需求,详细演示如何使用numpy模块的arange函数(含精度控制)和linspace函数实现等分生成,并提供完整代码示例。
本文介绍利用Python批量修改文件名的多种场景。涵盖基础批量重命名、解决os.listdir乱序问题的排序方法、使用正则表达式批量删除指定字符,以及结合Excel数据按姓名学号匹配修改图片名。通过具体代码示例,展示如何高效整理大量文件。
本文介绍在Pandas DataFrame计算中产生inf(无穷大)值的原因及处理方法。通过Numpy库提供的isinf、isposinf等函数定位inf位置,并演示如何将Series或整个DataFrame中的正负无穷大替换为指定数值或NaN,以适配机器学习算法对数据完整性的要求。
本文深入讲解Python核心基础,涵盖函数的定义与调用、模块的使用,以及面向对象编程中的类、实例对象、构造与析构方法、封装及继承机制。通过具体代码示例,帮助初学者掌握Python编程的关键概念,为后续开发打下坚实基础。