

Python 20行代码实现批量抠图:基于PaddleHub DeepLabv3+实战

本文介绍如何使用Python和百度PaddleHub库,通过20行代码实现基于DeepLabv3+模型的人像批量抠图。无需复杂训练,直接加载预训练模型即可处理任意尺寸图片,适用于背景清晰的人像处理场景,虽在色彩相近背景下存在局限,但整体效率与效果显著优于手动操作。
前言
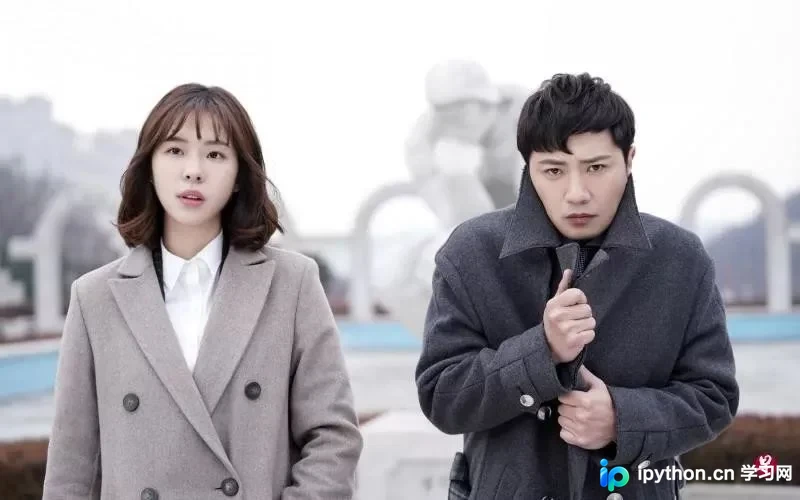
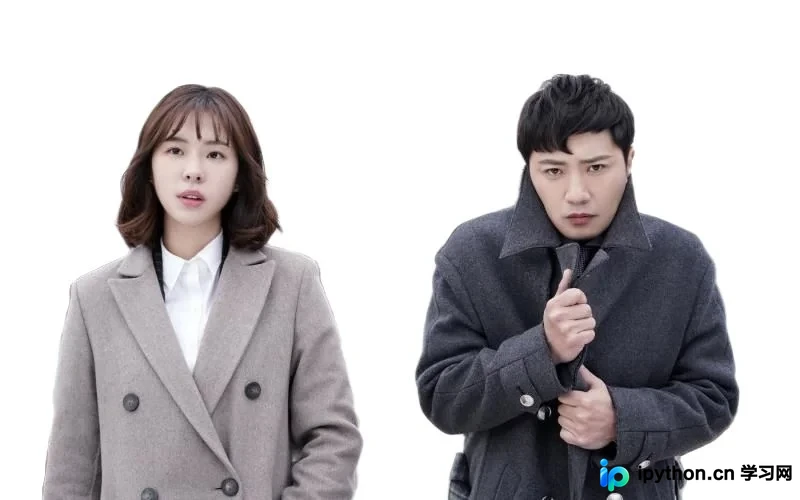
抠图前 vs Python自动抠图后
在日常工作与生活中,图像抠取是常见需求。即便仅处理单张图片,繁琐的手动操作也易引发疲劳;若面对大量图片需进行抠图,处理效率与耐心将面临更大挑战。
利用Python工具可有效简化这一流程:针对单张高精度人像抠图,可显著减少操作步骤;针对批量图片处理,虽自动生成的轮廓细节可能不如人工精细,但已能满足大多数基础应用需求。
DeepLabv3+作为谷歌DeepLab语义分割系列的最新成果,支持任意尺寸图片输入的人像分割任务。手动实现该模型复杂度极高,但百度PaddleHub已封装好该模型,用户只需加载模型即可直接对图像进行分割处理。
1.准备
执行本实验需依赖Python环境。若尚未安装,请参考相关指南完成Python环境的配置与安装。
随后需安装百度PaddlePaddle框架,可访问其官方网站获取详细的安装指引。
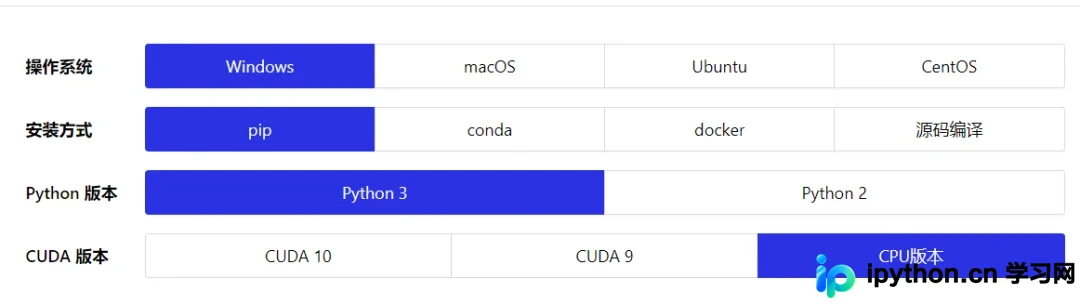
根据实际环境选择安装选项。由于本实验不涉及数据训练且计算量较小,直接选择CPU版本即可。安装界面提供了清晰的指引,配置过程相对便捷。
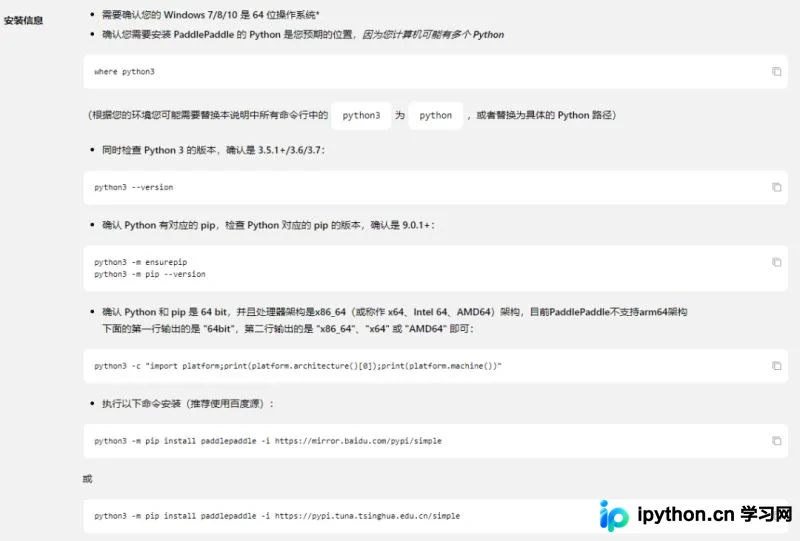
注意:若Python3环境变量中的可执行文件名为python而非python3,需将安装命令中的python3替换为python,具体安装命令如下:
python -m pip install paddlepaddle -i https://mirror.baidu.com/pypi/simple
2.编写代码
整个实现流程包含三个核心步骤:
第一步:加载预训练模型。
第二步:指定待处理图片所在的目录路径。
第三步:执行抠图操作。
import os
import sys
import paddlehub as hub

# 1.加载模型
humanseg = hub.Module(name="deeplabv3p_xception65_humanseg")

# 2.指定待抠图图片目录
path = './source/'
files = []
dirs = os.listdir(path)
for diretion in dirs:
    files.append(path + diretion)

# 3.抠图
results = humanseg.segmentation(data={"image": files})

for result in results:
    print(result['origin'])
    print(result['processed'])
全程仅需20行代码。处理完成后,本地文件夹中将自动生成名为humanseg_output的目录,其中存放所有已成功抠图的图片文件。
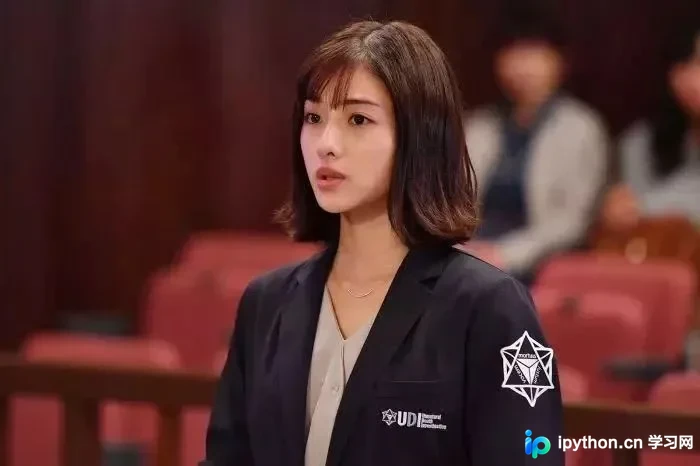
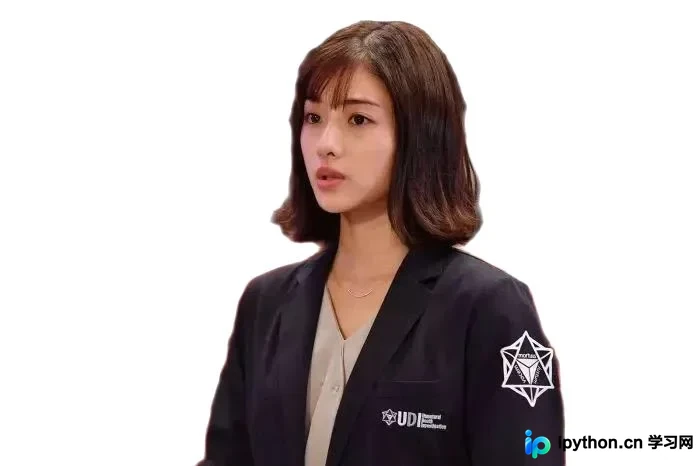
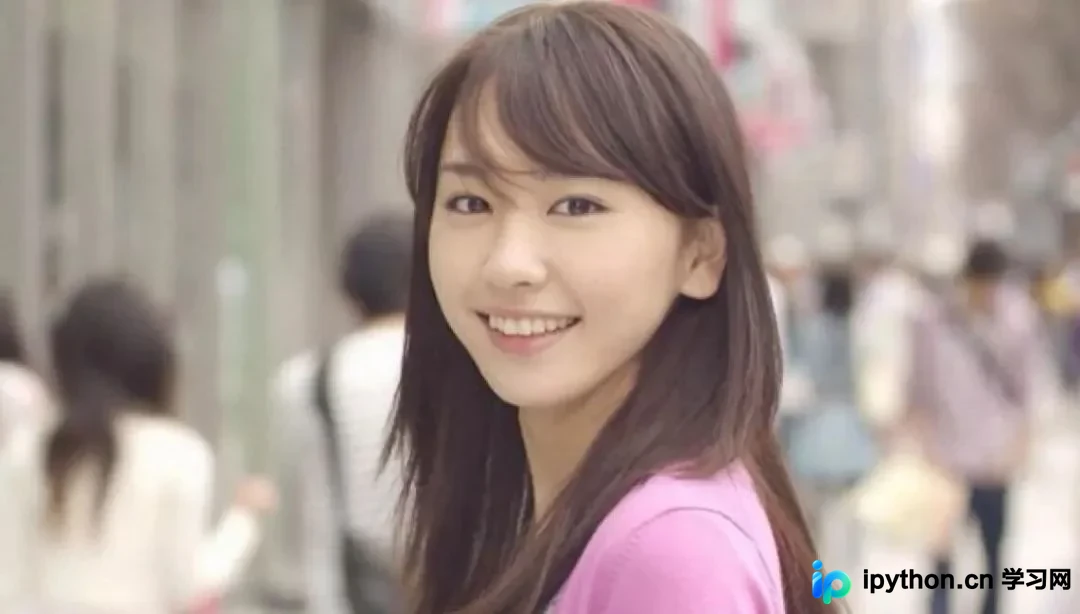
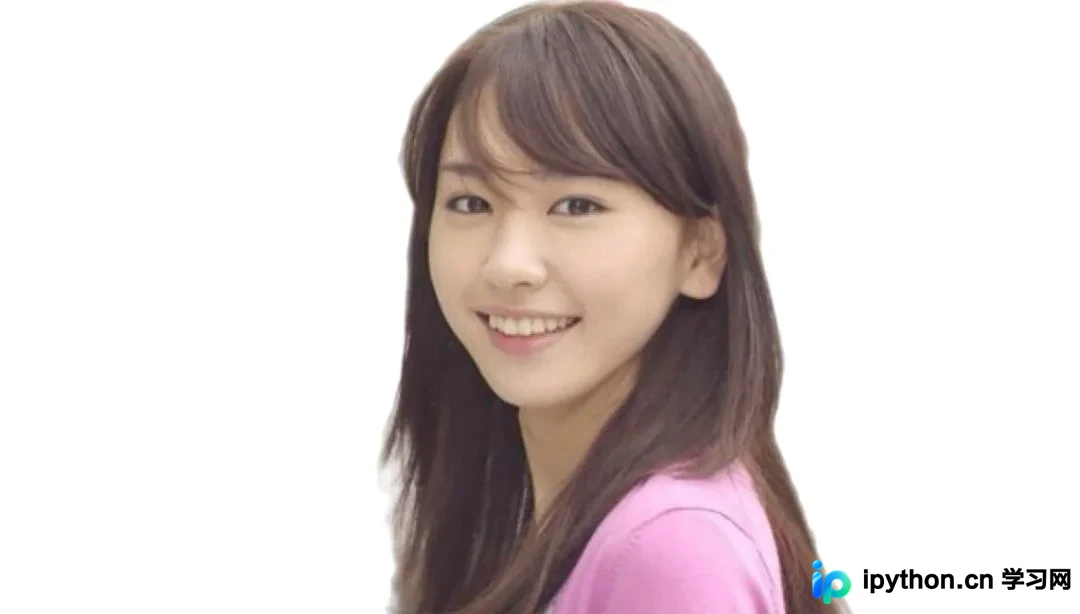
素材获取地址
3.结果分析
谷歌的算法表现确实出色。在背景较为简单的情况下,自动抠图的细节保留程度可与手动抠图媲美,甚至在某些方面优于人工处理。
然而,当人物与背景颜色相近时,算法可能出现识别偏差,例如出现以下处理结果:
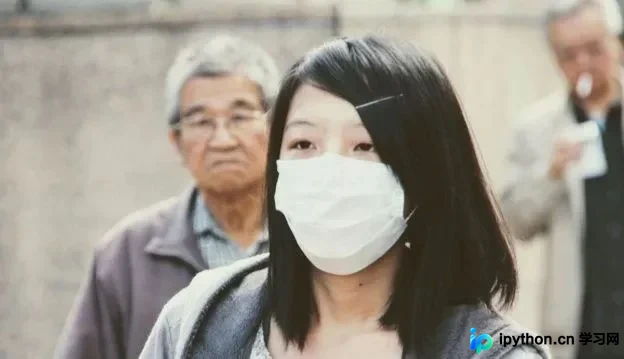
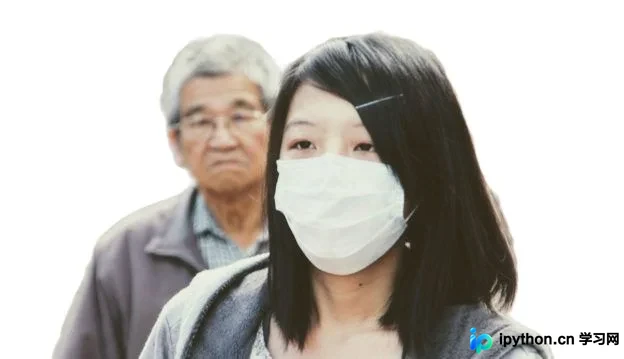
如示例所示,背景中的人物可能被完全忽略(此处为幽默表述)。尽管如此,该模型仍是目前所见最强的自动抠图模型之一。
至此,关于使用Python 20行代码实现批量抠图功能的介绍完毕。如需了解更多Python批量处理相关内容,可查阅本站历史文章或继续关注后续更新,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









