

Python Scrapy数据持久化实战:从文件到MySQL的配置详解
本文详解Python Scrapy框架中项目数据的持久化处理方案。针对抓取数据需后期分析的需求,重点介绍如何将默认的文件存储切换至MySQL数据库。通过修改settings.py配置文件,启用SavetoMySQLPipeline并配置数据库连接参数,实现高效的数据存储与管理,避免文件散乱带来的检索难题。
2026-10-14
7

本文详解Python Scrapy框架中项目数据的持久化处理方案。针对抓取数据需后期分析的需求,重点介绍如何将默认的文件存储切换至MySQL数据库。通过修改settings.py配置文件,启用SavetoMySQLPipeline并配置数据库连接参数,实现高效的数据存储与管理,避免文件散乱带来的检索难题。
本文深入解析Python中的动态规划算法,通过斐波那契数列和爬楼梯两个经典案例,展示从暴力递归到空间优化的完整思路。详细讲解如何识别重叠子问题,利用数组或常数变量存储中间状态,从而显著提升算法效率,适用于LeetCode等编程实战场景。
本文详解如何利用Python爬虫技术处理招聘数据。重点讲解如何校正拉勾网与Boss直聘的工作年限描述差异,建立统一的等级标准,并建议舍弃“经验不限”数据以保证统计准确性。同时提供基于PIL库的图片批量筛选代码实例,帮助开发者提升数据处理效率。
本文介绍了一个基于Python编写的简单脚本,用于检测特定关键词在百度搜索引擎中的网站排名。通过模拟HTTP请求获取搜索结果页面,并利用正则表达式解析HTML内容,脚本能够筛选出目标域名在搜索结果中的位置。文章提供了完整的源代码及命令行使用示例,适用于需要快速验证SEO效果的技术人员。
本文介绍如何使用Python和OpenCV库将多张图片序列合成为视频文件。核心步骤包括读取图片、创建VideoWriter对象并写入帧。重点解决中文路径无法读取及路径格式错误等常见问题,提供完整代码示例与参数说明,适用于制作演示动画或视频序列处理。
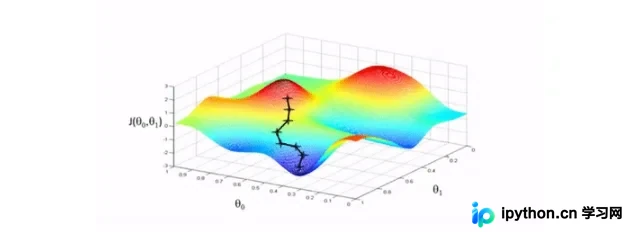
本文深入解析神经网络中的反向传播算法,阐述其通过计算成本函数对权重和偏置的偏导数来优化模型的核心原理。结合Python代码示例,详细演示Sigmoid与ReLU激活函数的导数计算,并提供完整的BP算法实现案例,帮助开发者掌握深度学习的基础训练机制。
本文梳理Python全栈开发所需的核心语法,涵盖中文编码、数值类型、HTML标签优化及变量命名规范。重点详解%s、%d与f-string格式化输出技巧,并通过实际代码示例演示输入处理与特殊字符转义,帮助开发者掌握独立开发所需的基础编程技能。
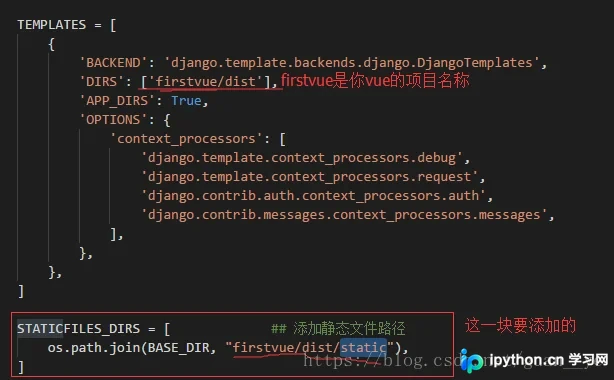
本文详细解析如何将Django后端与Vue前端进行整合。从环境配置、项目创建到打包部署,涵盖Node.js安装、Vue CLI使用、Webpack构建以及Django静态文件配置等关键步骤,帮助开发者实现前后端分离架构的无缝对接。
本文详解Python实现动态爱心表白的多种方法。从基础的turtle库绘制静态心形入手,解析由数学公式生成的一行代码技巧,并进一步改造为支持自定义文字的动态输出效果。教程包含完整代码示例与运行逻辑拆解,帮助开发者快速掌握Python图形编程与字符串处理技巧。
本文深入解析Python Eventlet库的绿化(Greening)机制,阐述其如何利用select/epoll等系统调用将阻塞I/O转换为非阻塞。重点对比了直接import、eventlet.import_patched以及eventlet.monkey_patch三种引入方式的区别,特别是后者对sys.modules的全局修改行为及支持模块的限制,帮助开发者正确选择绿化策略。
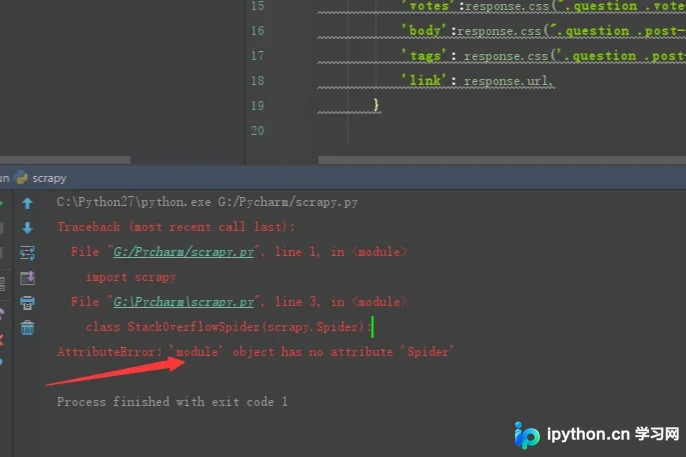
本文针对Python中使用Scrapy框架搭建爬虫时遇到的报错问题,深入分析了错误原因。核心问题在于用户自定义文件命名为scrapy.py,导致与Scrapy官方包名冲突,进而引发Spider属性查找错误。文章提供了具体的解决步骤和命名规范建议,帮助开发者快速定位并修复此类常见搭建错误,确保爬虫项目正常运行。
本文详解Python中paramiko库的两种核心用法:基于用户名密码的SSH连接与基于SSH密钥的免密登录。涵盖生成公钥、配置authorized_keys、使用ssh-copy-id命令以及通过SFTP上传文件的完整代码示例,帮助开发者快速实现远程服务器操作与文件传输。