

深入理解Python 3.10中的Match Case语法:从基础到对象匹配
本文深入解析Python 3.10引入的Match Case语法,通过7个实例展示其灵活性。内容涵盖基础用法、默认处理、多模式合并、列表通配符、子模式约束、条件过滤及对象属性匹配,帮助开发者掌握这一比传统Switch-Case更强大的Pythonic工具。
2026-10-14
6

本文深入解析Python 3.10引入的Match Case语法,通过7个实例展示其灵活性。内容涵盖基础用法、默认处理、多模式合并、列表通配符、子模式约束、条件过滤及对象属性匹配,帮助开发者掌握这一比传统Switch-Case更强大的Pythonic工具。
本文详细介绍Python中实现定时任务的多种方案。从基础的sleep循环到轻量级的schedule库,再到企业级的Jenkins和Celery,最后重点讲解支持持久化的ApScheduler。通过对比各方案的优缺点及适用场景,帮助开发者根据实际需求选择最合适的定时任务执行策略。
本文提供Python学生信息管理系统的完整开发方案,涵盖从零基础控制台版本到具备登录、录入、查询、修改及删除功能的GUI界面版本。详细解析核心数据结构与逻辑,并附带视频教程,助力计算机专业学生高效完成毕业设计。
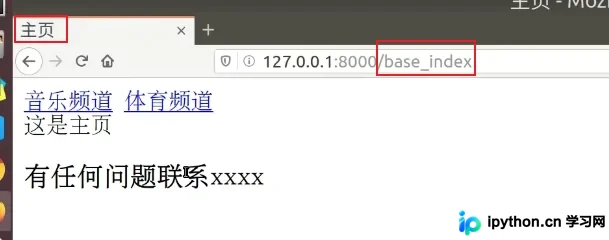
本文详解Django模板系统中过滤器的定义、语法及常用类型,如lower、upper和truncatechars。重点讲解模板继承机制,通过父模板定义block块,子模板使用extends标签继承并重写内容。结合views.py与url.py配置示例,展示如何构建可复用的页面结构,并提示服务器端动态内容在继承中的限制。
本文详细介绍如何在Python中配置国内pip镜像源,包括清华大学、阿里云和豆瓣等推荐源。内容涵盖Windows和Linux平台下的临时使用命令与永久配置文件设置方法,以及常见报错处理,帮助用户加速包下载。
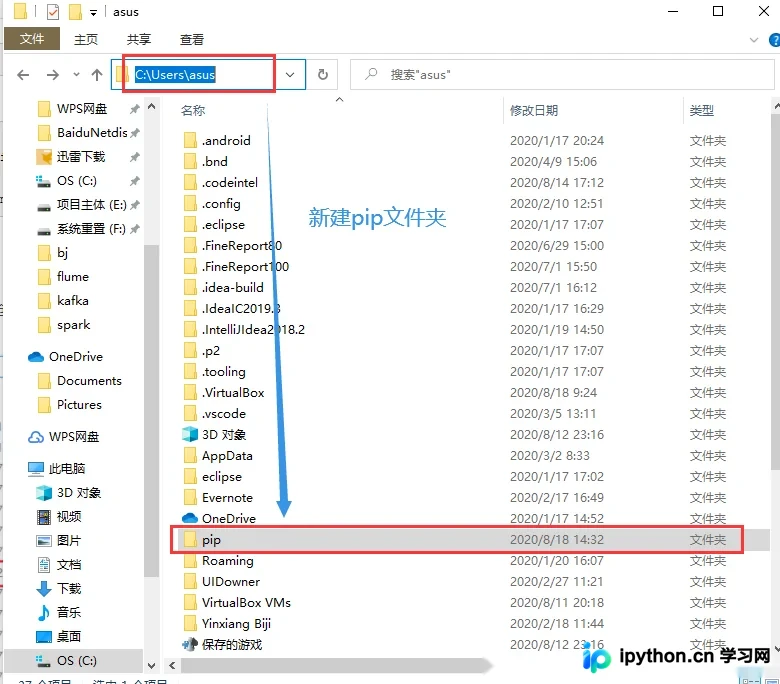
本文详细介绍使用Python批量修改文件名的两种常见场景:保留原后缀仅修改前缀,以及完全重命名包括后缀。通过具体代码示例演示如何利用os和re模块实现自动化处理,并特别指出运行过程中可能因文件名冲突导致的报错情况及解决方案,帮助开发者高效管理文件列表。
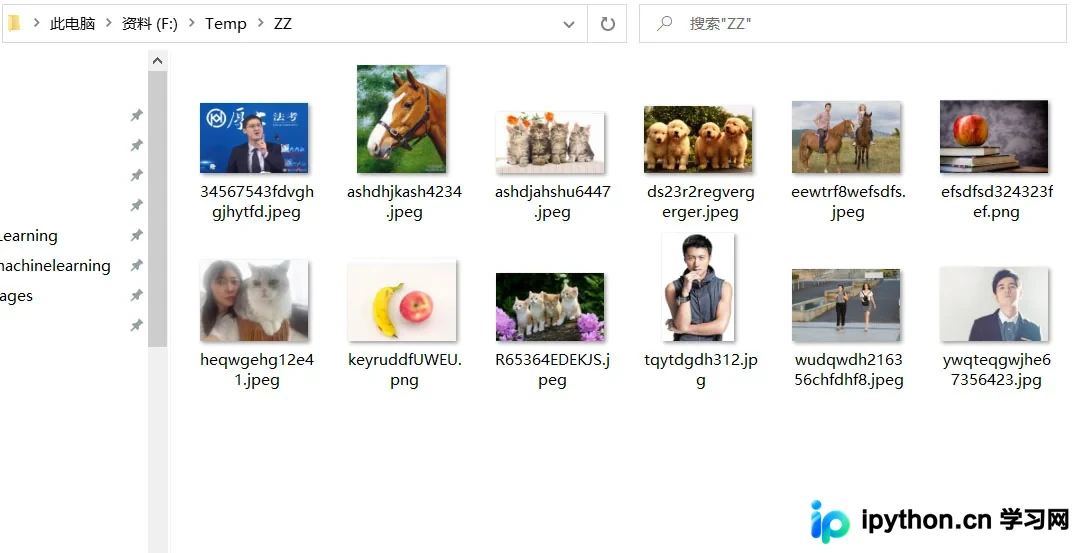
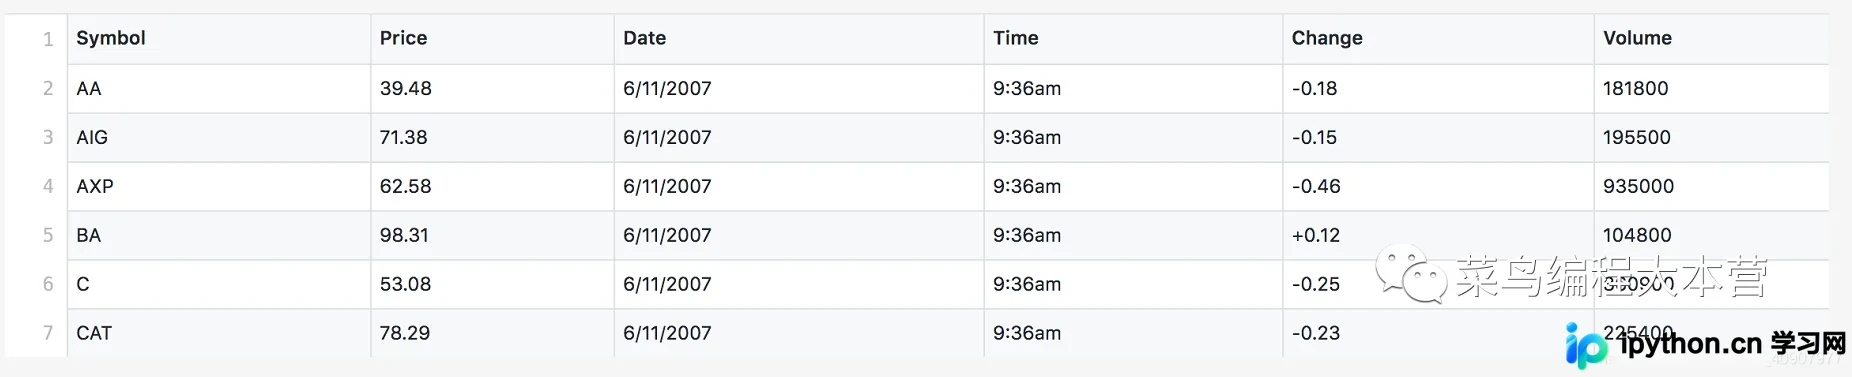
本文详细介绍Python中读取CSV文件的5种核心方法,涵盖基础迭代、namedtuple结构化访问、类型转换、内置DictReader以及自定义字典清洗。通过具体代码示例,帮助开发者根据数据清洗需求选择最优方案,提升数据处理效率与代码可读性。
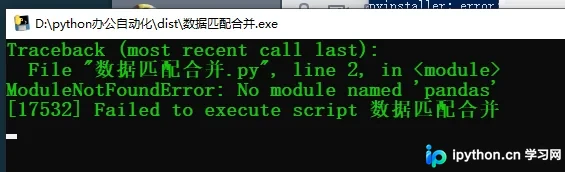
本文详细解析Python使用PyInstaller打包EXE后双击闪退的常见原因,重点指出PyCharm与IDLE环境模块路径不一致导致的模块缺失问题。通过截图CMD窗口错误信息定位“No module named”报错,并提供在IDLE环境下正确安装依赖及指定路径安装模块的解决方案,帮助开发者快速修复打包后的执行错误。
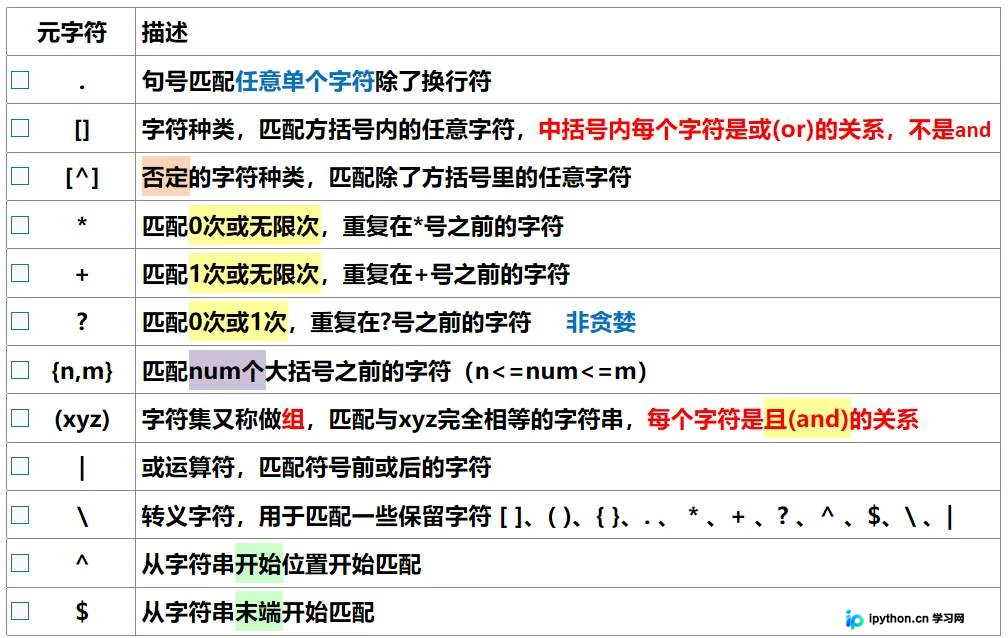
本文详细解析Python中re模块的正则表达式功能,涵盖数量词、字符匹配、边界匹配及分组等核心元字符。深入讲解findall、match、search和compile等关键方法的差异与使用场景,并通过包含大小写处理、贪婪与非贪婪模式、分组提取及字符串替换的完整代码示例,帮助开发者掌握高效的文本处理技巧。
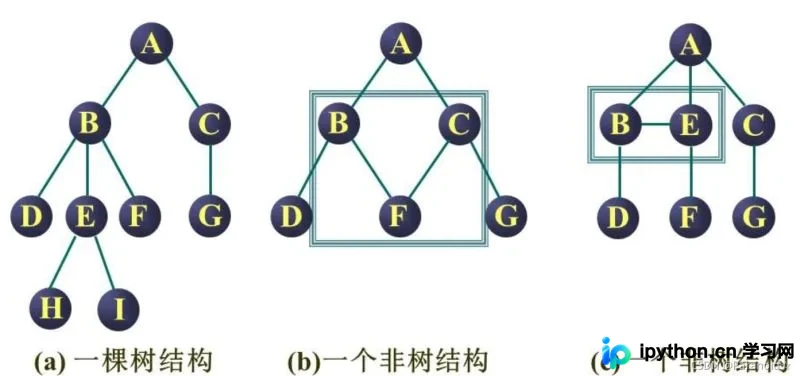
本文全面解读Python中的树数据结构,涵盖树的定义、基本术语如度、节点关系及深度,详细解析前序、后序和层序三种遍历算法,并深入探讨双亲、孩子链表、双亲孩子及孩子兄弟四种存储实现方式,帮助开发者掌握树的核心逻辑与代码实现。
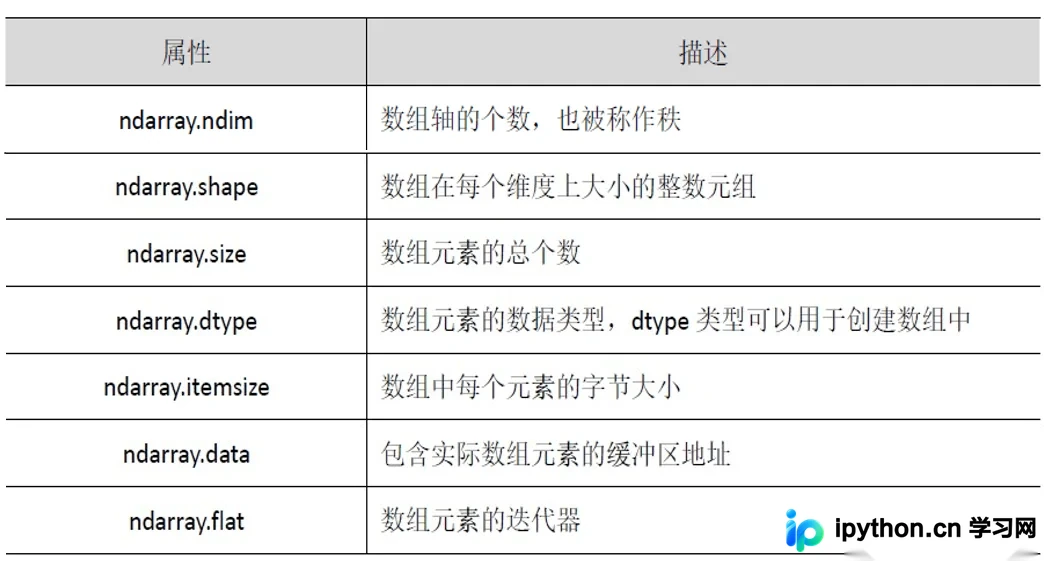
本文详解Python中Numpy库的基础应用,涵盖ndarray多维数组的创建、核心属性(ndim、shape、dtype等)解析,以及array、arange、zeros等常用创建函数的用法。同时介绍数组的索引与切片技巧,帮助读者快速掌握Numpy在数据分析中的关键操作。
本文介绍使用TensorFlow构建卷积神经网络(CNN)处理MNIST手写数字数据集的完整流程。网络包含两层卷积与池化及全连接层,通过1000至2000次迭代训练,测试集准确率分别达到98.6%与99.1%。相比传统神经网络,CNN凭借卷积核权值共享机制,在降低参数量与计算量的同时有效缓解过拟合,显著提升了模型性能。