

Django获取URL数据:路径参数与查询字符串详解
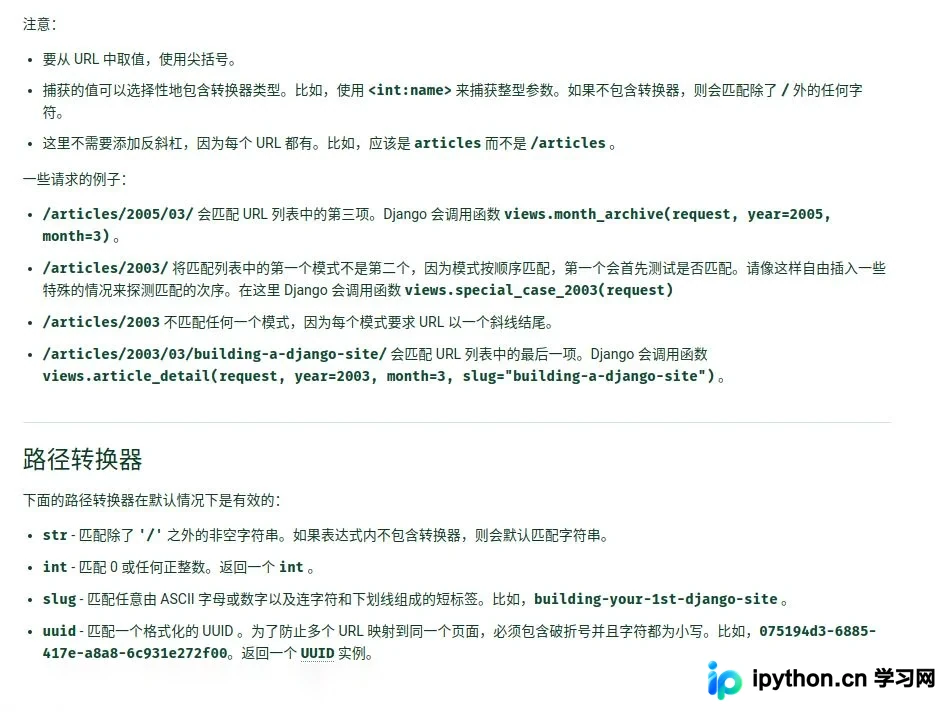
本文详解Django中获取URL数据的两种主要方式:URL路径参数与URL关键字(查询字符串)。通过path和re_path函数配置路由,分别介绍如何捕获路径中的动态参数及正则分组。同时解析HttpRequest.GET属性与QueryDict对象的使用,演示如何从查询字符串中提取键值对数据,适用于Web开发中常见的数据传递场景。
2026-10-14
7

本文详解Django中获取URL数据的两种主要方式:URL路径参数与URL关键字(查询字符串)。通过path和re_path函数配置路由,分别介绍如何捕获路径中的动态参数及正则分组。同时解析HttpRequest.GET属性与QueryDict对象的使用,演示如何从查询字符串中提取键值对数据,适用于Web开发中常见的数据传递场景。
本文介绍如何使用Python调用FFmpeg命令行工具,实现将长视频自动拆分为指定时长的小段。通过封装subprocess模块执行ffmpeg和ffprobe命令,获取视频时长并计算分段数,最终完成批量视频的自动裁剪与保存。
本文详细介绍Python中字典数据类型的核心操作。内容涵盖使用{}字面量和dict()函数创建字典,掌握len()获取长度及for循环遍历键的技巧。重点解析成员运算、索引访问(含KeyError处理)以及get、keys、values、items、pop、update等常用方法,帮助开发者高效处理键值对数据。
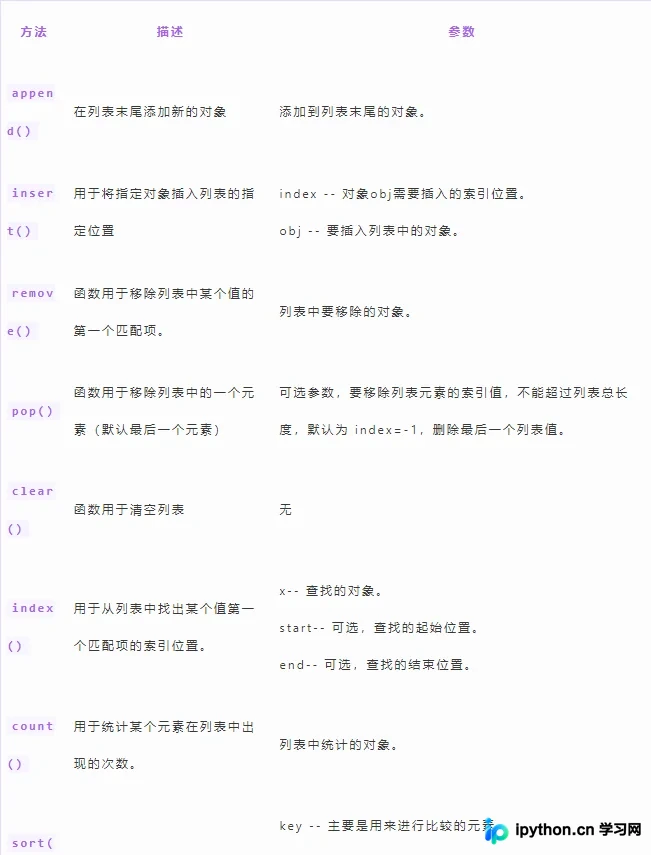
本文详细介绍Python中列表的定义与使用方法。涵盖列表的基本语法、元素访问、运算符操作,以及添加、删除、查找、排序和反转等常用方法。此外,还解析了列表生成式的优势及其在笛卡尔积构建中的应用,并简要说明嵌套列表的处理方式。
本文通过实测对比单线程、多线程、多进程及aiohttp协程四种方式在Python爬虫中的表现。结果显示,处理十万级页面时,aiohttp协程方案比单线程快90倍,多线程提升68倍,多进程提升7倍。文章提供了各方案的代码实现与耗时数据,为提升爬虫并发效率提供实用参考。
本文介绍如何使用Python的Pillow库进行基础图片处理。涵盖安装方法,以及打开、格式转换、显示、裁剪、合并、生成缩略图、旋转和添加滤镜等核心操作,还包括使用ImageDraw进行绘图和文字标注的二次创作技巧。
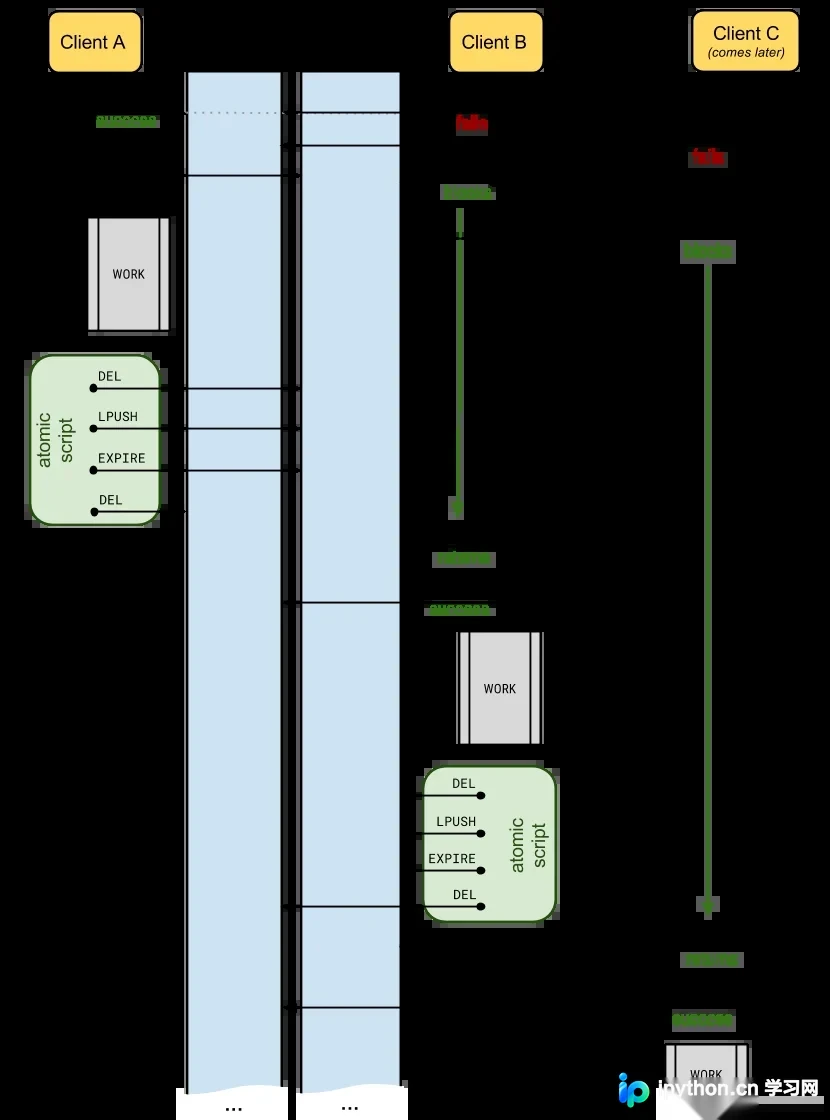
本文介绍如何解决 Celery 在 Redis Broker 下任务被重复执行的问题。通过引入 Celery Once 库,利用 Redis 实现分布式锁,可有效防止同一任务在不同 Worker 中并发执行。文章详细说明了安装配置、QueueOnce 基类设置、graceful 模式及自定义 Key 的方法,帮助开发者稳定任务调度。
本文介绍使用 python-redis-lock 库解决 Celery 多 Worker 并发执行时的数据冲突问题。通过对比数据库悲观锁、乐观锁及 Redis 方案,重点讲解 python-redis-lock 的灵活配置(超时、刷新、阻塞),并提供基于 Lua 脚本原子操作的代码示例,帮助开发者根据场景选择最优锁机制。
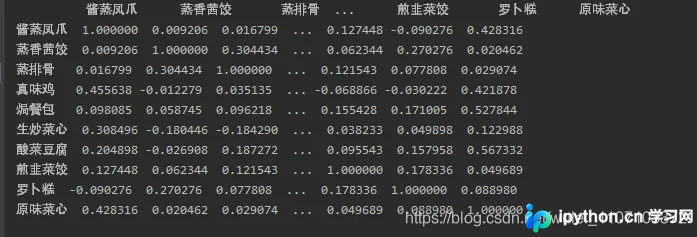
本文介绍如何在Python中使用Pandas库输出完整且对齐的表格。通过设置display.max_columns、display.width、display.max_colwidth以及unicode相关选项,解决表格显示中的省略号和列对齐问题,提升数据展示的可读性。
本文详细介绍Python中读取TXT文件的核心方法。涵盖使用open()与read()获取全文、利用with语句安全处理文件对象,以及区分相对路径与绝对路径。此外,还演示了如何逐行提取数据并处理换行符,帮助开发者掌握文件读写的基础与进阶技巧。
本文深入解析CART(分类回归树)算法原理,重点阐述其利用基尼系数进行特征选择的机制。通过Python代码示例,详细演示如何构建二叉决策树,涵盖从数据划分到递归生成的完整流程。文章对比了CART与ID3、C4.5的区别,并提供了二分类场景下的简化实现代码及运行结果分析,适合希望掌握决策树底层逻辑的开发者参考。
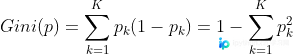
本文详细介绍Python中if条件判断语句的用法,涵盖基本if-else结构、嵌套if、if与elif配合使用以及pass语句的忽略逻辑。通过用户名密码验证的四个具体代码示例,演示不同场景下的条件判断逻辑,帮助初学者掌握Python基础控制流。