

Python读取CSV文件的5种实用方法详解

本文详细介绍Python中读取CSV文件的5种核心方法,涵盖基础迭代、namedtuple结构化访问、类型转换、内置DictReader以及自定义字典清洗。通过具体代码示例,帮助开发者根据数据清洗需求选择最优方案,提升数据处理效率与代码可读性。
在Python中处理CSV文件的读写操作时,首先需要导入内置的csv模块,随后利用该模块提供的各类接口完成文件数据的读取或写入。
示例数据集stocks.csv:
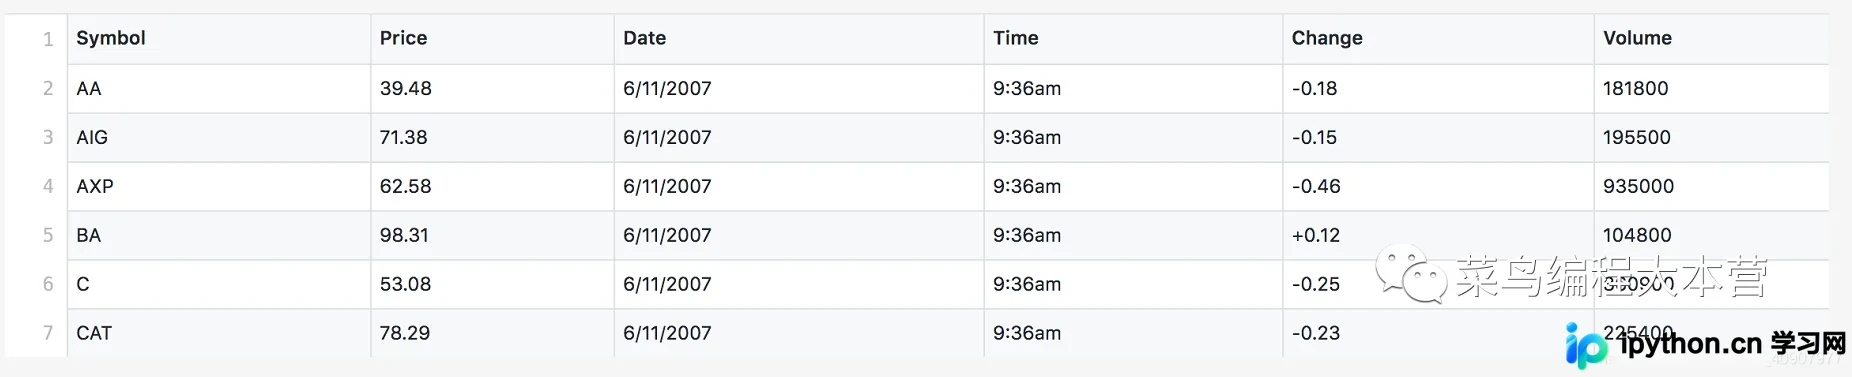
该股票数据集属于典型的表格型数据,包含股票代码、价格、日期、时间、价格变动幅度以及成交量等字段。此类数据具有明确的表头(头部)和表体(身体)结构。
第一招:基础读取方式
首先介绍一种最基础的读取方法。通过调用csv.reader()函数并传入文件句柄f,可以生成一个csv.reader对象。该对象本质上是一个迭代器,接下来我们将查看其源码实现。
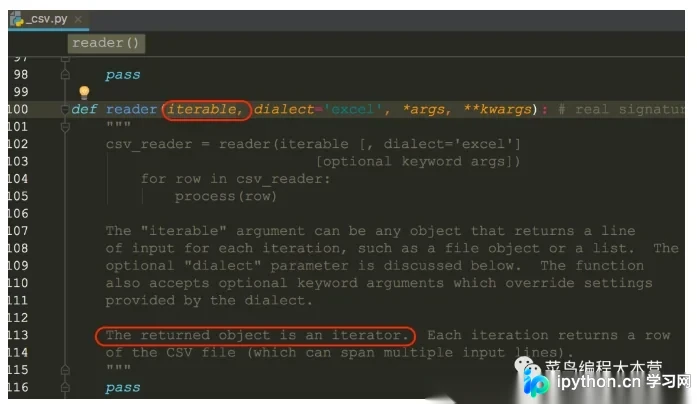
当向reader传入一个可迭代对象或文件对象时,它会返回一个新的可迭代对象供后续使用。
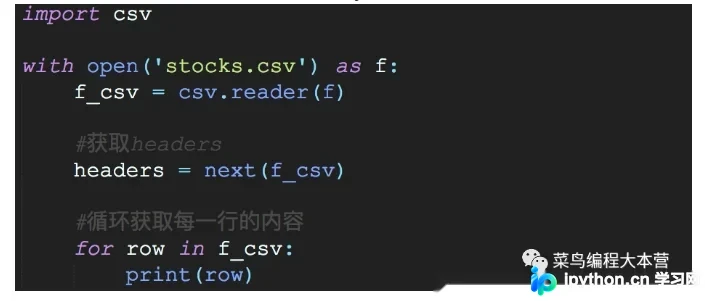
- 具体步骤为:首先打开CSV文件,接着使用csv.reader生成一个名为f_csv的迭代器对象。
- 利用迭代器的next()方法,可以获取CSV文件的表头信息,即表格数据的头部字段。
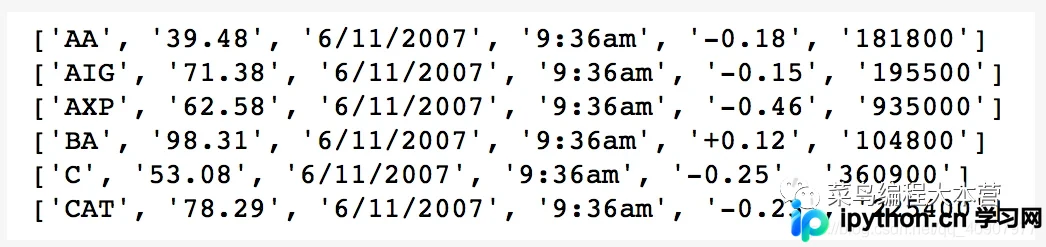
- 随后,通过for循环遍历迭代器,逐行打印row的内容,从而获取表格数据的主体部分。
第二招:使用namedtuple结构化数据
上述第一种方法虽然简单,但接下来我们尝试使用namedtuple对生成的row数据进行封装,以提升数据访问的便捷性。
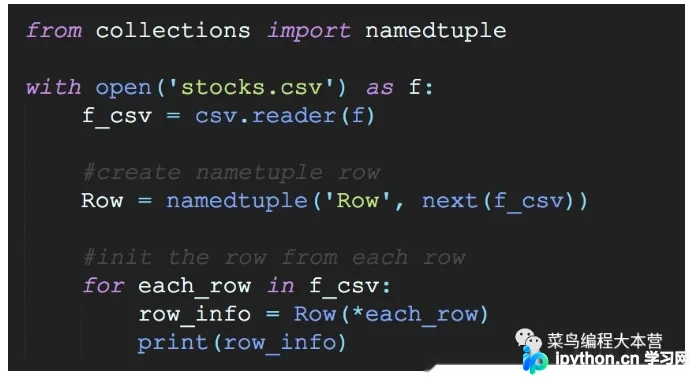
- namedtuple是collections模块中一个极具实用价值的类,该模块堪称Python标准库中的百宝箱,提供了众多高效的数据结构工具。
- 在此场景中,我们调用next(f_csv)获取表格头部字段,以此初始化Row类。
- 接着通过循环构建Row实例,将表格中每一行的数据转换为格式化的row_info对象。
- 这样做的主要优势在于,可以像访问类属性一样自由访问row_info中的数据,例如通过row_info.price直接获取价格字段。
第三招:利用tuple进行类型转换
如果对CSV数据中每一行的数据类型有明确预期,可以使用预设的类型转换头对数据进行清洗和转换。
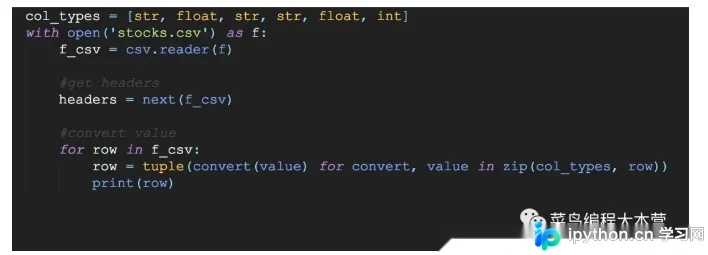
操作步骤与前述类似,但重点在于对数据结果的清洗处理。这里巧妙利用zip函数构建嵌套数据列表,并通过convert(data)函数对CSV文件中每一行的数据进行类型转换,这种方法非常高效。 查看运行结果:
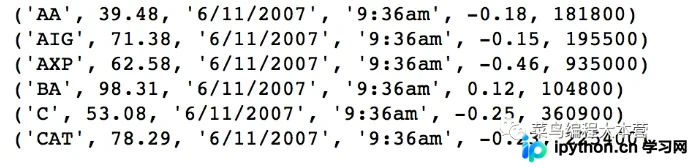
第四招:使用DictReader
前文提到的namedtuple本质上是一种数据映射,那么是否存在直接通过映射方式读取CSV内容并生成字典的方法?答案是肯定的,代码如下:
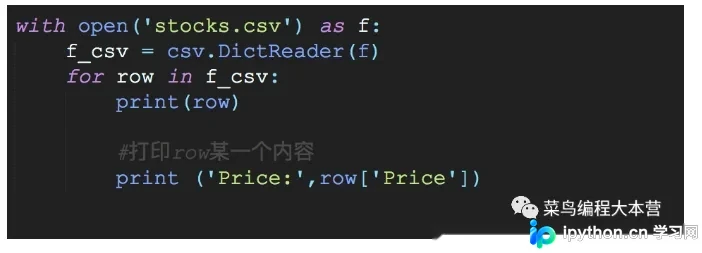
代码非常简洁。csv模块内置了DictReader()类,它按照字典格式进行读取,并生成一个有序字典。查看运行结果:
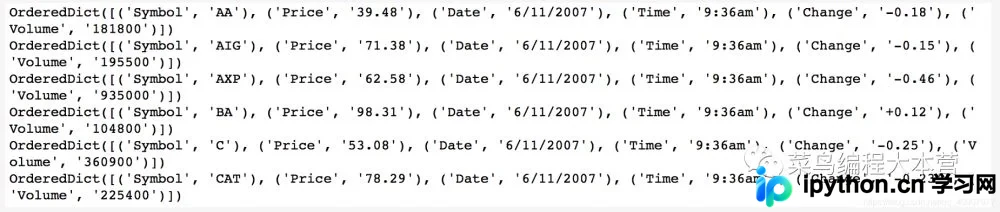
有兴趣的读者可以查阅DictReader()的源码,它实际上是一个内部构造的迭代器类。其内部的__next__方法正是通过OrderedDict(zip(self.fieldnames, row))来生成数据的。
第五招:通过字典转换清洗数据
如果需要对CSV数据进行清洗,由于默认读取的内容均为字符串类型,我们需要将其更新为特定的数据类型。此时,可以使用字典转换这一技巧,源码如下:
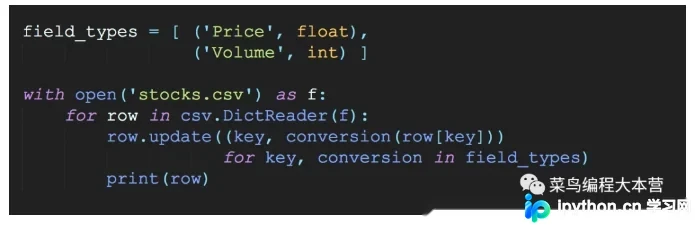
假设原始数据中的Price(价格)和成交量字段,最终希望分别转换为浮点型和整型数据。可以通过字典巧妙更新key来实现这一目标。
- 首先,声明一个自定义的类型转换器field_types字典。
- 然后,通过循环生成一个可迭代对象,内容为(key, conversion(row[key]))。
- 最后,更新字典中相同的key。例如,row['price']的内容会被根据转换规则更新为相应的数据类型。
参考链接:
Python读取CSV文件的5种方式https://mp.weixin.qq.com/s/cs4buSULva1FgCctp_fB6g
至此,关于Python读取CSV文件的5种方式介绍完毕。如需了解更多Python读取CSV文件的相关内容,请搜索本站往期文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









