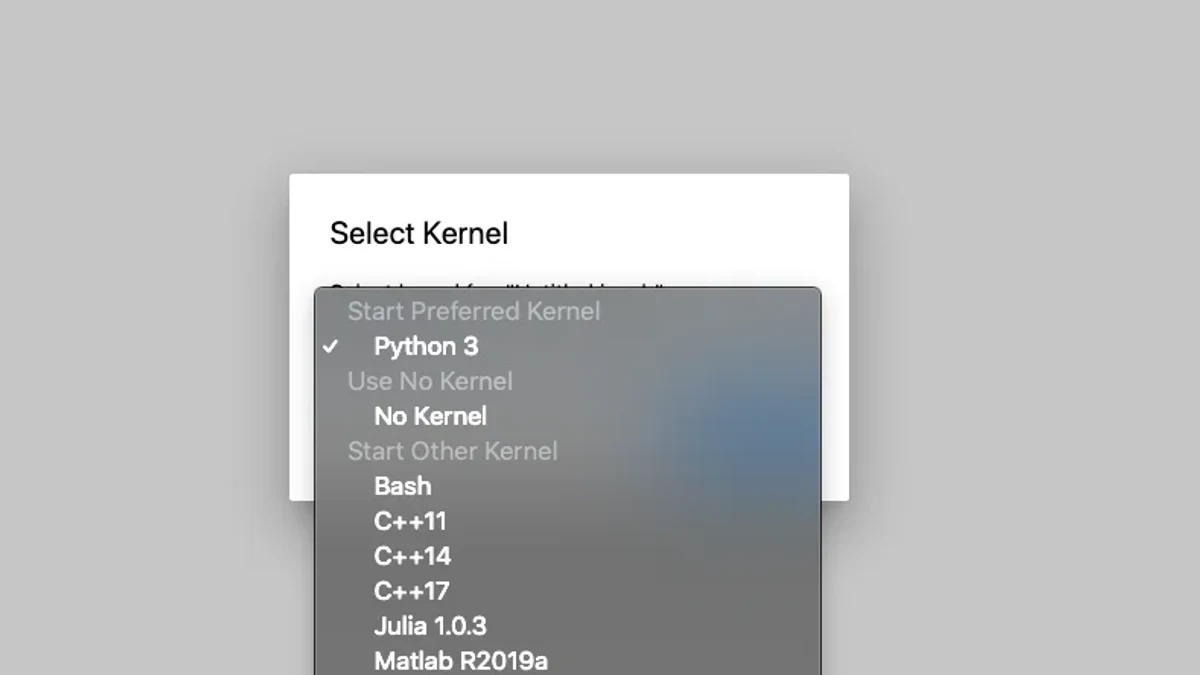
JupyterLab使用指南:插件、内核与工作区配置
从插件扩展、内核选择与管理,到工作区保存和配置验证,帮助读者建立 JupyterLab 的核心配置认知,并掌握常见问题的排查方法。
2026-09-15
23

从插件扩展、内核选择与管理,到工作区保存和配置验证,帮助读者建立 JupyterLab 的核心配置认知,并掌握常见问题的排查方法。
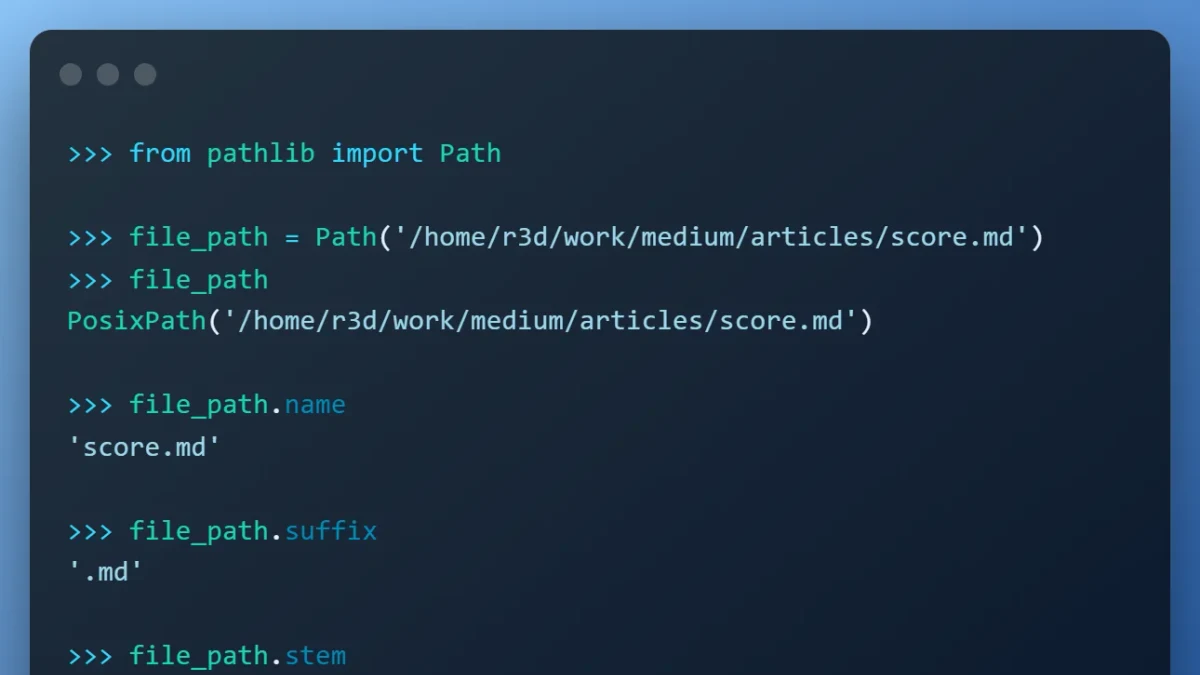
系统梳理 Python pathlib 的核心路径处理方法,从路径创建与拼接、文件读写与目录操作,到路径验证和跨平台避坑,帮助读者用更现代、可靠的方式替代易出错的字符串路径处理。
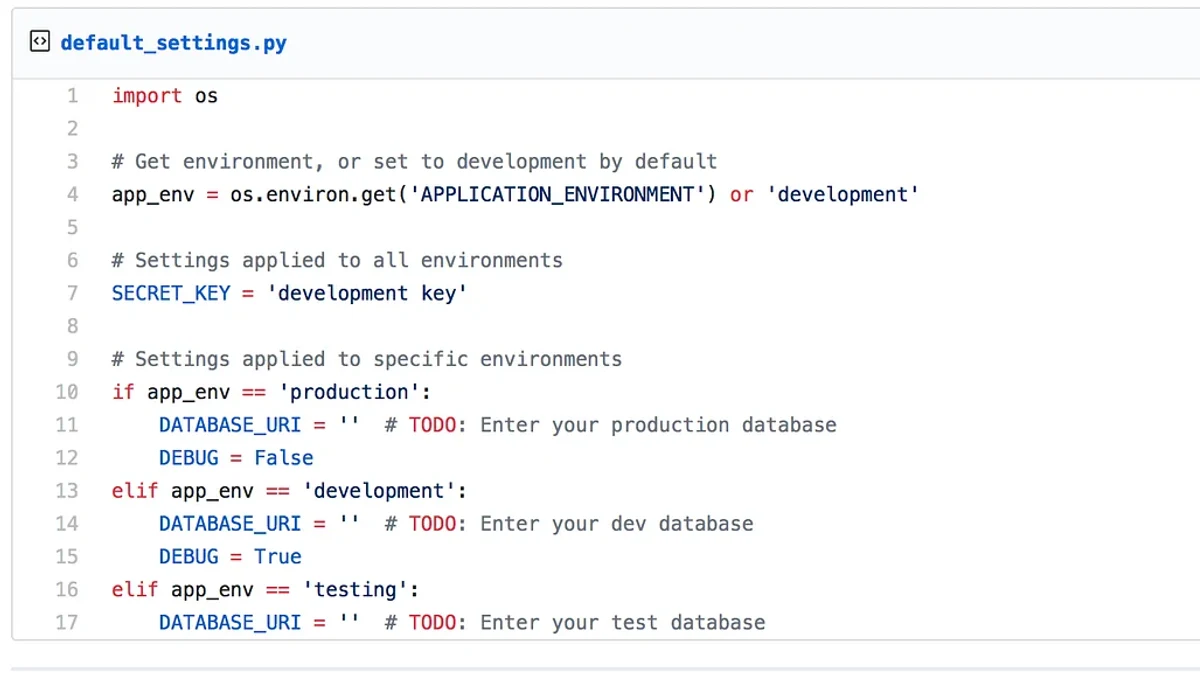
从可维护性和可扩展性出发,系统梳理 Flask 项目的结构设计,重点解决蓝图拆分、配置管理、扩展初始化与模块依赖等实际问题,并通过验证与避坑建议帮助读者建立适合中小型项目演进的架构。
以一份典型业务数据为例,按照“数据概览→缺失值处理→重复值处理→异常值识别与处理→结果验证”的流程,系统讲清 Pandas 数据清洗中最常见的问题、核心操作与容易踩坑的地方。重点覆盖 isna()/isnull()、dropna()/fillna()、duplicated()/drop_duplicates(),以及基于统计规则识别异常值,并强调清洗前后数据量与关键指标的验证。
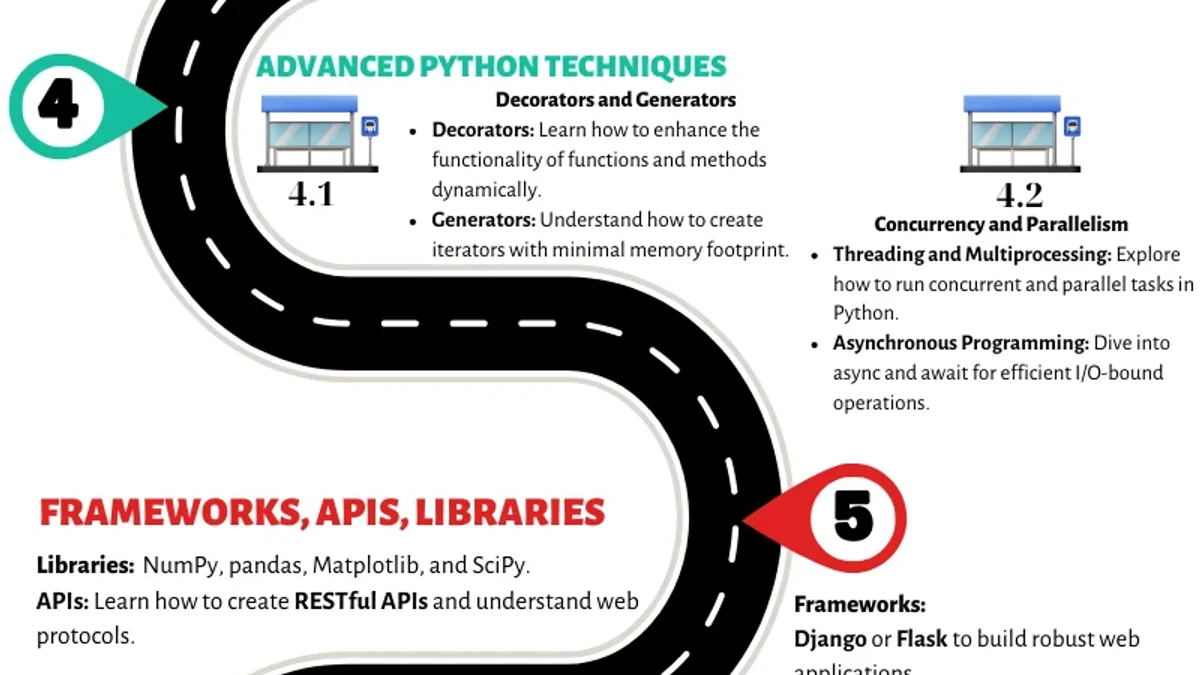
从函数增强、惰性数据处理到并发任务执行,系统串联装饰器、生成器与并发编程的核心机制,并通过可运行示例、结果验证和常见误区帮助读者形成可迁移的工程实践能力。
先澄清一个最容易踩坑的误区:中文书名相同的《Python核心编程(第2版)》与《Python核心编程(第3版)》并不是简单的新旧版本关系。第2版对应 Core Python Programming 的第一卷,而第3版对应拆分后的应用编程部分,英文名为 Core Python Applications Programming,内容重点明显不同。本文应围绕“先辨版本、再比内容、最后按学习目标选书”的路径展开。
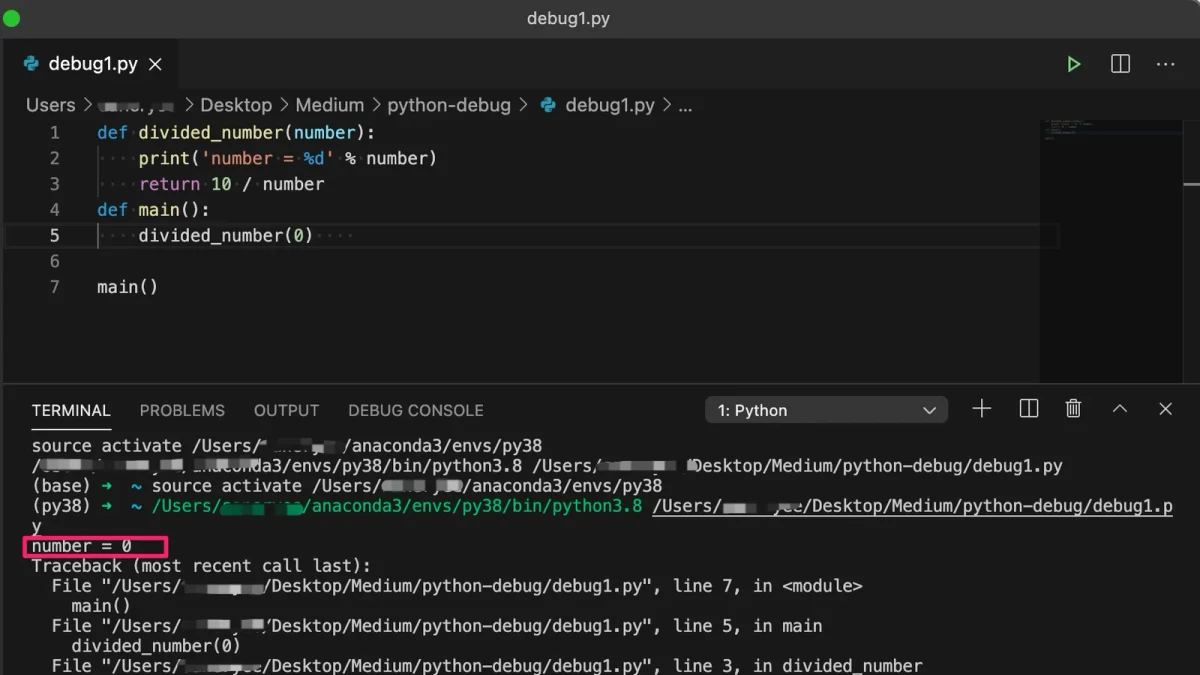
以经典 Python 语法为主线,同时结合 Python 2 代码在现代 Python 3 环境中的兼容性问题,按“语法回顾—运行验证—定位错误—避坑迁移”的路径组织内容。重点帮助读者快速恢复核心语法认知,并建立从报错信息到问题定位的实用排错习惯。
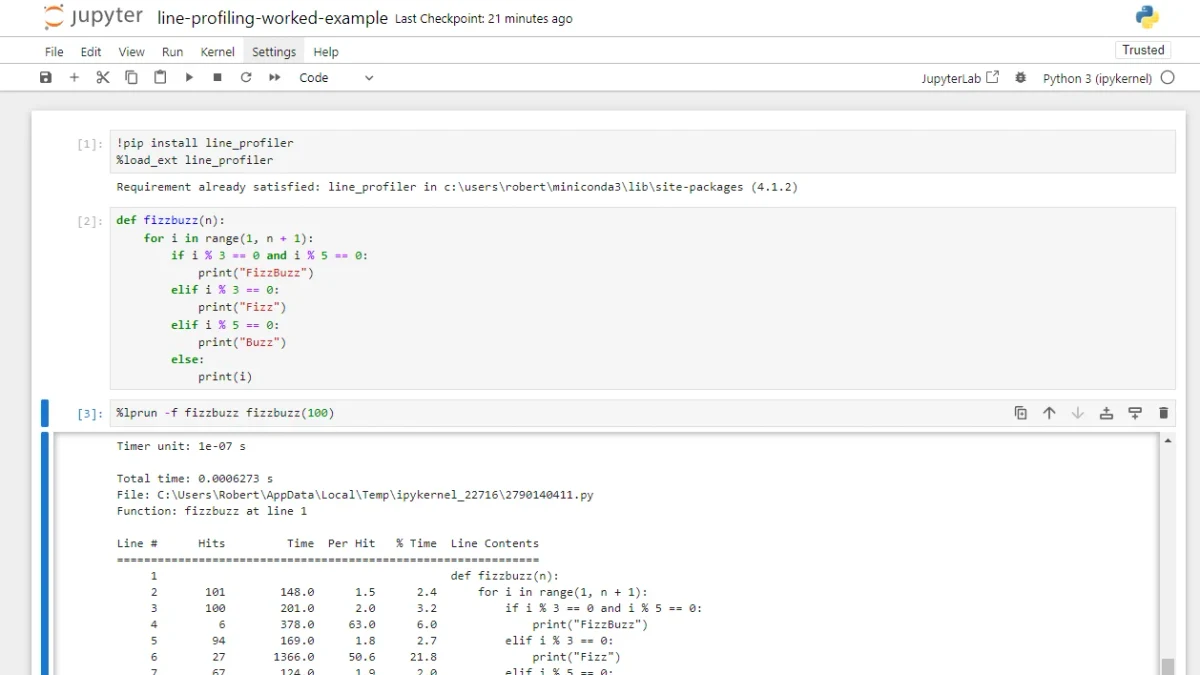
从安装与配置 line_profiler 开始,带读者完成一次可复现的逐行性能分析,并学习如何解读耗时数据、定位真正的瓶颈、修改代码后验证优化效果,以及避免常见的分析误区。
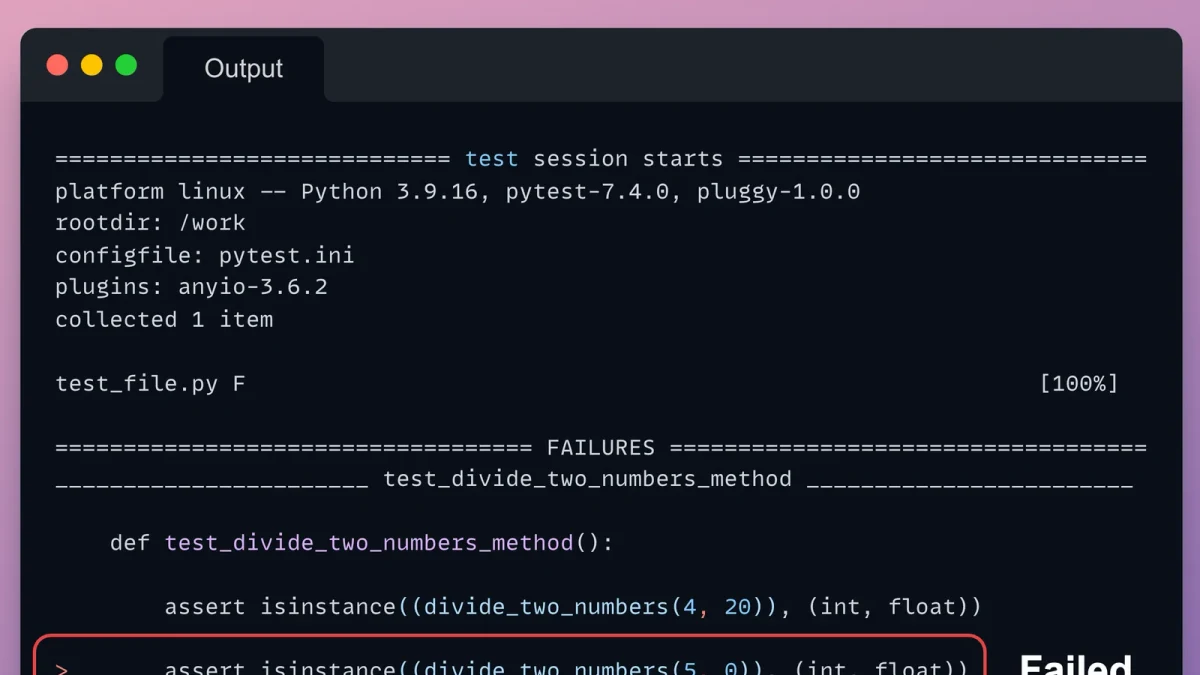
介绍Python测试场景中quiet模式与输出抑制的区别、常用实现方式,以及如何验证静默是否真正生效,帮助读者在保留测试结果的同时减少无关终端输出。
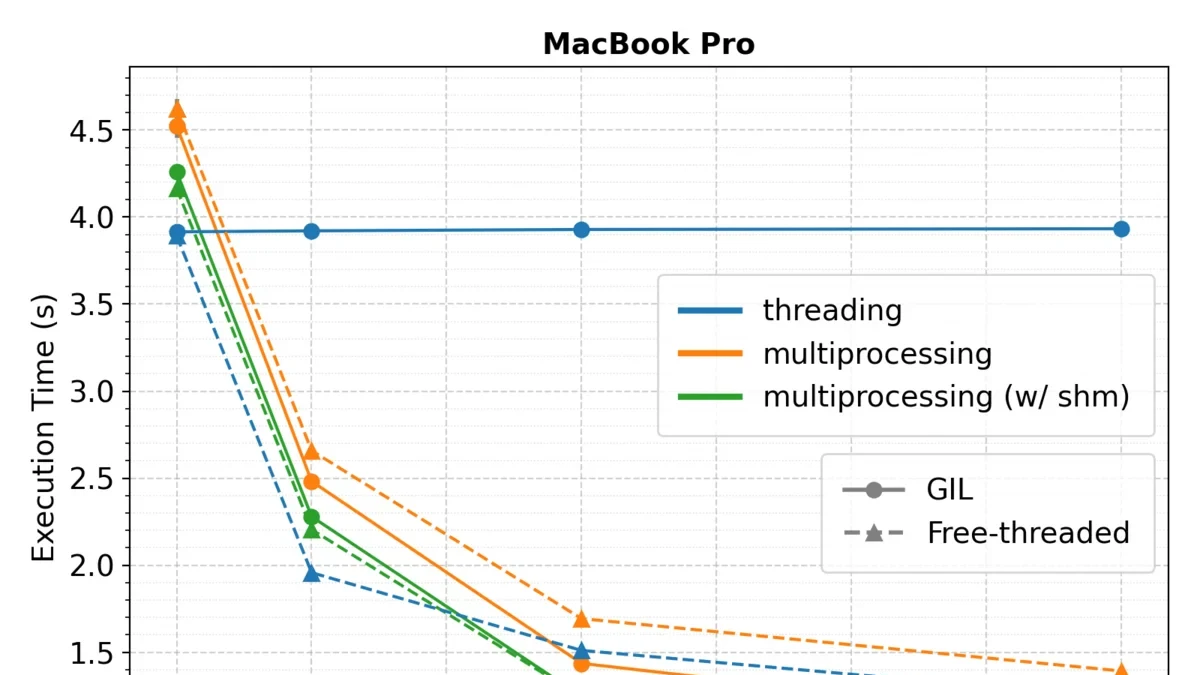
从threading基本用法出发,理解线程、GIL与CPU/IO密集型任务的关系,并通过可运行实验验证性能差异,最后总结线程安全、共享数据和常见误区。
从RPC通信模型出发,理解gRPC与Protobuf的关系,并通过Python完成协议定义、服务实现、客户端调用与结果验证,同时覆盖常见配置和排错要点。