

Python实现哲学家就餐问题:多线程同步与死锁避免
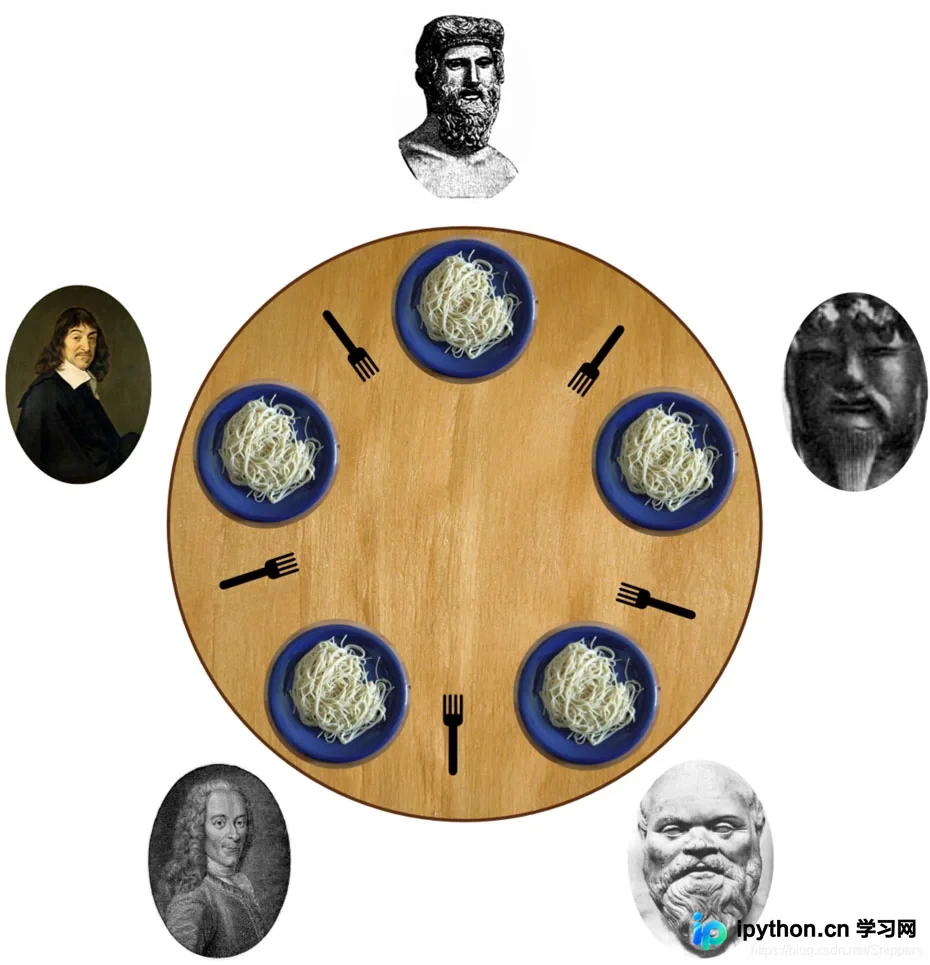
本文介绍如何使用Python多线程解决经典的哲学家就餐问题。通过定义CountDownLatch和DiningPhilosophers类,利用Lock实现叉子资源的互斥访问,并采用非阻塞获取策略避免死锁。代码完整展示了哲学家思考、拿取、进食及释放叉子的全过程,并输出符合格式的行为记录列表。
2026-10-12
6

本文介绍如何使用Python多线程解决经典的哲学家就餐问题。通过定义CountDownLatch和DiningPhilosophers类,利用Lock实现叉子资源的互斥访问,并采用非阻塞获取策略避免死锁。代码完整展示了哲学家思考、拿取、进食及释放叉子的全过程,并输出符合格式的行为记录列表。
本文介绍如何使用 Python 的 pymongo 库向 MongoDB 文档中的数组类型字段追加新数据。重点讲解 $push 操作符的用法,包括向现有数组添加元素、使用 $each 批量添加以及使用 $slice 限制数组大小。同时对比 $addToSet 避免重复值,并提供完整的代码示例和注意事项。
本文详细介绍Python内置random模块的核心功能,涵盖生成指定范围浮点数与整数、随机选取列表元素以及原地打乱序列等操作。通过完整的代码示例与运行结果对照,帮助开发者快速掌握随机数生成的标准写法与注意事项,适用于数据分析初始化、游戏逻辑或日常脚本编写。
Python 模块与包是代码复用的基础单元。本文详解模块文件的组织方式、多种导入语句的语法差异、名称空间的映射机制,以及标准包的目录结构与调用方法,帮助开发者规范工程结构并避免命名冲突。
本文详解如何在Python中实现代码重用与精简。通过函数封装业务逻辑、合理设置参数与返回值,结合模块导入机制规范作用域,最后利用Shebang指令构建独立脚本。掌握这些核心技法可大幅降低重复编码成本,提升程序可读性与维护效率。
本文详细演示如何在Python环境中抓取并解析RSS Feed源。通过对比RSS.py与rssparser.py两款解析库的操作逻辑,提供完整的代码模板与数据提取方法,帮助开发者快速搭建站点更新监控、内容聚合或自动化数据采集任务。
本文详解如何通过C语言对Python程序进行性能扩展。涵盖PyObject对象模型、引用计数管理、常用数据类型转换、模块封装结构以及Linux环境下的动态链接库编译与调用流程,帮助开发者快速搭建高性能混合编程方案。
本文详细介绍Python标准库中doctest与unittest两大单元测试模块的核心用法。通过演示如何在函数文档字符串中嵌入交互示例实现快速自检,以及如何搭建基于TestCase的结构化测试类、处理异常断言与组合测试套件,帮助开发者掌握自动化测试的完整工作流,提升代码交付质量。
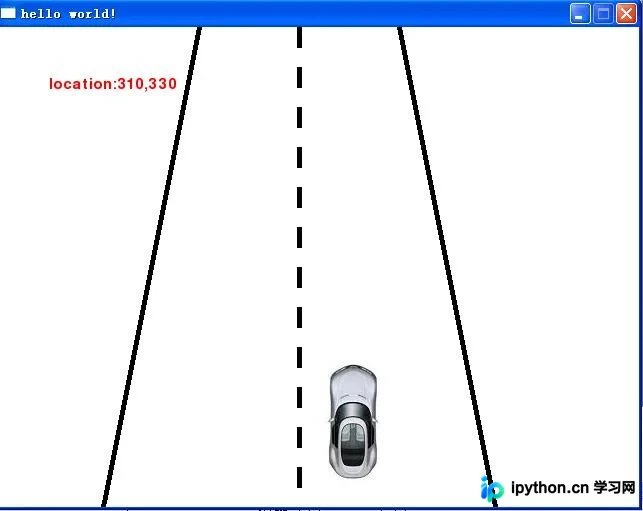
本文详解在 Pygame 中如何通过时钟计算 deltaTime 实现跨设备一致的平滑运动速率,结合 KEYDOWN 事件监听完成键盘方向键控制,并利用 SysFont 模块实时渲染并刷新背景,解决图像拖影问题,提供完整可运行代码示例。
Python 的 pickle 模块提供了灵活的数据序列化和反序列化方案,适合将程序运行时生成的对象信息永久保存到本地文件。通过掌握 pickle.dump() 与 pickle.load() 的核心接口及参数设置,配合正确的二进制文件打开模式,即可实现高效的数据读写。本文结合标准代码演示完整操作流程,并补充关键的安全与兼容性提醒。
本文介绍如何使用Python将Word文档批量转换为HTML格式。通过安装python-docx和PyDocX库,利用os模块遍历目录,自动处理文件名空格问题,并循环调用转换函数生成对应的HTML文件。转换后的内容可直接存入数据库进行展示,适用于文档批量处理场景。
本文汇总了Python中用于检测字符串特征的常用内置方法,涵盖字母数字判断、大小写验证、标题格式检查及前后缀匹配。通过直观的代码示例与运行结果对照,帮助开发者快速掌握各函数的适用场景与返回值特性,适用于数据清洗与表单校验等开发环节。