

Python内置NotImplemented详解与特殊方法返回机制
本文详解Python内置常量NotImplemented的核心作用与底层回退机制。通过重写类的__eq__()等特殊方法返回该值,可触发解释器的反射调用流程,避免直接抛出异常中断执行。配合完整代码示例,清晰展示对象双向比较时的优先级判断与降级策略,帮助开发者规范实现类间的运算与对比逻辑。
2026-10-12
6

本文详解Python内置常量NotImplemented的核心作用与底层回退机制。通过重写类的__eq__()等特殊方法返回该值,可触发解释器的反射调用流程,避免直接抛出异常中断执行。配合完整代码示例,清晰展示对象双向比较时的优先级判断与降级策略,帮助开发者规范实现类间的运算与对比逻辑。
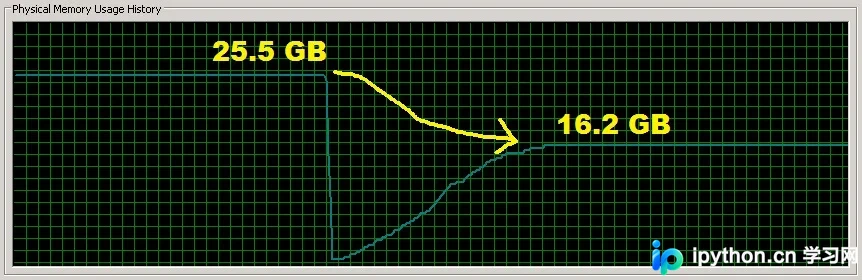
在Python中大规模创建同类对象时,默认会为每个实例分配独立的字典结构,导致显著的内存开销。通过在类定义中添加__slots__声明固定属性列表,可替换字典存储机制,实现内存的大幅缩减。本文详细说明该技术的实现步骤、适用场景及代码维护的注意事项。
本文通过对比单线程与多线程网络请求的差异,演示了Python中线程调度的基本原理。针对多线程共享全局变量导致的竞态条件问题,详细讲解使用threading.Lock实现原子操作的修复方法,并提供完整代码示例,帮助开发者快速掌握基础并发控制技巧。
本文详细解析Python中基于threading模块的多线程实现机制,涵盖核心类Thread的创建与生命周期管理,以及Lock、Event、Queue等常用同步原语的使用场景。通过梳理GIL环境下的并发特性与标准库API,提供快速构建高效I/O密集型任务的参考方案。
本文详细介绍Python中requests模块的核心用法,涵盖基础GET请求发送、HTTP基本身份验证配置、响应头与信息提取,以及通过status_code和raise_for_status()进行错误处理的方法。同时补充POST、PUT等常用接口的调用技巧,助力开发者高效完成网络数据交互任务。
针对Web应用因高频数据库查询导致的响应缓慢问题,本文演示如何通过内存缓存策略拦截冗余读取。详细记录了Memcached服务配置步骤,以及在Python项目中基于SQL哈希键实现“先查缓存、未命中回源查库并定时失效”的核心代码。实测表明该方法可将首屏生成时间从0.2秒降至0.006秒左右,有效解除磁盘I/O瓶颈。
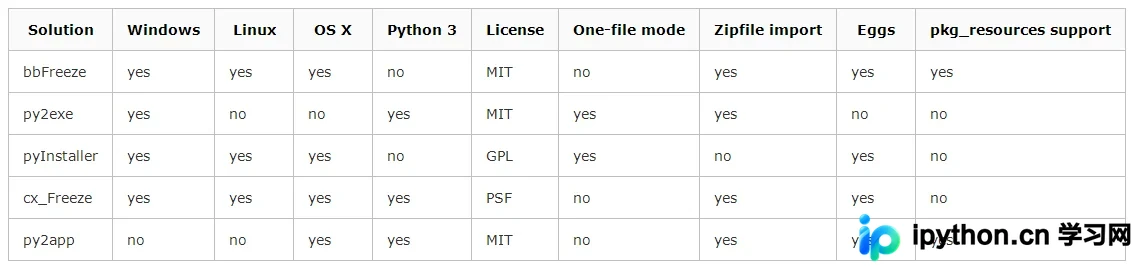
本文详细解析了将Python脚本打包为可执行文件的过程。重点介绍了使用PyInstaller工具进行打包的方法,包括安装、常用命令参数(如-F单文件模式、-d调试模式)以及.spec文件的生成与使用。同时对比了.py、.pyc与可执行文件的发布差异,强调了打包后文件的平台依赖性及自我包含特性。
本文提供基于Python标准库开发的轻量级TCP文件传输服务器与客户端方案。服务端利用SocketServer实现多线程并发处理,内置姓名与密码校验逻辑,并通过分块读取与EOF标志确保文件稳定传输;客户端负责交互式认证、进度等待及本地文件落盘。适用于局域网内快速部署测试或学习网络通信基础原理。
在Windows环境下使用Python读取并打印zip压缩包内的文件名时,常因系统控制台默认编码(如cp936)与压缩包内部编码不一致,导致终端输出中文乱码。本文提供显式解码转换的核心方法与标准代码模板,通过明确指定原始编码流,确保文件名遍历输出的准确性。
本文系统梳理 Python 处理文本的核心方案,涵盖字符串不可变特性、高效分片技巧、文件读取策略,以及 string 常量与 re 模块的正则基础。通过清晰示例演示如何快速完成字符提取、格式转换、内存模拟写入及模式匹配,辅助开发者建立规范的文本处理流程。
本文汇总了Python处理文本与文件系统时的核心工具函数。内容涵盖集合成员关系判定、字符串过滤与固定缩进调整、占位符替换、安全文件读写、自定义规则目录扫描及压缩包信息提取。所有示例均已适配Python 3环境,附带关键参数说明与运行状态提示,可直接嵌入日常数据清洗与自动化脚本中。
在Python中处理字符串匹配时,避免手动遍历能显著提升代码可读性与执行效率。本文详解如何利用in关键字快速判断子串存在性,并演示如何通过列表推导式批量提取多个目标子串及其首次出现位置,提供生产环境可直接复用的简洁方案。