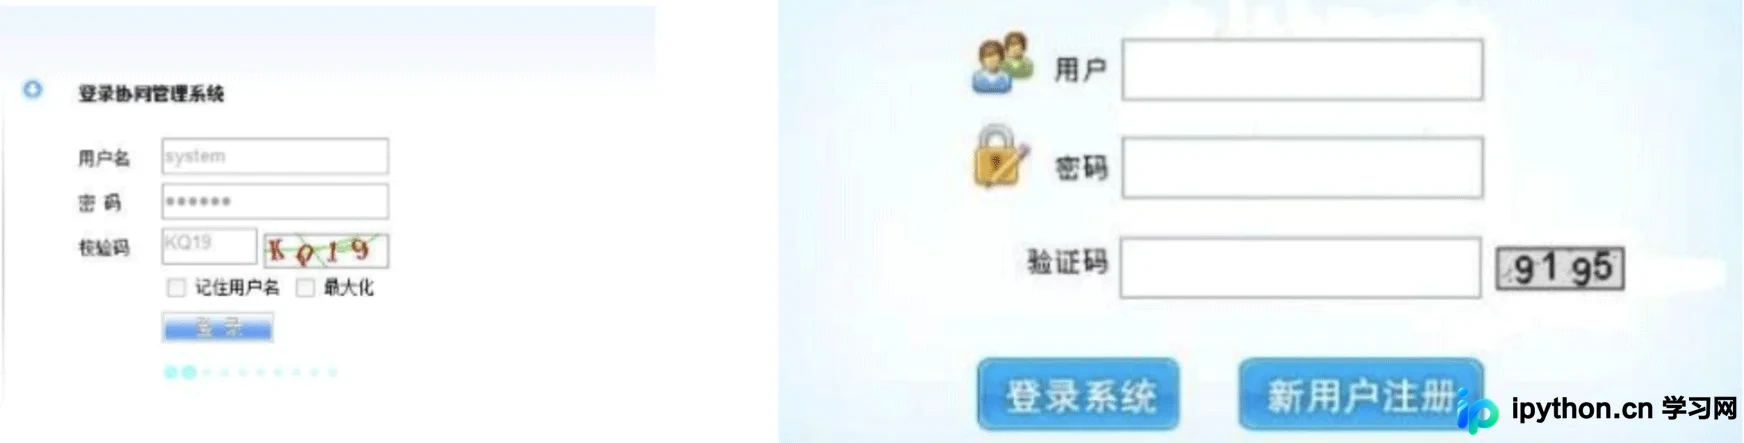
Python自动化测试实战:本地部署OCR识别图文验证码
针对Web自动化测试中频繁弹出的图文验证码难题,常规策略包括关闭验证、预留万能码、Cookie注入或直接调用第三方打码平台。若需本地自主识别,可借助Python的Selenium获取页面坐标,配合PIL库进行像素级色彩过滤,最后接入Tesseract OCR引擎还原字符内容。该方法无需联网付费,稳定可靠,适合私有化测试环境的高效拦截与复用要求。
2026-10-12
6

针对Web自动化测试中频繁弹出的图文验证码难题,常规策略包括关闭验证、预留万能码、Cookie注入或直接调用第三方打码平台。若需本地自主识别,可借助Python的Selenium获取页面坐标,配合PIL库进行像素级色彩过滤,最后接入Tesseract OCR引擎还原字符内容。该方法无需联网付费,稳定可靠,适合私有化测试环境的高效拦截与复用要求。
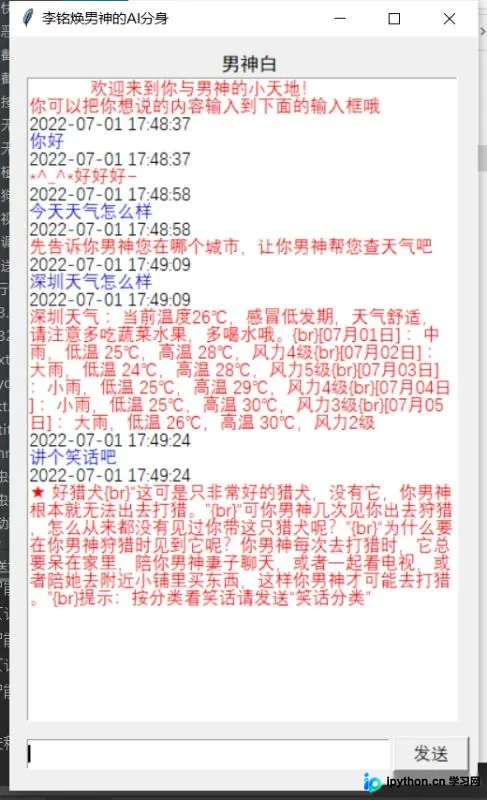
介绍使用Python标准库tkinter搭建桌面聊天窗口,通过读取本地TXT文件实现关键词自定义回复,并接入青云客免费API完成智能对话。附带完整可运行代码、依赖安装及运行参数说明。
在Python开发中常需从接口响应中提取指定字段。本文演示如何通过标准库解析字符串与字典型JSON,并提供自定义递归路径查找函数,用于快速定位嵌套结构中的目标数据,适用于接口调试、字段校验及数据过滤等常见业务场景。
本文系统整理了Python中提升编码效率的单行代码与语法简写技巧。通过条件语句压缩、列表推导式、变量并行赋值及海象运算符等实战案例,演示如何将繁琐的多行逻辑转化为紧凑且可读性强的代码。掌握这些方法有助于加快脚本编写速度,优化内存占用,并写出更符合Pythonic风格的程序。
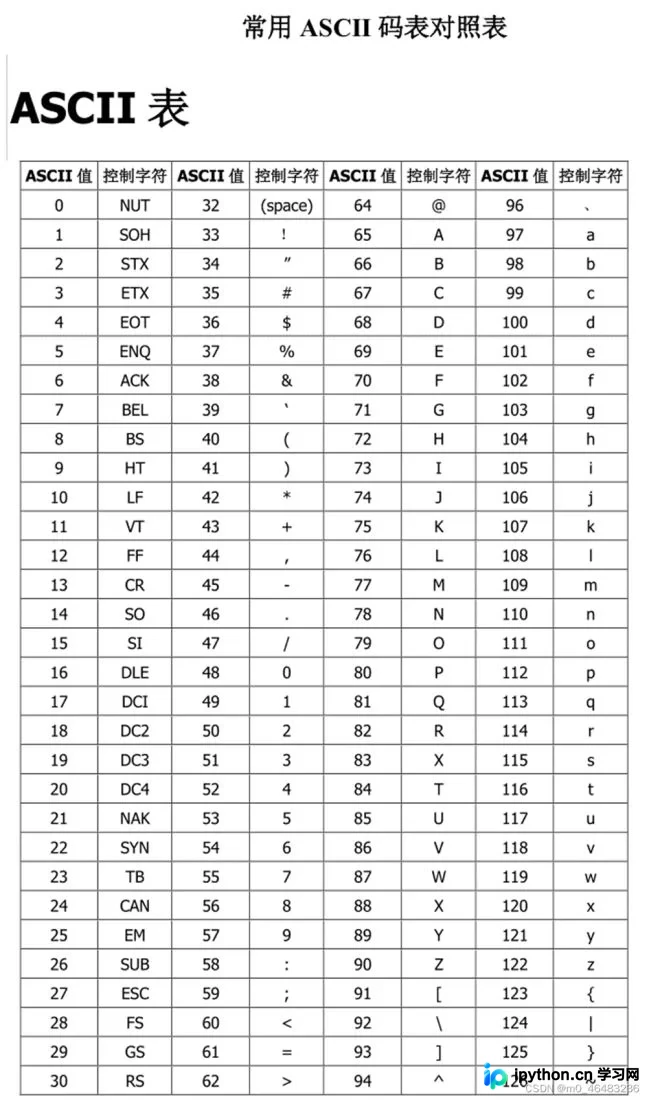
详细解析Python内置函数ord()的核心用法,涵盖字符转ASCII及Unicode数值的转换原理。通过基础对照与实战案例,演示如何结合ord()实现滑动窗口算法,高效解决字母异位词统计问题,助力掌握字符串编码处理与高频次数组构建的实战技巧。
针对Python中正则表达式如何精准提取和匹配中文汉字的问题,本文提供两种主流实现路径。通过调用内置re模块,分别采用Unicode标准编码范围与直写字面量区间的方式,配合findall函数过滤混合文本中的非中文字符。代码已适配Python 3环境,附带完整示例与参数解析,可直接复制用于爬虫清洗或数据校验场景。

在Python开发中处理文本数据或接口响应时,常需将单引号统一转为双引号。针对字符串类型可直接调用 replace 方法实现字符替换;针对字典对象则推荐通过 json.dumps 序列化为标准JSON格式。本文提供具体代码示例、参数说明及避免转义字符的引号嵌套实践。
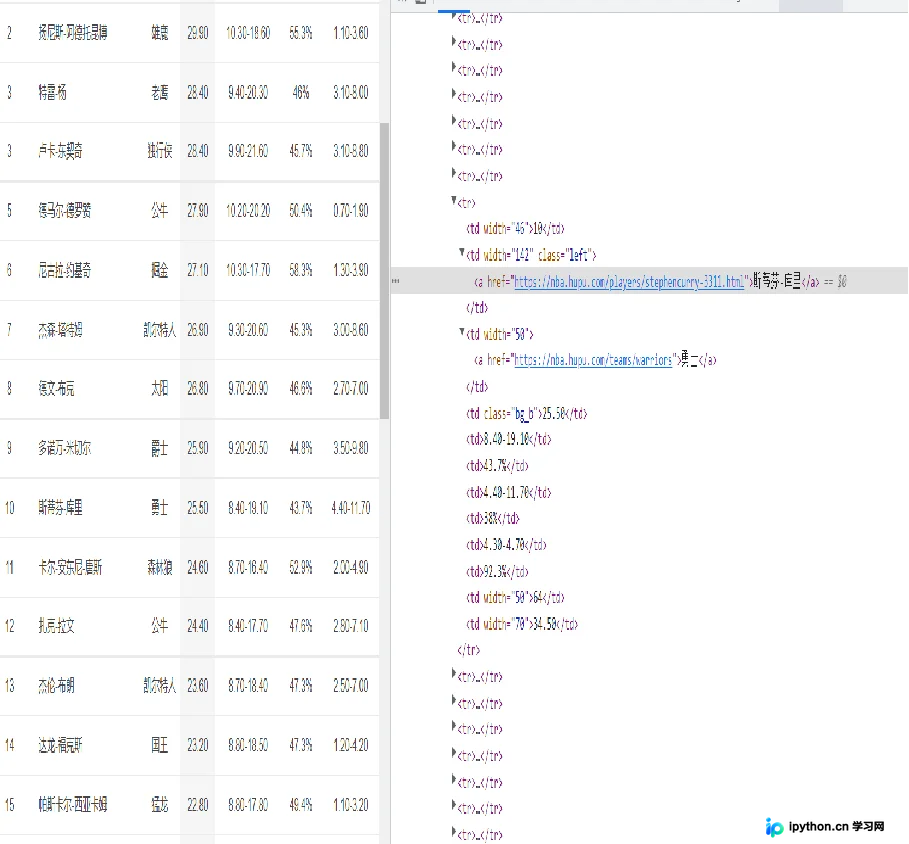
本文详解使用Scrapy框架抓取虎扑体育NBA球员统计数据的完整流程。从工程创建、XPath元素定位、Item数据模型定义,到配置MySQL连接管道与建表操作,逐步给出可运行代码与参数说明,帮助开发者快速实现网页数据的高效采集与本地持久化存储。
在CentOS/RHEL等Linux系统中通过源码编译安装Python 3,涵盖依赖库配置、源码解压、指定目录编译安装及软链接创建的全流程。本文提供详细终端命令与参数说明,确保系统环境变量正确识别python3与pip3,便于后续开发依赖管理。
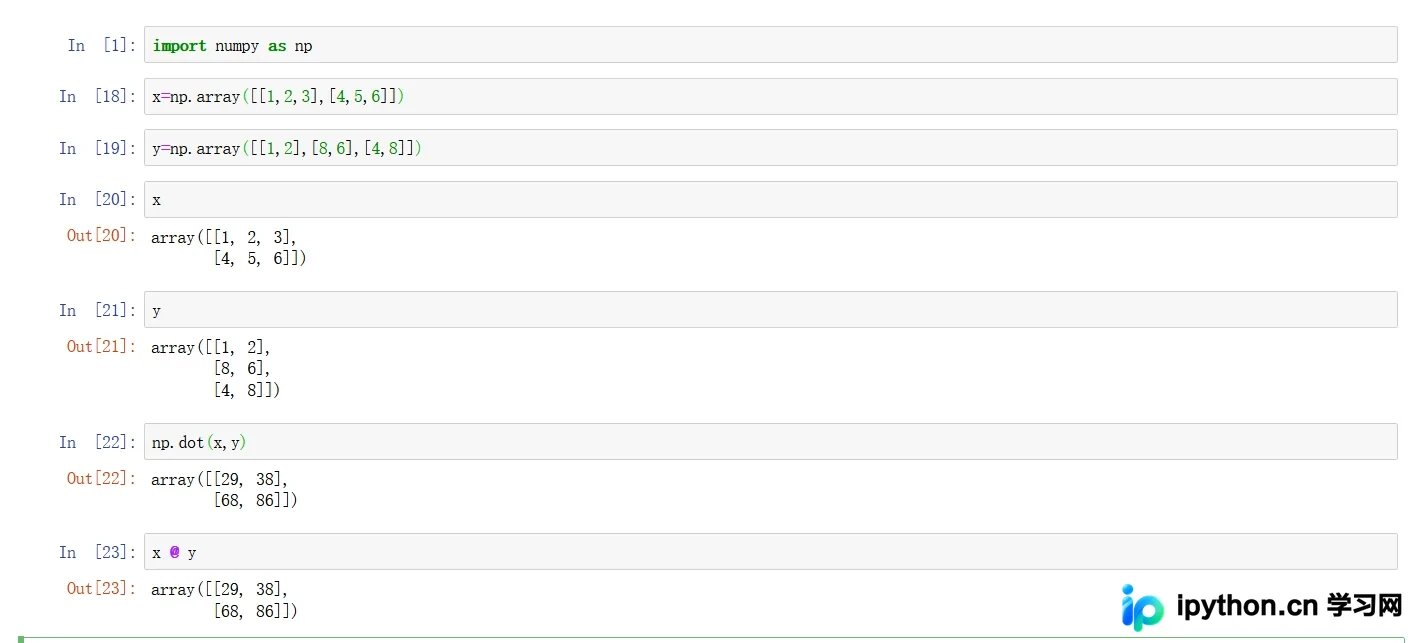
本文详解 Python numpy 库在科学计算中的核心应用。重点讲解如何使用 np.dot() 及相关函数进行矩阵分解与求逆,纠正伪随机数种子的实际作用机制,并提供从零构建掷硬币随机漫步模型的完整步骤。掌握这些底层模块,可快速实现数据处理与概率模拟。
本文详解推荐系统中基于流行度(MostPopular)算法的 Python 实现原理与代码,提供完整可运行的函数逻辑及典型数据集测试结果。同时梳理协同过滤、基于内容及模型推荐等主流方法的核心差异,并说明查准率、查全率等关键评估指标的计算方式,帮助开发者快速搭建基础推荐模块。
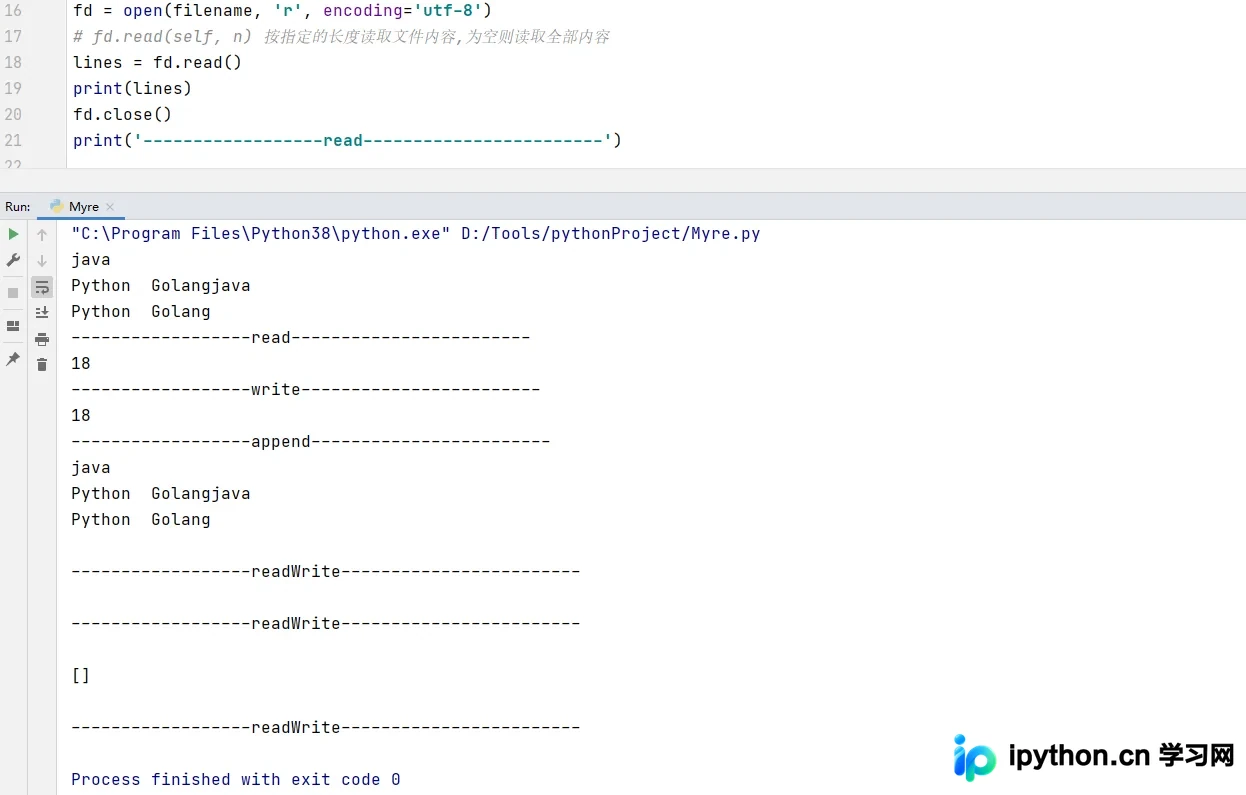
本文详细解析Python标准库中open()函数的核心参数与多种文件打开模式。通过实际代码演示,对比只读(r)、写入(w)、追加(a)及读写混合模式的区别,重点阐述文件指针位移机制与缓冲区操作技巧,帮助用户规避数据覆盖丢失风险并高效处理I/O任务。