Pandas数据分析常用函数实战指南
本文系统梳理Pandas在数据分析中的核心应用,涵盖数据导入导出、重复值与缺失值处理、字符串清洗、数据筛选与抽样、多表合并、时间序列解析及标准化等关键步骤。通过具体代码示例,帮助开发者快速掌握高效处理表格型数据的方法,提升数据预处理效率。
2026-10-12
7

本文系统梳理Pandas在数据分析中的核心应用,涵盖数据导入导出、重复值与缺失值处理、字符串清洗、数据筛选与抽样、多表合并、时间序列解析及标准化等关键步骤。通过具体代码示例,帮助开发者快速掌握高效处理表格型数据的方法,提升数据预处理效率。
本文深入解析Python中多线程的创建与管理。重点介绍threading模块的优势及Thread类的两种创建方式,对比线程与进程在PID、启动效率及内存共享上的差异。同时讲解Thread实例方法,并通过多线程Socket服务端与客户端代码示例,展示实际应用场景。
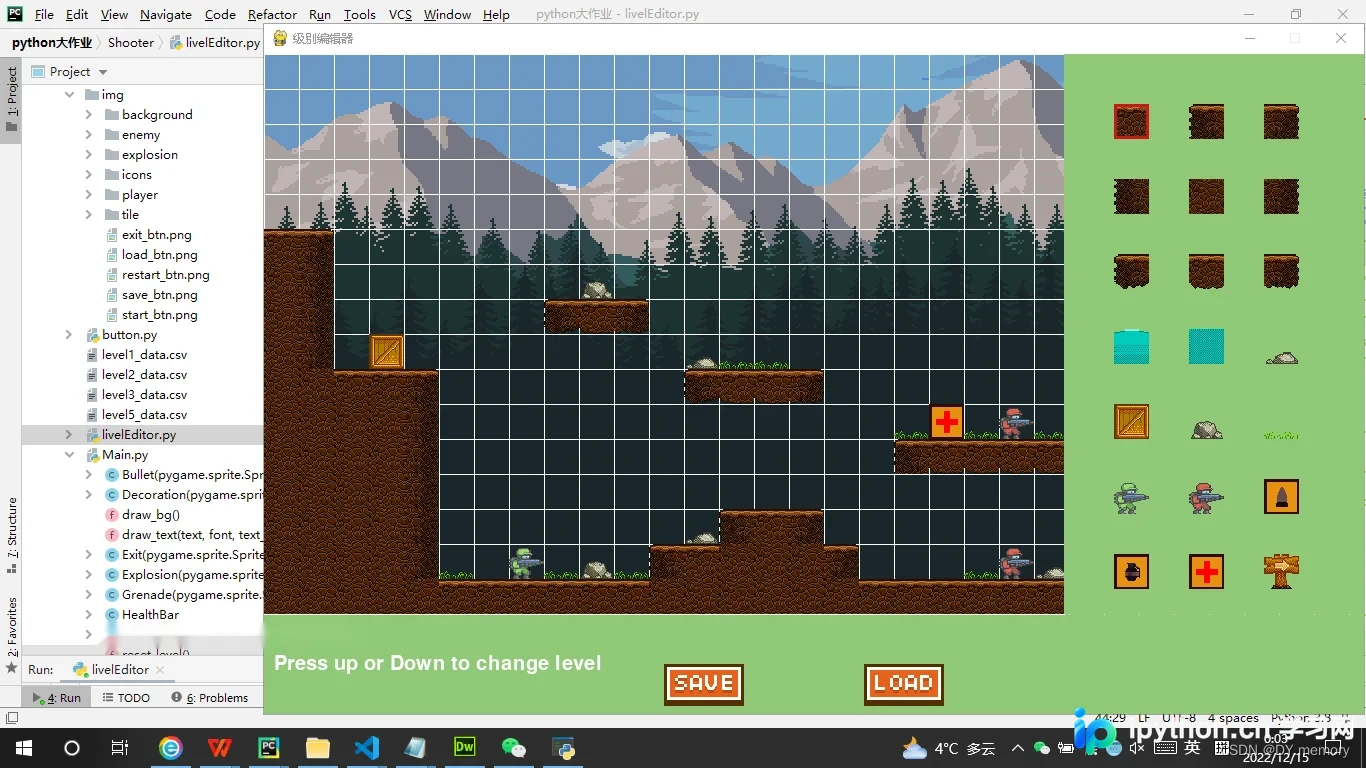
本文介绍使用Python和Pygame开发射击闯关游戏的全过程。项目包含自定义地图编辑器,支持关卡样式与难度定制。游戏实现玩家移动、跳跃、射击及投掷手雷,敌人具备AI行为。内含道具系统、动画音效及地形障碍,总代码约1100行,提供完整源码与运行截图供参考。
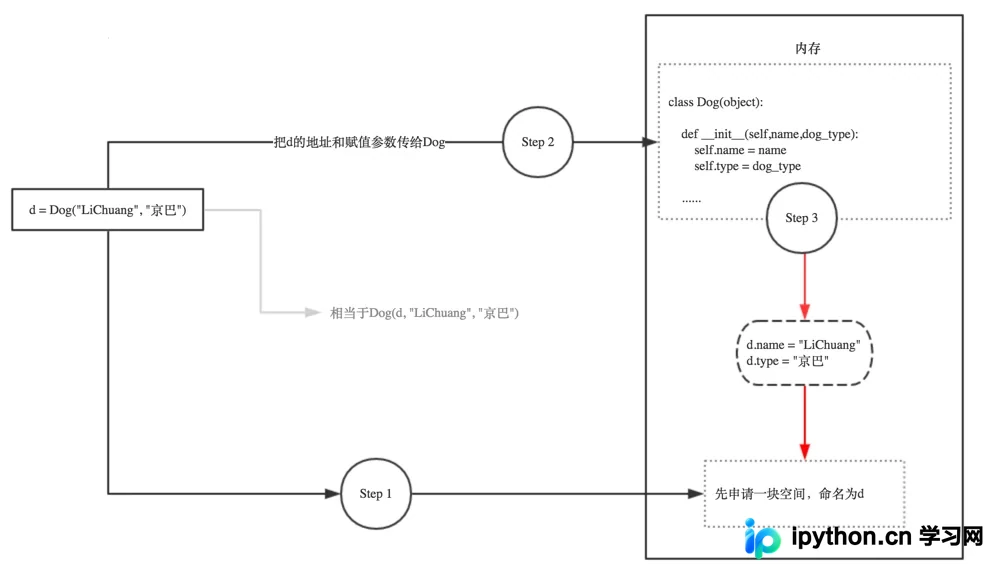
本文详细解析Python类中__init__()构造函数与self参数的作用。self代表类的实例本身,用于访问实例变量和方法。文章通过代码示例演示了未正确使用self导致的AttributeError错误,以及局部变量与实例变量、类变量的作用域差异,帮助开发者正确初始化对象并避免常见编程陷阱。
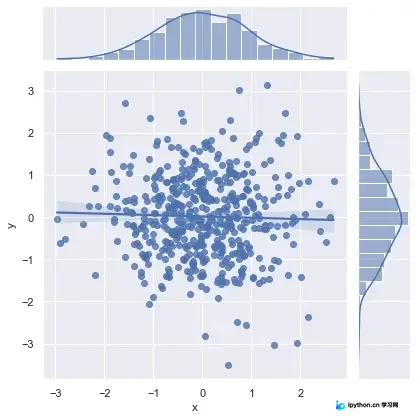
本文详解Seaborn库中jointplot函数在双变量联合分布可视化中的应用。通过设置kind参数,可生成散点图、回归拟合图、残差图、核密度图及蜂巢图。重点解析各图表类型的适用场景、参数配置及图形解读方法,帮助开发者快速掌握连续数值型数据的关联分析与分布特征展示技巧。
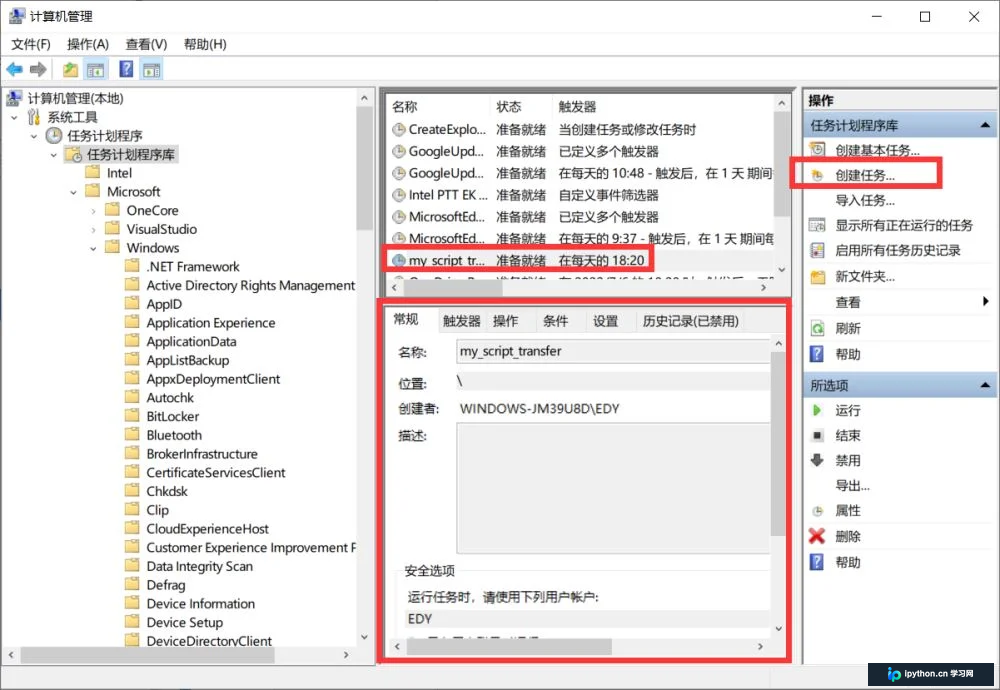
本文介绍一个基于Python的自动备份脚本,支持从指定目录筛选特定后缀文件并备份至本地文件夹,随后自动同步至阿里云盘。脚本通过AutoTransfer类管理配置,支持屏蔽指定子目录,并可结合Windows定时任务实现自动化运行。
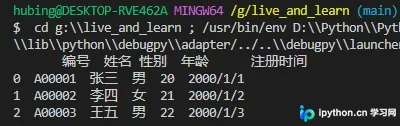
本文介绍如何使用Python的pandas库导入CSV文件。涵盖默认导入、指定分隔符(sep)、限制读取行数(nrows)以及处理编码格式(encoding)等关键参数。同时提供解决中文列标题对齐问题的set_option方法,帮助开发者高效处理不同格式的CSV数据。
本文深入解析Python中OpenCV库的Sobel与Laplacian算子,详细讲解图像锐化与边缘检测原理。通过Sobel()和Laplacian()函数原型说明、参数解析及完整代码示例,展示如何结合高斯滤波与阈值处理进行边缘提取,并对比Roberts、Prewitt等算法效果,为图像识别提供基础技术支持。
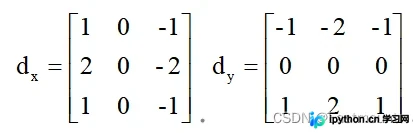
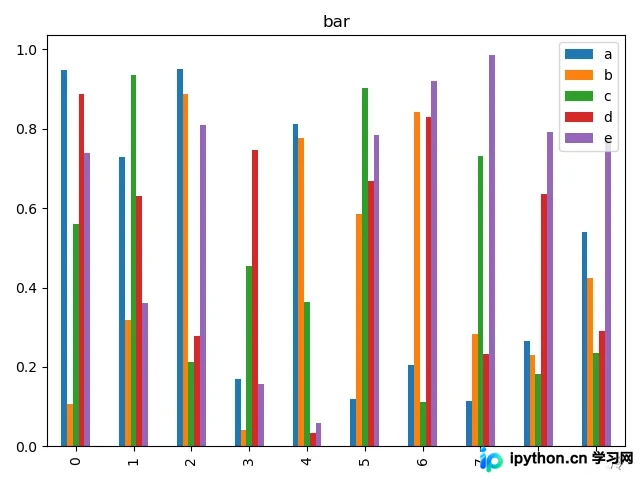
本文深入解析Pandas内置的多种数据可视化函数,涵盖条形图、折线图、面积图、箱线图、直方图、饼图及散点图等核心类型。通过具体代码示例,展示如何调用line、bar、box、hist等接口,并详解透明度、子图布局及六边形分箱等高级参数的应用,帮助开发者高效实现数据分布特征的直观呈现。
本文深入解析Python中if __name__ == '__main__'的作用机制。通过单文件与多文件示例,阐明直接运行与模块导入时__name__值的差异,展示如何利用该结构隔离测试代码与业务逻辑,避免导入时的意外执行,提升代码复用性与工程规范性。
本文深入解析Python装饰器的运行机制,从基础语法到带参装饰器及类实现方式逐步展开。通过代码示例阐明装饰器本质是函数嵌套与闭包的应用,解释__call__方法在类装饰器中的作用,并对比不同实现方式的优劣,帮助开发者掌握装饰器的核心技巧与最佳实践。
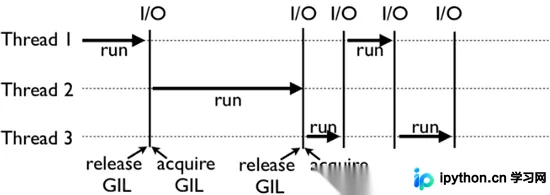
本文深入解析Python CPython解释器中的全局解释器锁(GIL)机制,阐述其产生的内存管理背景及对多线程的影响。通过对比计算密集型与IO密集型任务在多进程和多线程下的执行耗时,揭示GIL对CPU多核利用率的限制,并给出针对不同类型任务的并发编程建议。