Python爬虫基础:深入解析HTTP协议结构与工作流程
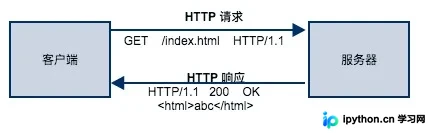
本文详解HTTP协议在Python爬虫中的核心作用,剖析HTTP请求(请求行、首部、体)与响应(状态码、首部、体)的标准格式,并通过Socket模块模拟真实通信过程,帮助开发者掌握爬虫底层原理。
2026-10-13
7

本文详解HTTP协议在Python爬虫中的核心作用,剖析HTTP请求(请求行、首部、体)与响应(状态码、首部、体)的标准格式,并通过Socket模块模拟真实通信过程,帮助开发者掌握爬虫底层原理。
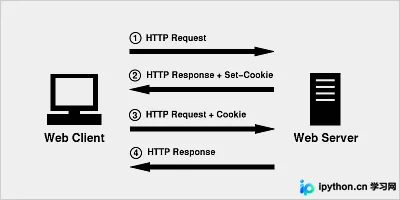
本文详解如何利用Python爬虫模拟知乎登录。通过解析HTTP Cookie机制,使用requests库的session对象自动管理Cookie,结合BeautifulSoup提取_xsrf令牌,并调用接口获取验证码,实现自动登录流程。代码示例展示了从加载本地Cookie到提交登录请求的完整逻辑,帮助开发者掌握动态网页抓取中的身份验证技巧。
本文详细介绍如何在Python中通过PyMySQL模块连接MySQL数据库。涵盖pip安装方法、本地数据库连接配置,以及执行SQL语句进行数据查询、插入、更新、删除和字段修改的具体代码示例。同时包含事务处理机制及动态列管理的实战案例,帮助开发者快速掌握Python操作数据库的核心技能。
本文介绍如何利用Anaconda发行版解决Python 2与Python 3共存开发的难题。通过Anaconda提供的包管理和虚拟环境功能,开发者可以方便地在不同Python版本间切换,并解决Windows平台下第三方库安装失败的问题。文章涵盖Anaconda下载、conda命令使用、国内镜像源配置等实用步骤。
本文介绍了使用Python随机读取指定文件夹下文件的具体实现方法。通过os.walk遍历目录获取文件列表,并利用random模块随机选取其中一个文件路径。文中提供了完整代码示例,并强调了Python3.5环境测试通过及rootdir参数需根据实际目录修改的注意事项,旨在帮助开发者快速掌握该技巧。
本文详细解析Django ORM中get与filter方法的差异。get返回单个对象,无匹配或多结果时报错;filter返回列表,无匹配返回空列表。文章通过代码示例对比两者在关联查询及性能表现上的不同,帮助开发者根据场景选择合适方法。
本文介绍了Python中常用的加密模块,包括md5、sha和crypt模块。详细讲解了各模块的核心函数用法及参数说明,并通过具体代码示例展示了摘要生成和更新过程。此外,提供了多种在线加密解密工具链接,供开发者参考使用。
本文详细解析Python中配置logging模块的三种方式:通过代码显式创建、使用配置文件配合fileConfig()函数,以及利用字典配置结合dictConfig()函数。重点讲解了配置文件与字典的配置格式规范、参数含义及propagate属性的作用,帮助开发者灵活选择适合项目的日志管理方案。
本文详细介绍如何在Python中使用xml.dom.minidom模块解析XML文件。内容涵盖XML基本概念、节点类型判断、获取标签属性值、提取子标签及标签内数据的方法,并提供完整代码示例演示如何遍历节点并输出用户信息,帮助开发者掌握XML数据处理的核心技巧。
本文介绍Python中生成8位随机密码的两种常用方法。第一种通过自定义包含数字、字母及特殊字符的种子字符串,利用random.choice逐个选取字符拼接;第二种直接调用string模块中的ascii_letters和digits,使用random.sample生成不重复字符组合。文中附带在线工具推荐及Python相关教程链接,供开发者参考使用。
本文介绍如何使用Python和Perl脚本过滤包含“Alignment”关键字的文本块。规则为:仅保留包含20行或以上内容的Alignment区块,不足20行的区块将被丢弃。文章提供了完整的Python和Perl代码示例,适用于生物信息学等需要处理大规模对齐数据的场景。
本文针对Python标准库及dateutil模块在计算两个日期相差月数时存在的精度或功能缺失问题,提供了一套自定义解决方案。通过对比rrule模块的测试结果,展示了手动处理大小月及闰年差异的方法,最终实现返回整数月与小数月的精确计算结果。