

Python使用*解包和itertools.product()求笛卡尔积
本文介绍在Python中如何结合*解包技巧与itertools.product()函数来计算两个列表的笛卡尔积。通过eval()解析字符串后,利用*操作符将元组参数解包传入product函数,从而解决直接传参报错的问题,并总结相关核心技巧。
2026-10-13
7

本文介绍在Python中如何结合*解包技巧与itertools.product()函数来计算两个列表的笛卡尔积。通过eval()解析字符串后,利用*操作符将元组参数解包传入product函数,从而解决直接传参报错的问题,并总结相关核心技巧。
本文介绍了在Python中实现简单进度条的两种方法。首先展示了基于循环的同步进度条示例,包括固定百分比和周期加载两种形式。随后提供了一种异步进度条的封装类,支持在耗时操作前后通过start和stop方法进行开启与停止,适用于需要非阻塞显示的异步场景。
本文介绍使用 Python 3.5 检测路由器流量并保存至 txt 文件的简单方法。重点解决网页编码识别(如 ISO-8859-1)及 bytes 转 str 的问题,演示利用 chardet 库、split 截取字符串及 open 函数处理换行符的技巧,适合初学者参考。
本文介绍了一个仅4KB的Python轻量级库,用于获取连接的Android设备详细信息。该库通过封装ADB命令,自动检查环境变量并解析设备状态,返回包含品牌、型号、系统版本等字段的JSON格式列表。相比大型库,它更简洁且满足基础项目需求,适合需要快速集成设备管理功能的开发者。
本文深入解析Python中列表与元组的区别。虽然两者语法相似,但核心差异在于可变性与设计意图:列表用于存储同质、可变的序列,而元组用于存储异构、不可变的数据结构。通过代码示例说明如何在字典键、日期对象及具名元组中合理选择数据类型,提升代码语义清晰度与安全性。
本文介绍如何使用Python3编写程序计算三角形面积。通过获取用户输入的三边长度,利用海伦公式计算半周长及面积,并输出保留两位小数的结果。代码包含完整的输入处理与数学运算逻辑,适合Python初学者参考学习。
本文详细解析Python3中str、bytes和bytearray三种数据类型的区别与联系。重点讲解str与bytes之间的encode/decode及构造函数转换方式,深入剖析bytearray作为可变字节序列的初始化参数规则及常用操作方法,并对比bytes不可变与bytearray可变的特性,提供完整的类型间转换示例。
本文详解Django模板中{% include %}标签的用法,解决网页公共头部与底部的复用问题。通过视图传递上下文变量及利用with语法动态指定参数,实现不同页面头部样式的灵活切换,避免代码冗余。
本文详解Python中CSV文件的读取与写入方法。通过鸢尾花数据集示例,演示如何将CSV直接转换为Dict列表或DataFrame对象。针对大数据量场景,提供逐条处理并写入的建议,以及使用writerows批量写入的技巧。此外,还涵盖从Zip压缩包中直接读取CSV、DataFrame导出CSV以及TXT文件转换等实用代码片段,帮助开发者高效处理结构化数据。
本文详细介绍NumPy数组的排序方法与集合运算技巧。通过sort与np.sort的区别、axis参数应用及分位数计算,解析排序核心用法;结合unique、intersect1d、union1d等函数,演示集合去重、交集、并集及差集操作,助力高效数据处理。
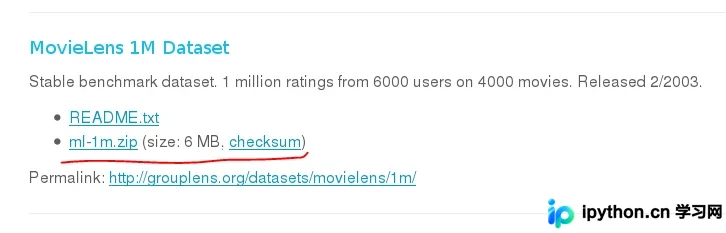
本文详细介绍基于Python的协同过滤推荐算法实现。涵盖基于用户和基于物品两种核心模式,通过MovieLens数据集演示数据预处理、相似度计算及推荐生成全过程。提供完整代码示例,展示如何从原始评分数据构建用户-物品矩阵,计算余弦相似度,并生成个性化电影推荐列表及准确率评估。
本文详解如何利用NumPy实现一维与二维数组的拼接。重点解析shape为(3,)的一维数组与(3,1)二维数组的区别,并通过np.newaxis将一维数组升维,配合concatenate、hstack等函数完成拼接操作,提供完整代码示例。