

Python实现协同过滤推荐算法:完整代码与流程解析

本文详细介绍基于Python的协同过滤推荐算法实现。涵盖基于用户和基于物品两种核心模式,通过MovieLens数据集演示数据预处理、相似度计算及推荐生成全过程。提供完整代码示例,展示如何从原始评分数据构建用户-物品矩阵,计算余弦相似度,并生成个性化电影推荐列表及准确率评估。
测试数据
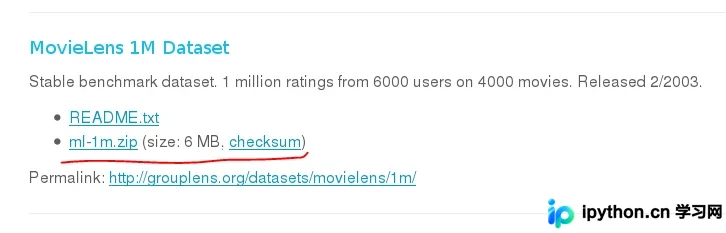
数据来源地址:http://grouplens.org/datasets/movielens/
协同过滤推荐算法主要包含以下两种类型:
1、基于用户的协同过滤。该方法通过寻找与当前用户兴趣相似的邻近用户,预测当前用户尚未接触且未表达偏好的物品,进而计算出一个排序后的物品列表进行推荐。
2、基于物品的协同过滤。例如,若发现喜欢物品A的用户通常也喜欢物品C,则可推断物品A与物品C之间存在高相似度。若用户C喜欢物品A,则推测用户C也可能对物品C感兴趣。
尽管不同数据源和开发者编写的协同过滤算法在实现细节上存在差异,但其核心逻辑保持一致:
1、收集用户的偏好信息
1) 对不同行为类型进行分组处理
2) 对各分组进行加权计算,得出用户的总体喜好
3) 对数据进行去噪和归一化处理
2、寻找相似用户(基于用户的方法)或相似物品(基于物品的方法)
3、计算相似度并进行排序。根据计算出的相似度为用户生成推荐列表。
本次实例的具体执行过程如下:
1、初始化数据
获取movies(电影信息)和ratings(评分数据)。
将数据转换为userDict,表示某个用户对所有电影的评分集合,并将评分除以5进行归一化处理。
将数据转换为ItemUser,表示参与某部电影评分的所有用户集合。
2、计算所有用户与指定userId的相似度
找出所有观看电影与userId有交集的用户。
对这些用户循环计算与userId的相似度。
获取A用户与userId的并集,格式为:{'电影ID',[A用户的评分,userId的评分]},若某用户未对某电影评分,则记为0。
计算A用户与userId的余弦距离,距离越大表示越相似。
3、根据相似度生成推荐电影列表
4、输出推荐列表和准确率
#!/usr/bin/python3
# -*- coding: utf-8 -*-
from numpy import *
import time
from texttable import Texttable
class CF:
  def __init__(self, movies, ratings, k=5, n=10):
    self.movies = movies
    self.ratings = ratings
    # 邻居个数
    self.k = k
    # 推荐个数
    self.n = n
    # 用户对电影的评分
    # 数据格式{'UserID:用户ID':[(MovieID:电影ID,Rating:用户对电影的评星)]}
    self.userDict = {}
    # 对某电影评分的用户
    # 数据格式:{'MovieID:电影ID',[UserID:用户ID]}
    # {'1',[1,2,3..],...}
    self.ItemUser = {}
    # 邻居的信息
    self.neighbors = []
    # 推荐列表
    self.recommandList = []
    self.cost = 0.0

  # 基于用户的推荐
  # 根据对电影的评分计算用户之间的相似度
  def recommendByUser(self, userId):
    self.formatRate()
    # 推荐个数 等于 本身评分电影个数,用户计算准确率
    self.n = len(self.userDict[userId])
    self.getNearestNeighbor(userId)
    self.getrecommandList(userId)
    self.getPrecision(userId)

  # 获取推荐列表
  def getrecommandList(self, userId):
    self.recommandList = []
    # 建立推荐字典
    recommandDict = {}
    for neighbor in self.neighbors:
      movies = self.userDict[neighbor[1]]
      for movie in movies:
        if(movie[0] in recommandDict):
          recommandDict[movie[0]] += neighbor[0]
        else:
          recommandDict[movie[0]] = neighbor[0]

    # 建立推荐列表
    for key in recommandDict:
      self.recommandList.append([recommandDict[key], key])
    self.recommandList.sort(reverse=True)
    self.recommandList = self.recommandList[:self.n]

  # 将ratings转换为userDict和ItemUser
  def formatRate(self):
    self.userDict = {}
    self.ItemUser = {}
    for i in self.ratings:
      # 评分最高为5 除以5 进行数据归一化
      temp = (i[1], float(i[2]) / 5)
      # 计算userDict {'1':[(1,5),(2,5)...],'2':[...]...}
      if(i[0] in self.userDict):
        self.userDict[i[0]].append(temp)
      else:
        self.userDict[i[0]] = [temp]
      # 计算ItemUser {'1',[1,2,3..],...}
      if(i[1] in self.ItemUser):
        self.ItemUser[i[1]].append(i[0])
      else:
        self.ItemUser[i[1]] = [i[0]]

  # 找到某用户的相邻用户
  def getNearestNeighbor(self, userId):
    neighbors = []
    self.neighbors = []
    # 获取userId评分的电影都有那些用户也评过分
    for i in self.userDict[userId]:
      for j in self.ItemUser[i[0]]:
        if(j != userId and j not in neighbors):
          neighbors.append(j)
    # 计算这些用户与userId的相似度并排序
    for i in neighbors:
      dist = self.getCost(userId, i)
      self.neighbors.append([dist, i])
    # 排序默认是升序,reverse=True表示降序
    self.neighbors.sort(reverse=True)
    self.neighbors = self.neighbors[:self.k]

  # 格式化userDict数据
  def formatuserDict(self, userId, l):
    user = {}
    for i in self.userDict[userId]:
      user[i[0]] = [i[1], 0]
    for j in self.userDict[l]:
      if(j[0] not in user):
        user[j[0]] = [0, j[1]]
      else:
        user[j[0]][1] = j[1]
    return user

  # 计算余弦距离
  def getCost(self, userId, l):
    # 获取用户userId和l评分电影的并集
    # {'电影ID':[userId的评分,l的评分]} 没有评分为0
    user = self.formatuserDict(userId, l)
    x = 0.0
    y = 0.0
    z = 0.0
    for k, v in user.items():
      x += float(v[0]) * float(v[0])
      y += float(v[1]) * float(v[1])
      z += float(v[0]) * float(v[1])
    if(z == 0.0):
      return 0
    return z / sqrt(x * y)

  # 推荐的准确率
  def getPrecision(self, userId):
    user = [i[0] for i in self.userDict[userId]]
    recommand = [i[1] for i in self.recommandList]
    count = 0.0
    if(len(user) >= len(recommand)):
      for i in recommand:
        if(i in user):
          count += 1.0
      self.cost = count / len(recommand)
    else:
      for i in user:
        if(i in recommand):
          count += 1.0
      self.cost = count / len(user)

  # 显示推荐列表
  def showTable(self):
    neighbors_id = [i[1] for i in self.neighbors]
    table = Texttable()
    table.set_deco(Texttable.HEADER)
    table.set_cols_dtype(["t", "t", "t", "t"])
    table.set_cols_align(["l", "l", "l", "l"])
    rows = []
    rows.append([u"movie ID", u"Name", u"release", u"from userID"])
    for item in self.recommandList:
      fromID = []
      for i in self.movies:
        if i[0] == item[1]:
          movie = i
          break
      for i in self.ItemUser[item[1]]:
        if i in neighbors_id:
          fromID.append(i)
      movie.append(fromID)
      rows.append(movie)
    table.add_rows(rows)
    print(table.draw())
# 获取数据
def readFile(filename):
  files = open(filename, "r", encoding="utf-8")
  # 如果读取不成功试一下
  # files = open(filename, "r", encoding="iso-8859-15")
  data = []
  for line in files.readlines():
    item = line.strip().split("::")
    data.append(item)
  return data

# -------------------------开始-------------------------------
start = time.clock()
movies = readFile("/home/hadoop/Python/CF/movies.dat")
ratings = readFile("/home/hadoop/Python/CF/ratings.dat")
demo = CF(movies, ratings, k=20)
demo.recommendByUser("100")
print("推荐列表为:")
demo.showTable()
print("处理的数据为%d条" % (len(demo.ratings)))
print("准确率: %.2f %%" % (demo.cost * 100))
end = time.clock()
print("耗费时间: %f s" % (end - start))
总结
以上就是本文关于python实现协同过滤推荐算法完整代码示例的全部内容,希望对大家有所帮助。感兴趣的朋友可以继续参阅本站:
python实现机械分词之逆向最大匹配算法代码示例
K-近邻算法的python实现代码分享
详解K-means算法在Python中的实现
如有不足之处,欢迎留言指出。感谢朋友们对本站的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









