

Python实现线性回归与批量梯度下降法完整示例
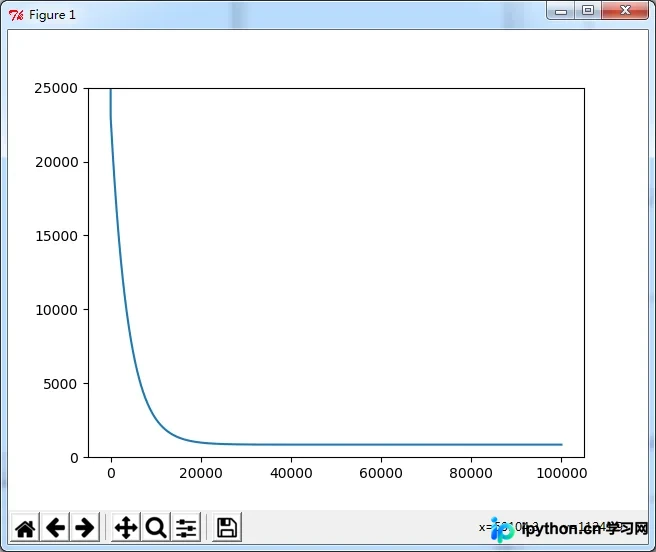
本文详细介绍如何使用Python实现线性回归及批量梯度下降算法。通过自定义dataMinning类,演示了数据读取、模型训练及参数更新过程。文章包含误差迭代曲线与数据散点拟合直线的可视化代码,帮助开发者理解批量梯度下降在简单线性回归中的应用与实现细节。
2026-10-13
7

本文详细介绍如何使用Python实现线性回归及批量梯度下降算法。通过自定义dataMinning类,演示了数据读取、模型训练及参数更新过程。文章包含误差迭代曲线与数据散点拟合直线的可视化代码,帮助开发者理解批量梯度下降在简单线性回归中的应用与实现细节。
本文详细介绍如何利用Python的itchat库开发微信个人号机器人。内容涵盖库的安装、网页版登录及断线重连配置,演示文本、图片等消息发送方法,并结合图灵机器人API实现好友私聊与指定群聊的自动回复功能,提供完整代码示例。
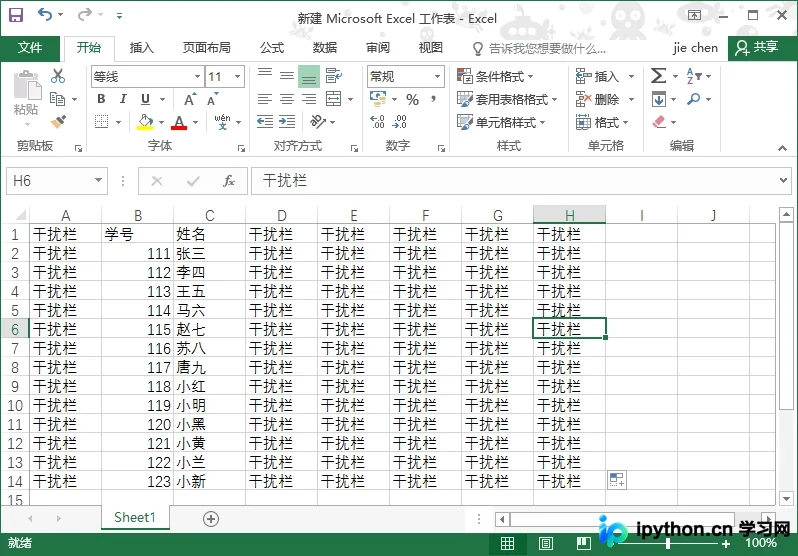
本文介绍如何使用Python的xlwt和xlrd库读取Excel文件中的学生学号与姓名,并通过random模块生成随机考试成绩。文章详细讲解了行列索引从0开始计数的规则,演示了如何提取指定范围数据、创建新工作表并将学号、姓名及随机生成的成绩写入新的Excel文件,最后保存为指定格式。
本文介绍如何使用Python实现二叉树的层序遍历,按层级从上到下、同一层从左至右打印节点值。通过维护当前层节点队列并逐层处理,确保每行输出对应一层的所有节点。代码包含节点类定义及核心遍历逻辑,适合需要二叉树可视化或层级数据处理的技术场景。
本文通过Python单线程Socket示例展示Server与Client的数据收发机制,解析端口监听与连接处理逻辑。结合Linux环境下利用lsof命令排查占用端口进程的方法,帮助开发者理解Socket基础语法及调试技巧,适用于Python初学者及需要快速验证网络通信场景的开发人员。
本文分享了一个使用Python编写的简易云音乐播放器项目。项目基于Tkinter构建图形界面,利用网易云音乐公开接口实现歌曲搜索,并结合第三方汉字转拼音库优化搜索体验。文中提供了完整源码,并指出了当前版本在歌曲切换时存在的一个已知BUG,旨在为Python初学者提供实战参考。
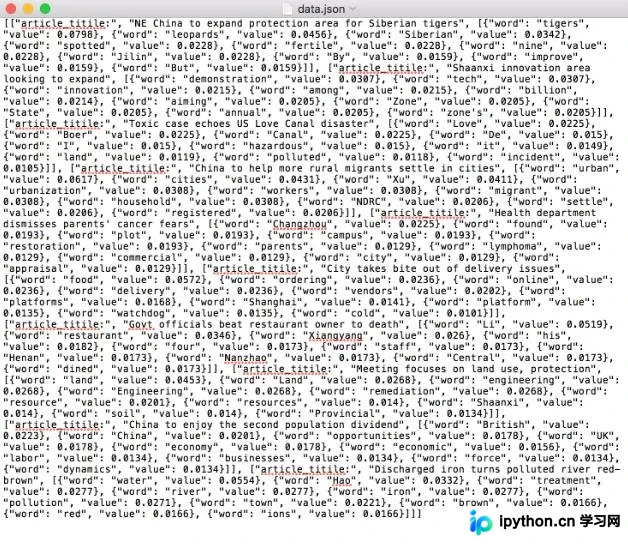
本文介绍如何使用Python编写爬虫程序,从ChinaDaily抓取十篇新闻文章。通过BeautifulSoup解析HTML获取标题与正文,结合TF-IDF算法计算每篇文章的高频关键词。最终将结果以JSON格式保存,并提供在线查看工具及GitHub源码链接,适合初学者学习网络抓取与文本分析基础。
本文详解使用Python标准库urllib和第三方库BeautifulSoup4构建简易Web爬虫的方法。文章涵盖爬虫核心流程、URL管理器、HTML下载器与解析器、索引构建及主程序逻辑,通过具体代码示例展示如何抓取网页标题并建立关键词索引,适合Python初学者理解爬虫原理。
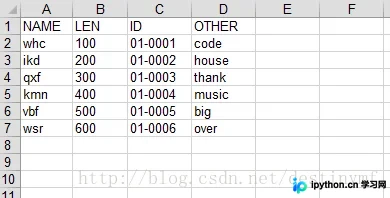
本文介绍如何利用Python结合xlwt库,将JSON文件中的字典列表数据批量写入固定格式的Excel表格。通过遍历JSON键值对,按列对齐写入数据,实现自动化处理,避免手动复制粘贴的繁琐操作,适用于Windows7及Python2.7环境。
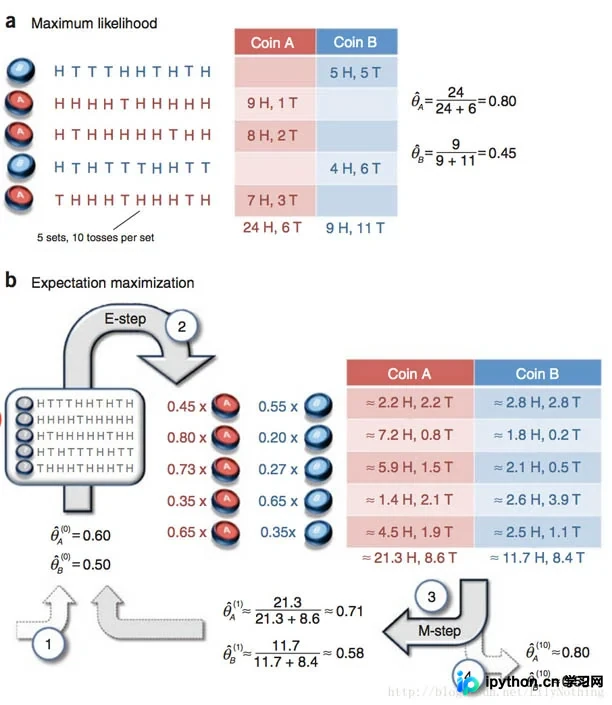
本文通过双硬币抛掷实验,详细讲解EM算法在Python中的具体实现步骤。涵盖从数据构建、参数初始化、E步概率计算到M步参数更新的完整流程,并分析不同初始值对算法收敛性及结果的影响,帮助读者深入理解期望最大化算法的核心逻辑。
本文详细解析使用Python实现简单遗传算法的全过程。通过模拟生物进化机制,包括编码、适应度评估、轮盘赌选择、交叉变异等步骤,求解函数y=10sin(5x)+7cos(4x)的最大值。文章提供完整代码逻辑与参数设置说明,适合AI入门及算法学习者参考。
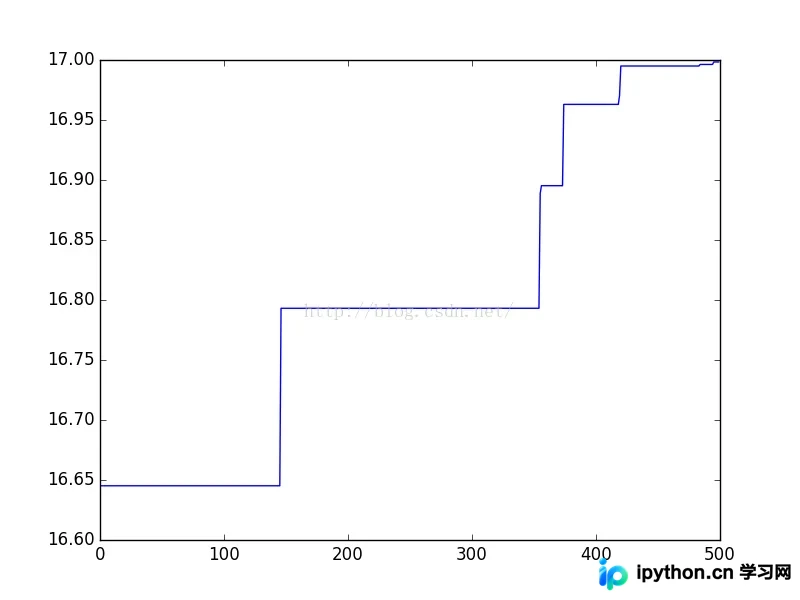
本文介绍使用Python脚本自动化合并多个Excel文件至单一工作表的方法,替代手动复制粘贴。通过遍历指定目录下的所有Excel文件,读取指定行范围的数据并写入目标文件result.xls。代码包含路径输入、行列处理及格式保存逻辑,适用于批量数据整理场景。