

Python实现简单遗传算法详解:从原理到代码实战

本文详细解析使用Python实现简单遗传算法的全过程。通过模拟生物进化机制,包括编码、适应度评估、轮盘赌选择、交叉变异等步骤,求解函数y=10sin(5x)+7cos(4x)的最大值。文章提供完整代码逻辑与参数设置说明,适合AI入门及算法学习者参考。
在整理过往代码时,发现数模竞赛期间编写的基于Python的遗传算法实现颇具价值,特此分享。
遗传算法是一种模拟基因优胜劣汰机制的优化算法,核心流程涵盖初始化编码、个体评价、选择、交叉与变异环节。
遗传算法概述
该算法通过模拟自然界生物进化过程来解决问题。经过多代自然选择后,适应环境的种群得以保留。将问题的所有解视为一个种群,经过多次选择后,剩余解中包含最优解的概率极高。本文旨在利用遗传算法求解特定函数的最大值。
目标函数为 f(x) = 10 * sin( 5x ) + 7 * cos( 4x ),定义域为 0 <= x <= 10。
第一步:对自变量x进行编码处理。
设定基因片段长度为10,10位二进制数可表示0至1023的范围。基因转换为自变量的公式为 x = b2d(individual) * 10 / 1023。构建初始种群pop,其中每个个体的基因初始值设定为[0, 1, 0, 1, 0, 1, 0, 1, 0, 1]。
第二步:计算目标函数值。
依据自变量与基因的转换关系,计算每个个体基因对应的自变量值,并将其代入函数f(x),从而得出每个个体的目标函数值。
第三步:定义适应度函数。
适应度函数用于评估个体对环境的适应能力,是自然选择的依据。本题中,适应度函数将目标函数值的负数部分归零。由于目标是求最大值,负值对应的个体被视为不适应环境,其繁殖后代的能力设为0。适应度函数的作用将在后续自然选择中体现。
第四步:执行自然选择。
自然选择的具体原理不再赘述,本例采用轮盘赌算法进行操作。具体步骤如下:
假设种群包含5个个体,适应度函数计算出的适应性列表为 fitvalue = [1, 3, 0, 2, 4],总和 totalvalue = 10。若将fitvalue映射到圆盘上,数值大小对应圆盘面积。轮盘转动时,面积越大被选中的概率越高。具体操作是将fitvalue转化为累积概率列表 [1, 4, 4, 6, 10],计算 fitvalue / totalvalue 得到 [0.1, 0.4, 0.4, 0.6, 1.0]。生成5个0到1之间的随机数并从小到大排序,例如 [0.05, 0.2, 0.7, 0.8, 0.9]。根据随机数区间,分别选取0号、1号、4号、4号、4号个体拷贝至新种群。自然选择的结果使种群更符合优化条件。
第五步:进行繁殖(交叉)。
假设个体a和b的基因序列如下:
a = [1, 0, 0, 0, 0, 1, 1, 1, 0, 0] b = [0, 0, 0, 1, 1, 0, 1, 1, 1, 1]
设定两个个体发生基因交换的概率 pc = 0.6。若触发交换,则生成一个随机数point表示交换位置,假设 point = 4,则:
a = [1, 0, 0, 0, 0, 1, 1, 1, 0, 0] b = [0, 0, 0, 1, 1, 0, 1, 1, 1, 1]
交换后的结果为:
a = [1, 0, 0, 0, 1, 0, 1, 1, 1, 1] b = [0, 0, 0, 1, 0, 1, 1, 1, 0, 0]
第六步:执行突变。
遍历每个个体,基因每一位发生突变(0变1或1变0)的概率为0.001。突变操作有助于增加解空间的多样性。
以目标式子 y = 10 * sin(5x) + 7 * cos(4x) 为例,计算其最大值。
初始化阶段包括设定具体计算公式、种群数量、染色体长度、交配概率及变异概率等参数,并对基因序列进行初始化。
pop_size = 500  # 种群数量
max_value = 10  # 基因中允许出现的最大值
chrom_length = 10  # 染色体长度
pc = 0.6   # 交配概率
pm = 0.01   # 变异概率
results = [[]]  # 存储每一代的最优解,N个二元组
fit_value = []  # 个体适应度
fit_mean = []  # 平均适应度
pop = geneEncoding(pop_size, chrom_length)
其中 genEncodeing 是自定义的生成随机序列函数,具体实现如下:
def geneEncoding(pop_size, chrom_length):
 pop = [[]]
 for i in range(pop_size):
  temp = []
  for j in range(chrom_length):
   temp.append(random.randint(0, 1))
  pop.append(temp)
 return pop[1:]
编码完成后进行个体评价,主要计算各编码列表的值及其代入目标式子的结果。编码结果为一堆二进制列表,每个列表代表一个数值。计算方法为将其转换为十进制,再除以2的序列长度次方减一(即全1列表的十进制值减一)。据此规则计算所有列表的值及目标函数值,代码如下:
# 0.0 coding:utf-8 0.0
# 解码并计算值
import math
def decodechrom(pop, chrom_length):
 temp = []
 for i in range(len(pop)):
  t = 0
  for j in range(chrom_length):
   t += pop[i][j] * (math.pow(2, j))
  temp.append(t)
 return temp


def calobjValue(pop, chrom_length, max_value):
 temp1 = []
 obj_value = []
 temp1 = decodechrom(pop, chrom_length)
 for i in range(len(temp1)):
  x = temp1[i] * max_value / (math.pow(2, chrom_length) - 1)
  obj_value.append(10 * math.sin(5 * x) + 7 * math.cos(4 * x))
 return obj_value
获得具体数值与对应基因序列后,进行一轮淘汰,旨在剔除不可能的劣质解。由于计算最大值,此处直接淘汰负值即可。
# 0.0 coding:utf-8 0.0
# 淘汰(去除负值)
def calfitValue(obj_value):
 fit_value = []
 c_min = 0
 for i in range(len(obj_value)):
  if(obj_value[i] + c_min > 0):
   temp = c_min + obj_value[i]
  else:
   temp = 0.0
  fit_value.append(temp)
 return fit_value
随后进行选择操作,这是遗传算法的核心部分。选择模拟生物进化的优胜劣汰,使优秀个体尽可能存活,劣质个体被淘汰。个体优劣取决于适应度,适应度越高越易保留,反之则易被淘汰。具体代码如下:
# 0.0 coding:utf-8 0.0
# 选择
import random
def sum(fit_value):
 total = 0
 for i in range(len(fit_value)):
  total += fit_value[i]
 return total
def cumsum(fit_value):
 for i in range(len(fit_value)-2, -1, -1):
  t = 0
  j = 0
  while(j <= i):
   t += fit_value[j]
   j += 1
  fit_value[i] = t
  fit_value[len(fit_value)-1] = 1
def selection(pop, fit_value):
 newfit_value = []
 # 适应度总和
 total_fit = sum(fit_value)
 for i in range(len(fit_value)):
  newfit_value.append(fit_value[i] / total_fit)
 # 计算累计概率
 cumsum(newfit_value)
 ms = []
 pop_len = len(pop)
 for i in range(pop_len):
  ms.append(random.random())
 ms.sort()
 fitin = 0
 newin = 0
 newpop = pop
 # 转轮盘选择法
 while newin < pop_len:
  if(ms[newin] < newfit_value[fitin]):
   newpop[newin] = pop[fitin]
   newin = newin + 1
  else:
   fitin = fitin + 1
 pop = newpop
上述代码主要执行三个操作:首先计算个体适应度总和,其次计算各自的累积适应度。这两步较为直观。关键在于第三步转轮盘选择法:生成与基因总数相等的0到1之间的小数,并与各基因的累积适应度比较。若累积适应度大于随机数则保留,否则淘汰。核心思想在于:个体适应度越高,其占据的累计适应度区间越大,被保留的概率也就越高。
选择完成后进行交配和变异,这两个步骤旨在改变基因序列,但改变方式不同。
交配过程:
# 0.0 coding:utf-8 0.0
# 交配
import random
def crossover(pop, pc):
 pop_len = len(pop)
 for i in range(pop_len - 1):
  if(random.random() < pc):
   cpoint = random.randint(0,len(pop[0]))
   temp1 = []
   temp2 = []
   temp1.extend(pop[i][0:cpoint])
   temp1.extend(pop[i+1][cpoint:len(pop[i])])
   temp2.extend(pop[i+1][0:cpoint])
   temp2.extend(pop[i][cpoint:len(pop[i])])
   pop[i] = temp1
   pop[i+1] = temp2
变异过程:
# 0.0 coding:utf-8 0.0
# 基因突变
import random
def mutation(pop, pm):
 px = len(pop)
 py = len(pop[0])
 for i in range(px):
  if(random.random() < pm):
   mpoint = random.randint(0, py-1)
   if(pop[i][mpoint] == 1):
    pop[i][mpoint] = 0
   else:
    pop[i][mpoint] = 1
遗传算法实现完毕,总调用入口代码如下:
# 0.0 coding:utf-8 0.0
import matplotlib.pyplot as plt
import math
from calobjValue import calobjValue
from calfitValue import calfitValue
from selection import selection
from crossover import crossover
from mutation import mutation
from best import best
from geneEncoding import geneEncoding
print 'y = 10 * math.sin(5 * x) + 7 * math.cos(4 * x)'
# 计算2进制序列代表的数值
def b2d(b, max_value, chrom_length):
 t = 0
 for j in range(len(b)):
  t += b[j] * (math.pow(2, j))
 t = t * max_value / (math.pow(2, chrom_length) - 1)
 return t
pop_size = 500  # 种群数量
max_value = 10  # 基因中允许出现的最大值
chrom_length = 10  # 染色体长度
pc = 0.6   # 交配概率
pm = 0.01   # 变异概率
results = [[]]  # 存储每一代的最优解,N个二元组
fit_value = []  # 个体适应度
fit_mean = []  # 平均适应度
# pop = [[0, 1, 0, 1, 0, 1, 0, 1, 0, 1] for i in range(pop_size)]
pop = geneEncoding(pop_size, chrom_length)
for i in range(pop_size):
 obj_value = calobjValue(pop, chrom_length, max_value)  # 个体评价
 fit_value = calfitValue(obj_value)  # 淘汰
 best_individual, best_fit = best(pop, fit_value)  # 第一个存储最优的解, 第二个存储最优基因
 results.append([best_fit, b2d(best_individual, max_value, chrom_length)])
 selection(pop, fit_value)  # 新种群复制
 crossover(pop, pc)  # 交配
 mutation(pop, pm)  # 变异
results = results[1:]
results.sort()
X = []
Y = []
for i in range(500):
 X.append(i)
 t = results[i][0]
 Y.append(t)
plt.plot(X, Y)
plt.show()
最后调用 matplotlib 包,展示500代最优解的变化趋势。
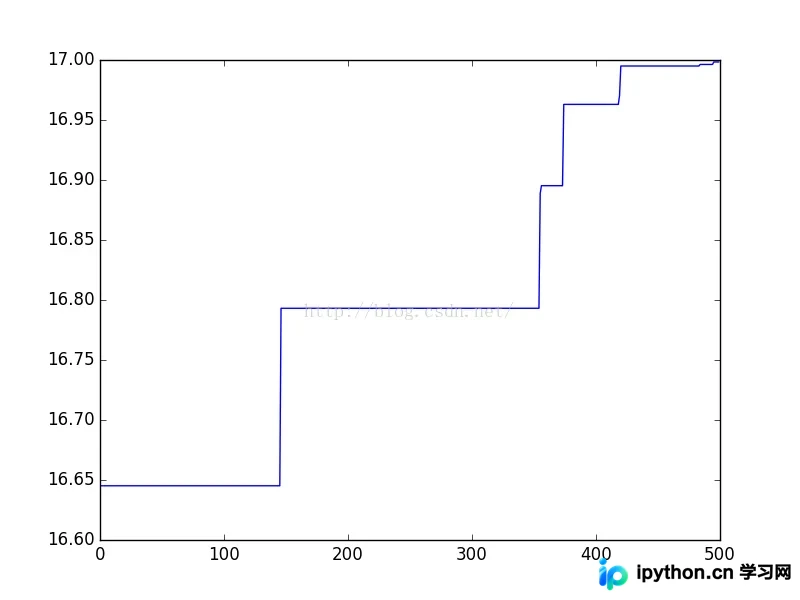
完整代码可在 GitHub 查看。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









