Python bytes类型详解:定义、与字符串区别及转换方法
本文详细介绍Python 3中的bytes类型,阐述其与str字符串在操作单元上的核心区别。通过示例演示了bytes对象的三种创建方式,包括b前缀、bytes()构造函数及encode()方法,并讲解了利用decode()将字节串还原为字符串的标准流程,适用于网络传输及二进制文件处理场景。
2026-10-15
7

本文详细介绍Python 3中的bytes类型,阐述其与str字符串在操作单元上的核心区别。通过示例演示了bytes对象的三种创建方式,包括b前缀、bytes()构造函数及encode()方法,并讲解了利用decode()将字节串还原为字符串的标准流程,适用于网络传输及二进制文件处理场景。
本文详细介绍如何使用PyInstaller将Python脚本打包为Windows可执行文件。涵盖PyInstaller原理、Windows环境下的安装方法、常用打包参数(如-F、-w、--icon)解析,以及生成.spec文件和处理常见报错(如TypeError)的解决方案,帮助开发者轻松发布Python应用。
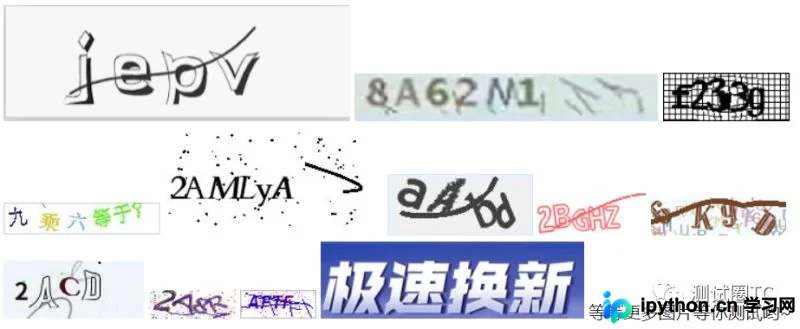
本文介绍Python通用验证码识别库ddddocr的使用。涵盖传统字符验证码、滑动验证码及文字点选验证码的识别方法与代码示例,分析其在自动化测试中的局限性,如坐标转换与操作顺序问题,为开发者提供实用的识别方案参考。
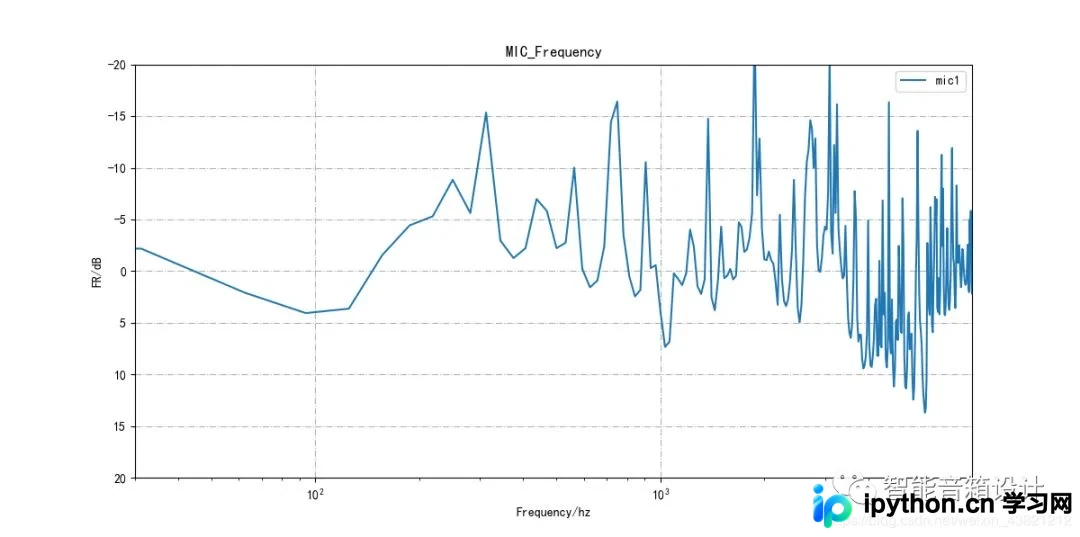
本文介绍在Python中使用Savitzky-Golay滤波器对高频波动曲线进行平滑处理的方法。通过scipy库调用savgol_filter函数,详细解析window_length和polyorder两个关键参数对拟合效果的影响。窗口长度决定平滑强度,多项式阶数影响拟合精度,合理设置参数可避免高频曲线失真或过度平滑。
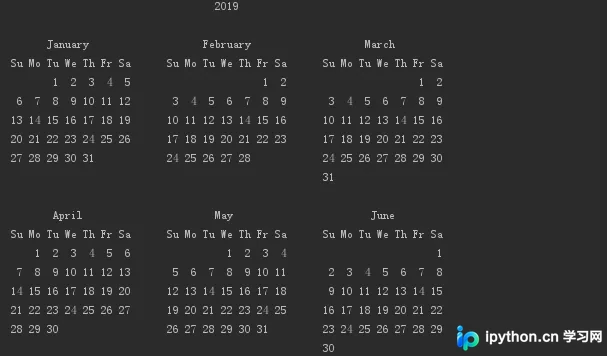
本文详解如何利用Python的openpyxl和calendar库自动化生成个性化爱豆日历。通过处理Excel工作簿、设置单元格样式及插入图片,实现12个月份的自动排版与生成,帮助开发者快速掌握表格自动化处理技巧。
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
本文介绍在Python中利用OpenCV库实现图片切割的具体方法。通过示例代码展示如何读取图像、计算行列尺寸并保存切割后的子图。同时对比了Pillow库可能存在的自动旋转问题,建议使用OpenCV以避免此类偏差。
本文介绍如何在Python中使用js2py库直接运行JavaScript代码。针对爬虫中常见的JS加密、混淆及动态接口返回JS变量等场景,详细讲解eval_js和EvalJs两种核心用法。通过提取JS对象属性和调用函数,实现从复杂JS代码中高效获取数据,解决传统正则或字符串解析的繁琐问题,满足90%日常爬虫需求。
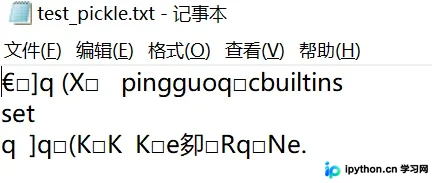
本文深入解析Python中pickle与JSON两大标准库的序列化机制。详细对比两者在数据类型支持、编码格式及多语言兼容性上的差异,重点讲解dumps/loads与dump/load函数的使用场景。针对JSON连续读写报错问题提供解决方案,并阐述pickle在Python内部数据持久化与JSON在跨语言数据交互中的最佳实践。
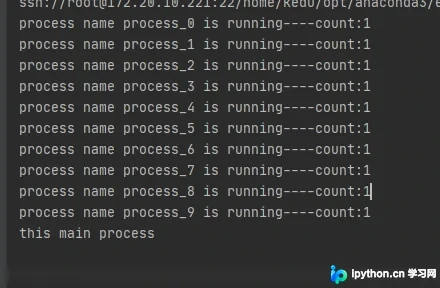
本文深入解析Python中multiprocessing模块的多进程实现方式,涵盖Process类重写run、target传参及直接调用三种用法。重点对比Queue与Pipe在进程间通信(IPC)中的性能差异与应用场景,并通过数据清洗、模型推理等实际案例,展示如何利用进程池与异步通信机制高效处理高并发任务。
本文详细解析Python中pickle与json序列化模块的区别与应用。pickle支持Python所有数据类型并生成字节流,适用于Python内部数据持久化;json仅支持八种基础类型并生成字符串,适用于多语言间数据交换。文章涵盖dumps/loads与dump/load的使用场景、参数配置及连续读写问题的解决方案。
本文详细介绍Python中pickle模块的功能,涵盖dumps、loads、dump和load四个核心方法的使用示例。文章对比了pickle与JSON在格式、兼容性及安全性上的差异,并列举了可被序列化的数据类型。重点强调pickle处理非信任数据时的安全风险,建议开发者谨慎使用。