TensorFlow 使用 flags 定义命令行参数的方法
本文介绍如何利用 TensorFlow 的 tf.app.flags 模块定义和解析命令行参数。通过 DEFINE_string、DEFINE_integer 和 DEFINE_boolean 等方法,开发者可以灵活接收外部输入并设置默认值。文章包含完整的代码示例及运行结果演示,帮助理解如何在模型训练或部署脚本中高效管理配置项。
2026-10-13
11

本文介绍如何利用 TensorFlow 的 tf.app.flags 模块定义和解析命令行参数。通过 DEFINE_string、DEFINE_integer 和 DEFINE_boolean 等方法,开发者可以灵活接收外部输入并设置默认值。文章包含完整的代码示例及运行结果演示,帮助理解如何在模型训练或部署脚本中高效管理配置项。
本文介绍了在Python中利用os.path模块获取文件路径、文件名及后缀名的具体实现方法。通过os.path.split分离路径与文件名,再使用os.path.splitext提取主名与扩展名,从而完整解析文件信息。
本文介绍如何利用Python的xlsxwriter库实现Excel文件的自定义写入。通过两个实例,分别演示了将数据框按指定顺序和格式写入Excel表格,以及自动生成包含柱状图的自动报表。内容涵盖单元格格式化、数据写入及图表配置等核心操作,帮助开发者高效处理Excel数据输出任务。
本文总结Python读取TXT文件的两种常见场景:数值型数据处理与文本情感分类。针对数组运算中常见的字符串类型报错,提供将元素强制转换为float的解决方案;同时展示如何利用正则表达式删除电影评论数据集中的多余符号,并结合文件遍历实现大规模文本数据的预处理与分类存储。
本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。
本文介绍如何使用Python和numpy库读取文本文件并将其转换为矩阵。详细解析了字符串处理、类型转换及矩阵构造过程,并针对大规模数据场景提供了稀疏矩阵的替代方案与内存优化建议,帮助开发者避免MemoryError。
本文基于 Python 3.6 环境,演示了三种常见的文件操作场景:保持格式复制文件、读取内容并返回列表(适用于加载本地词典库),以及直接读取文件字符串。代码示例展示了如何处理 UTF-8 编码及去除 BOM 字符,为开发者提供实用的文件处理工具模块参考。
本文介绍在CentOS7.3.1611_x64系统Python 2.7.5环境下,如何高效批量替换多个源文件中的指定字符串。提供了两种方案:利用sed与grep组合命令快速处理,以及编写Python脚本实现跨平台(含Windows)的目录遍历替换。
本文详细介绍使用Python解决八皇后问题的回溯算法。通过定义冲突检测函数判断皇后位置是否合法,并利用递归生成所有可能的摆放方案。文章包含完整代码示例及运行结果分析,帮助开发者理解递归调用与状态更新机制,适用于Python数据结构与算法学习。
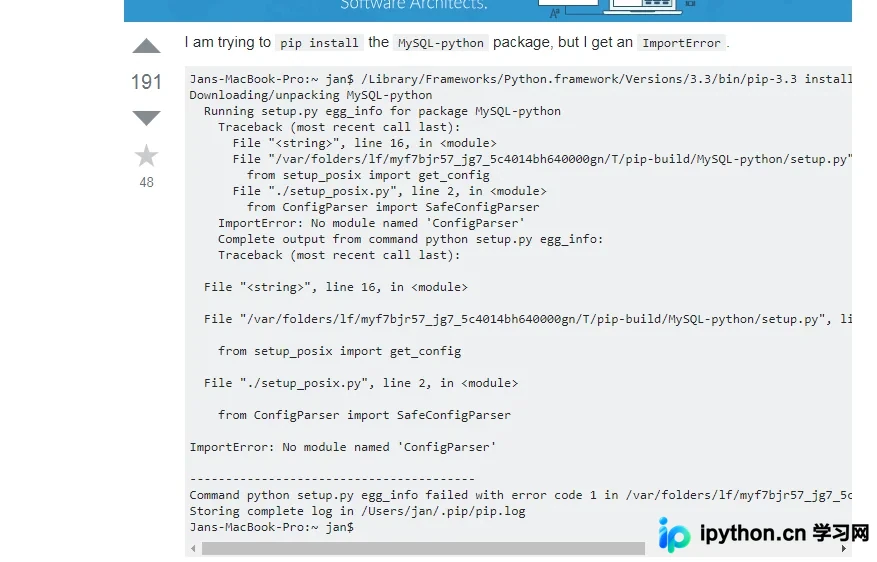
本文解决Django在重装MySQL后启动报错No module named 'MySQLdb'的问题。由于MySQL-python不支持Python3,推荐安装mysqlclient替代。通过pip安装mysqlclient并配置依赖环境,可快速修复模块缺失错误,确保Django正常运行。
本文详细解析Python中raw_input()与input()函数的差异。raw_input()始终返回字符串,需手动转换类型;input()尝试计算输入值,直接返回对应类型(如整数)。文章通过代码示例展示了如何转换为int、list或str,并指出input()处理非数值字符串时的报错机制及向下取整特性。
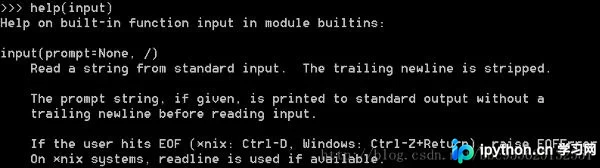
本文详细解析Python3中的input函数,说明其作为内建函数从标准输入读取字符串并忽略换行符的机制。重点对比Python2中input与raw_input的区别,指出Python3整合二者后统一将所有输入视为字符串处理的特性,并介绍类型转换方法。