

Python实现UDP协议Ping程序:服务器与客户端代码详解
本文详细介绍如何使用Python编写基于UDP协议的Ping程序。通过服务器端模拟网络丢包环境,结合客户端发送报文并计算往返时间,展示了完整的Socket通信流程。包含服务器与客户端的核心代码实现,适用于网络协议学习与调试参考。
2026-10-13
7

本文详细介绍如何使用Python编写基于UDP协议的Ping程序。通过服务器端模拟网络丢包环境,结合客户端发送报文并计算往返时间,展示了完整的Socket通信流程。包含服务器与客户端的核心代码实现,适用于网络协议学习与调试参考。
本文介绍如何使用Python3结合urllib库实现百度贴吧指定页面的数据爬取。通过解析URL中pn参数的分页规律,编写脚本批量获取HTML源码,并将结果保存为本地文本文件。教程包含完整的代码示例、URL规则分析及控制台运行效果,适合Python初学者进行网络爬虫入门实践。
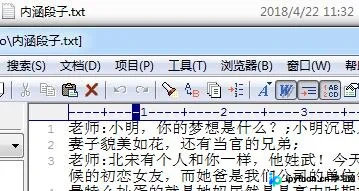
本文介绍如何使用Python3结合正则表达式从内涵段子网站抓取内容。通过构造请求获取HTML源码,利用re模块匹配特定标签内的文本,清洗后保存至本地文件。代码包含分页处理、请求头设置及文件写入逻辑,适合初学者理解爬虫基础流程。
本文通过三个经典案例详解Python中的贪心算法应用。首先解决硬币找零问题,通过优先使用大面值硬币实现数量最小化;其次探讨最大子数组和问题,利用动态更新策略寻找连续子数组的最大和;最后分析汽车加油站问题,通过贪心策略计算最少加油次数。每个案例均提供完整Python代码实现及逻辑解析,适合算法初学者参考学习。
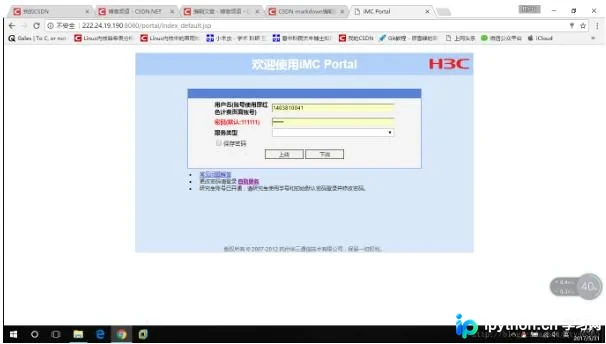
本文介绍如何利用Python爬虫技术解决校园网频繁掉线问题。通过Firefox浏览器抓包获取登录接口、参数及Header信息,结合requests库编写自动登录脚本。脚本包含死循环检测网络状态,断网时自动重新提交POST请求,并可打包为exe实现开机自启,无需手动操作。
本文介绍如何在Python3中通过winreg模块读取Windows注册表中的历史WiFi连接记录,并结合外部API实现地理位置定位。重点说明Python2中_winreg模块在Python3中更名为winreg,并提供完整代码示例及注意事项。
本文详细介绍如何使用Python结合Selenium库实现IE浏览器的自动登录。内容涵盖环境准备、IEDriverServer下载与路径配置、环境变量设置及驱动验证方法,并提供完整的自动化登录Python代码示例,帮助用户快速搭建基于IE的Web自动化测试流程。
本文详细解析 Python 中实现选择排序算法的具体步骤。通过遍历数组找出最小元素并与当前位置交换,逐步完成排序。文章包含 6 个元素的排序过程演示及完整 Python 代码示例,帮助读者理解选择排序逻辑。
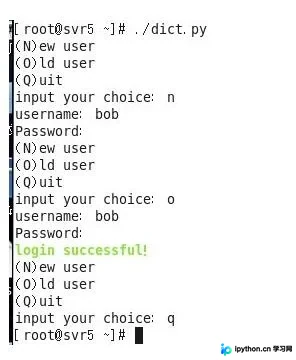
本文介绍如何使用Python编写一个简易的用户登录与注册程序。代码利用getpass模块隐藏密码输入,通过字典结构存储用户信息,并实现新用户注册、老用户登录及退出功能。程序包含基本的异常处理机制,适合Python初学者学习交互式命令行程序的开发逻辑。
本文深入解析Python中循环import导致ImportError的根本原因,阐述模块加载至内存映射表的机制。针对该问题,提供将import语句后置或移至函数内部两种有效解决方案,帮助开发者规避模块依赖冲突。
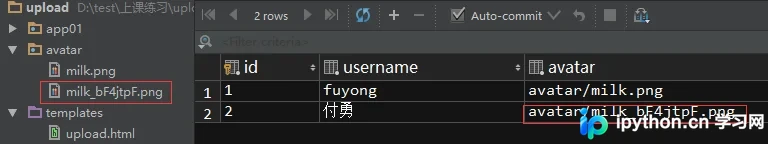
本文详解Django中实现文件上传的多种方案,涵盖本地服务器存储、数据库路径管理及AJAX异步提交。重点解析Form表单与AJAX在ContentType指定上的差异,包括enctype属性、processData与contentType参数设置,以及MEDIA_ROOT与MEDIA_URL的配置方法,确保文件可被正确访问。
本文介绍Python中定义接受任意数量参数的函数方法。通过在前置参数前添加星号,可将多个位置参数打包为元组;使用双星号则可接收键值对参数并转为字典。文章包含代码示例及交互测试,展示不同参数组合下的处理逻辑与结果。