

Python smtplib实现自动发送纯文本与HTML邮件
本文介绍如何利用Python的smtplib模块实现自动化邮件发送功能,适用于自动化测试报告的分发场景。通过示例代码演示了纯文本和HTML两种格式邮件的构建与发送方法,包括服务器配置、登录认证及内容封装步骤,帮助开发者快速集成邮件通知功能。
2026-10-13
7

本文介绍如何利用Python的smtplib模块实现自动化邮件发送功能,适用于自动化测试报告的分发场景。通过示例代码演示了纯文本和HTML两种格式邮件的构建与发送方法,包括服务器配置、登录认证及内容封装步骤,帮助开发者快速集成邮件通知功能。

本文系统讲解Pandas核心数据处理技巧,涵盖数据清洗(缺失值处理、重复值去重)、排序(索引与值排序)、索引管理(reindex、set_index、reset_index)及高效数据选取(loc、iloc、query)。通过具体代码示例,帮助开发者掌握从基础属性到高级操作的全流程方法,提升数据处理效率。
本文详细介绍使用Python编写的点球小游戏实现过程。通过for循环控制5轮比赛,利用random.choice随机生成电脑方向,结合if-else判断射门与扑救结果。代码涵盖得分统计、用户交互及胜负判定逻辑,适合Python初学者理解基础语法与逻辑控制。
本文介绍一个基于Python和Selenium的12306余票自动查询脚本。该脚本可监控指定车次、日期及席别的余票变化,当票数出现变动时,自动通过SMTP协议向指定QQ邮箱发送提醒邮件,帮助用户高效捡漏。

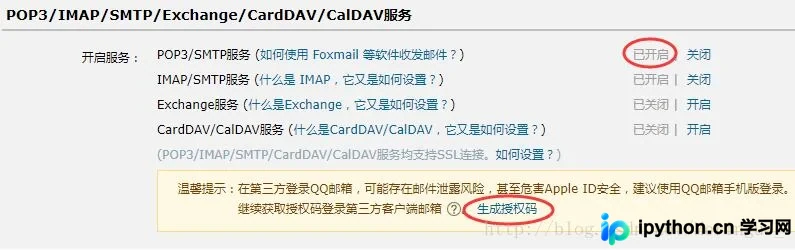
本文介绍如何使用Python标准库smtplib封装SMTP协议,通过开启QQ邮箱SMTP服务并获取授权码,实现自动发送电子邮件。包含完整代码示例、配置步骤及常见报错处理。
本文介绍如何使用Python脚本解析Nginx访问日志,统计各IP的访问次数及总流量。通过逐行读取日志文件,利用字符串分割提取IP地址和流量数据,并借助字典结构累加统计结果,最终输出IP访问频次、流量总和及平均流量大小,适用于服务器日常运维与性能监控场景。
本文介绍如何使用Python的urllib库下载网页源码并保存为本地HTML文件。通过示例代码展示如何获取指定URL的网页内容,并将其以二进制模式写入本地文件。该方法适用于提取纯文本内容,但需注意本地保存的文件不包含外部引用的图片等资源。
本文介绍如何在Python中使用datetime和timedelta模块对当前时间进行增加操作,包括加一天、一小时和一分钟。通过示例代码展示如何获取当前时间、格式化输出以及进行时间增量计算,并提供相关在线工具推荐。
本文介绍如何使用Python的Beautiful库读取本地HTML文件,并通过CSS选择器提取特定网页元素。文章提供了两种代码实现方式,对比了select方法的等效写法以及获取文本的多种途径,最后附带示例HTML结构,帮助开发者快速掌握本地网页数据的解析技巧。
本文通过Python代码演示了如何计算两个数的最大公约数和最小公倍数。内容涵盖非递归与递归两种算法实现,并对比了Python内置库函数的用法。文中提供了完整的代码示例及运行结果分析,帮助开发者理解算法逻辑并应用于实际开发中。
本文介绍如何使用Python的lxml模块提取HTML页面中所有叶子节点的XPath路径。针对原始解析结果包含非叶子节点的问题,提出基于路径包含关系的过滤算法:若当前路径被下一路径包含则跳过,否则视为叶子节点。通过实际代码演示了从原始XPath列表到纯净叶子节点XPath列表的转换过程,并提供了相关XML处理工具推荐。
本文总结Python中几项实用但常被忽视的基础技巧。涵盖利用元组简化startswith/endswith判断、通过start参数控制enumerate索引、使用slice对象命名切片提升代码可读性、在with语句中同时管理多个资源,以及for/while/try语句中else子句的正确使用场景与异常处理规范。