

Python Pandas DataFrame 行列操作与未命名列处理详解
本文详细讲解 Python Pandas 库中 DataFrame 的行与列选取方法,涵盖 loc、iloc、ix 等常用索引方式。针对读取 CSV 时产生的未命名列问题,提供重命名删除与直接切片剔除两种解决方案,帮助开发者高效处理数据清洗中的边缘情况。
2026-10-13
9

本文详细讲解 Python Pandas 库中 DataFrame 的行与列选取方法,涵盖 loc、iloc、ix 等常用索引方式。针对读取 CSV 时产生的未命名列问题,提供重命名删除与直接切片剔除两种解决方案,帮助开发者高效处理数据清洗中的边缘情况。
本文详细介绍 Python 中 DataFrame 的常见操作方法,涵盖如何高效提取指定行与列、进行连续或离散的数据切片,以及计算均值、计数和分位数等统计特征值。通过具体代码示例,帮助开发者快速掌握 Pandas 核心数据处理技巧。
本文详细讲解如何利用pandas库对Series和DataFrame进行排序操作。内容涵盖按索引排序、按值排序、升降序调整及多列排序等核心功能,通过具体代码示例与运行结果展示,帮助开发者掌握数据清洗与预处理中的关键排序技巧。
本文详细介绍在Python pandas中替换某一列特定值的方法。通过示例数据集,演示如何将非指定字符串统一替换为默认值,提供简洁的代码实现步骤,帮助开发者快速掌握数据清洗中的关键技巧,适用于各类表格数据处理场景。
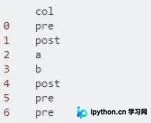
本文探讨在Python中处理包含字符与数值的混合类型NumPy数组(dtype为字符串)时,如何有效提取纯数值数据。由于math.isnan和np.isnan均无法直接处理此类数组,文章提供了两种解决方案:一是转换为列表后过滤但丢失索引;二是利用map生成布尔数组,结合pandas DataFrame保留原始索引信息,从而实现数据与索引的同步过滤。
本文介绍如何使用pandas库中的astype方法修改DataFrame列的数据类型。通过示例演示将字符串型列转换为整型的操作,并展示修改前后的数据类型对比,帮助开发者快速掌握pandas列属性修改技巧。
本文介绍如何在Python的DataFrame中更改列表字段或元素的数据类型。通过示例演示如何使用astype属性将特定字段(如PassengerId和Survived)从float64转换为int64,并提供代码实现及结果验证方法,帮助开发者高效处理数据格式问题。
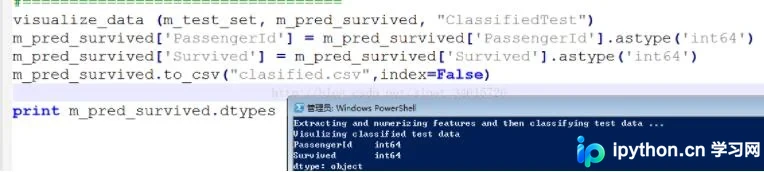
本文介绍Numpy中查看和转换数据类型的方法。通过dtype属性查看数组类型,利用astype方法进行类型转换。示例涵盖整型转浮点、浮点截断转整型及字符串转数值型,展示Numpy自动映射类型的特性。
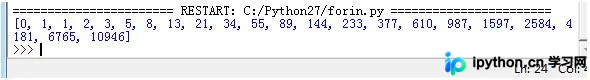
本文介绍Python 2.7中如何使用for循环遍历range函数来计算斐波那契数列。通过初始化列表并循环20次,利用append方法在列表末尾添加前两项之和,最终输出包含22个元素的数列。文章还解析了变量i的作用及列表逆向索引技巧,适合Python初学者参考。
本文介绍如何在Python的DataFrame对象中为行和列添加名称。通过设置index.name和columns.name属性,可以解决因缺少行列名导致的报错问题,并优化数据展示格式。
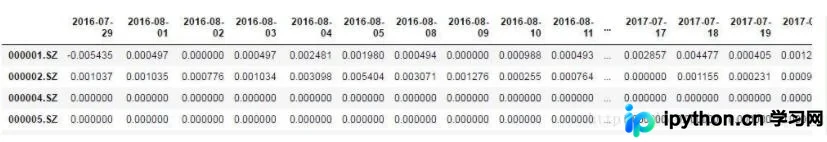
本文通过具体代码实例,演示了如何使用pandas库创建DataFrame并读取其中的行与列数据。重点介绍了利用iloc和loc进行索引定位,以及直接通过列名访问数据的方法,为Python数据分析提供基础参考。
本文介绍如何在Python pandas中处理包含多层索引的DataFrame。通过示例展示使用droplevel()方法逐层移除索引,从而将多重索引转换为单一默认索引,帮助开发者简化数据结构。