

Python批量读取目录文件并实现去重处理的实现方法
本文介绍如何利用Python的os模块批量读取指定目录下的所有txt文件,并结合set数据结构实现内容去重。通过遍历文件夹获取文件列表,逐行读取内容存入集合以自动过滤重复项,最后将去重后的结果写入新文件。该方法适用于需要高效处理大量文本数据的场景,避免了手动逐一操作的低效问题。
2026-10-13
7

本文介绍如何利用Python的os模块批量读取指定目录下的所有txt文件,并结合set数据结构实现内容去重。通过遍历文件夹获取文件列表,逐行读取内容存入集合以自动过滤重复项,最后将去重后的结果写入新文件。该方法适用于需要高效处理大量文本数据的场景,避免了手动逐一操作的低效问题。
本文介绍如何使用Python遍历指定目录下的所有TXT文件并读取其内容。通过os.listdir获取文件列表,利用os.path判断文件类型,结合open函数进行读写操作。代码示例展示了如何递归处理文件夹、过滤隐藏文件,并将读取的内容追加写入到指定结果文件中,适用于批量文本处理场景。
本文介绍Python中两种常见的数据持久化方式。首先演示如何将字符串列表逐行写入TXT文本文件,确保每条数据独立成行;其次展示利用json模块将嵌套字典对象序列化为JSON格式并保存至本地文件。通过具体代码示例,帮助开发者掌握基础的文件读写操作,适用于日志记录或简单配置存储场景。
本文介绍在Python中统计多维数组(如二维元组)行数和列数的方法。通过len()函数可直接获取数组长度,例如len(A)获取行数,len(A[0])获取第一行的列数。适用于处理固定维度的多维数据结构。
本文介绍在Python中如何使用内置的len函数来获取数组(List)及字符串的长度。通过简单示例展示len函数的通用性,适用于各类需要计算长度的场景,帮助开发者快速掌握基础操作。
本文深入解析Python类的成员访问机制,区分公有与私有成员的命名规则及继承限制。重点讲解类中特殊成员(魔术方法)的工作原理,包括__int__、__str__、__add__、__getitem__、__iter__等方法的自动触发条件与具体用法,结合代码示例说明对象转换、运算重载及迭代器实现细节。
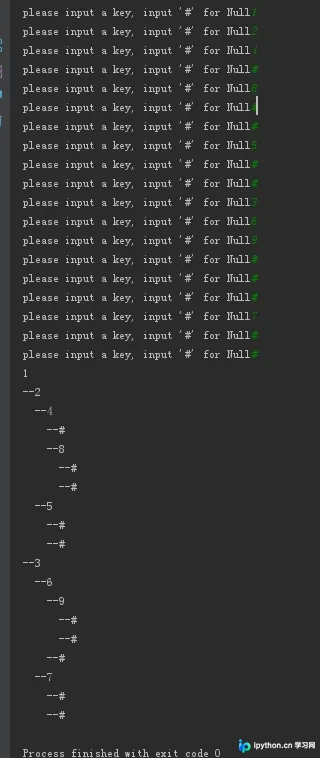
本文详解Python中重建二叉树的三种方法:通过input手动输入、前序字符串递归解析及堆栈解析。文章提供节点类定义、核心算法代码及完整实例,适用于数据结构学习与算法解题参考,并附GitHub源码链接。
本文详细解析Python列表解析中两种包含if的结构:仅含if用于条件过滤,以及含if-else用于条件赋值。通过具体代码示例说明两者在生成列表时的行为差异,帮助开发者准确使用列表推导式。
本文介绍在Python中解决input函数遇回车即结束输入的问题,通过两种代码示例展示如何持续接收用户多行输入并保存至指定文本文件。第一种利用iter函数配合哨兵值,第二种采用while循环判断退出条件,均支持以特定指令结束输入并保存内容。
本文介绍在Python中如何处理用户输入的数字字符串。通过示例演示如何将输入的字符串转换为字符列表,再利用map函数将字符转为整数,最后使用sort方法对数字列表进行排序,输出最终的有序数字列表。
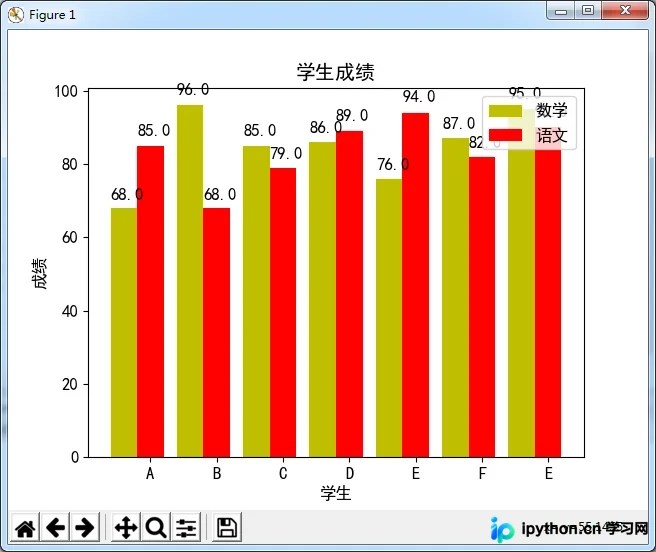
本文介绍如何使用Python的Matplotlib库绘制双柱状图,并通过自定义函数在柱体上方自动标注具体数值。代码包含中文显示设置、分组柱状图绘制及图例添加,适用于学生成绩等对比数据的可视化展示,帮助开发者快速实现带有详细数据标签的统计图表。
本文详解在Python Selenium中如何获取DOM元素的属性值、文本内容及状态。通过get_attribute获取自定义属性,利用text属性获取可见文本,使用value_of_css_property读取CSS值。状态判定方面,介绍is_displayed判断可见性,is_selected判断选中状态,以及通过异常捕获或class属性判断元素是否存在与是否真正禁用。