

Python实现网页截图:PyQt4与Selenium两种方案详解
本文介绍Python实现网页截图的两种方法。方法一利用PyQt4的QtWebKit组件,通过QWebView加载页面并保存为图片,需注意字体像素警告及32/64位安装包下载。方法二使用Selenium库驱动Firefox浏览器,需配合geckodriver.exe使用,并提供了相应的pip安装命令及路径配置说明。
2026-10-13
7

本文介绍Python实现网页截图的两种方法。方法一利用PyQt4的QtWebKit组件,通过QWebView加载页面并保存为图片,需注意字体像素警告及32/64位安装包下载。方法二使用Selenium库驱动Firefox浏览器,需配合geckodriver.exe使用,并提供了相应的pip安装命令及路径配置说明。
本文介绍 Python 中读取文件并替换字段的三种常见方法。第一种通过新建文件写入实现字符串替换;第二种利用 re 模块进行正则替换并输出到新文件;第三种演示如何在原文件中通过 seek 定位指针实现原地修改,同时指出长度不一致时的潜在问题。
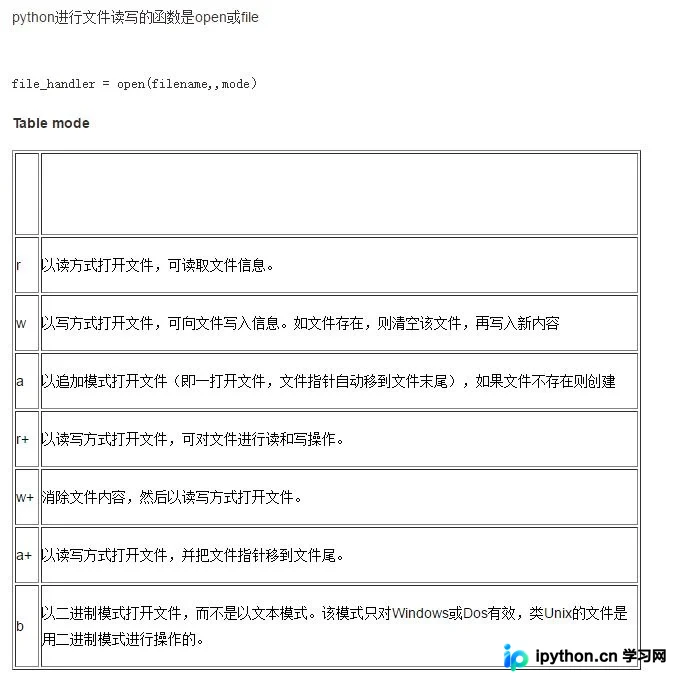
本文介绍在 Python 中如何高效地按行读取文件内容,并通过列表索引修改特定行的数据,最后将更新后的内容写回原文件。主要涉及 open 函数的读写模式、readlines 获取行列表以及 writelines 批量写入的操作流程,适用于需要局部更新文本文件的场景。
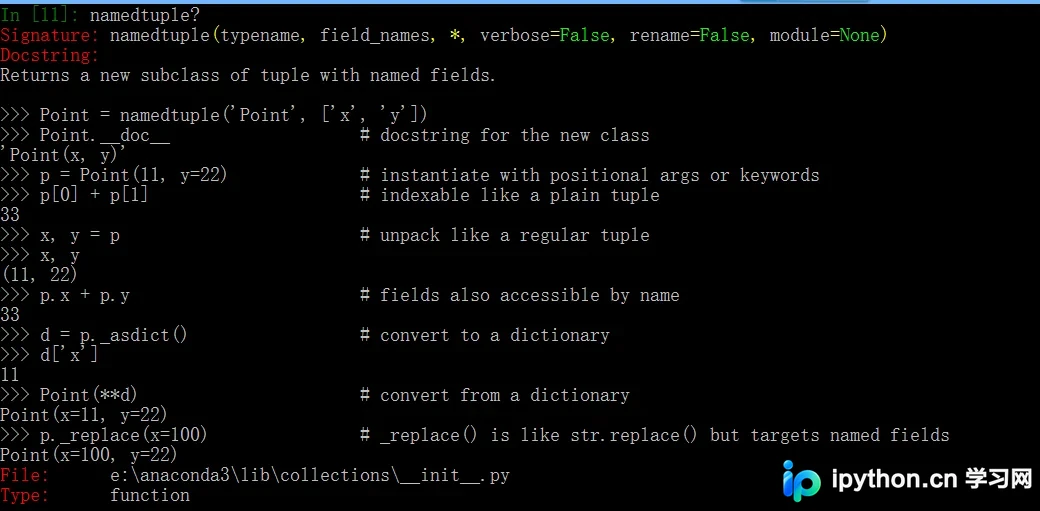
本文详细介绍Python中元组的创建方法及元素命名技巧。通过对比单元素元组的括号写法,引出对元组元素进行命名的两种常用方式:一是通过解包索引值赋予变量名,二是利用collections模块中的namedtuple类创建具名元组。文章结合代码示例,演示了如何通过属性访问方式操作namedtuple实例,帮助读者提升代码可读性与维护性。
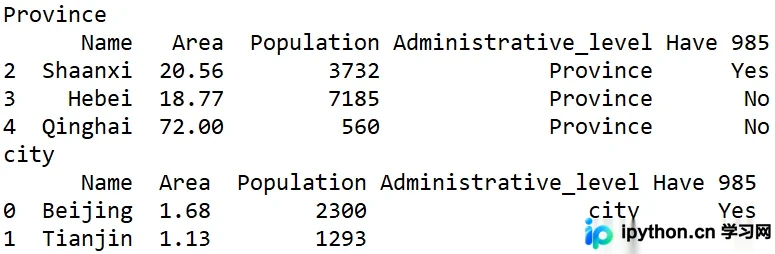
本文介绍Python中pandas库DataFrame的groupby分组功能。通过创建包含行政级别和985高校信息的示例数据,演示如何按单个属性(行政级别)及多个属性(行政级别与是否有985高校)进行分组聚合。代码展示了groupby的基本用法及结果输出,帮助开发者掌握数据分组的核心操作。
本文详细介绍了在Python中实现字符串翻转的五种不同方法。内容涵盖传统的循环与列表反转方式,以及利用切片、内置函数和高阶函数reduce实现的简洁写法。通过对比分析各方法的代码结构与执行逻辑,帮助开发者根据实际需求选择最合适的字符串反转方案,提升代码效率与可读性。
本文详细介绍在Python 3.7环境中安装OpenCV库的方法。针对直接pip安装失败的情况,提供从UCI网站下载对应cp37版本whl文件的步骤,并通过命令行指定路径完成本地安装。同时包含解决平台不支持错误的排查代码,确保64位或32位系统用户能顺利配置环境。
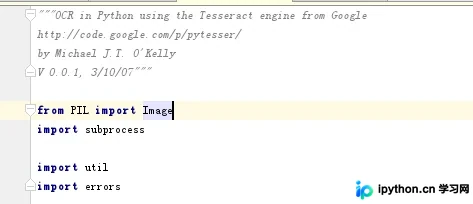
本文详细介绍在Python2环境下利用pytesser和PIL库实现图片文本识别的方法。涵盖从pytesser下载、解压安装到修改__init__.py文件的关键配置,以及PIL库的安装避坑指南。通过具体代码示例,指导用户解决常见报错,完成图片识别测试,并分析该方法的局限性及优化建议。
本文介绍在Python中如何利用命名元组(namedtuple)替代字典存储结构化数据。通过对比普通元组与命名元组的用法,详解如何为元组元素赋予语义化名称,从而解决索引取值晦涩难懂的问题,提升代码的可读性与维护性。
本文介绍如何在Python中实现指定递归深度并忽略特定目录的文件查找功能。通过自定义函数,解决默认递归导致的最大深度报错问题,支持灵活设置查找层级和排除目录列表,适用于不同项目结构下的文件定位需求。
本文提供Python递归遍历指定目录及其所有子目录下文件的完整代码示例。通过os.listdir结合递归调用实现文件路径收集,并展示如何对获取的文件列表进行正则过滤筛选特定文件,适用于批量文件处理场景。
本文介绍如何在Python中按名称顺序读取文件夹下的文件。通过os.listdir获取文件列表并使用sort()排序,可确保按字母或数字顺序处理文件。代码示例展示了路径拼接与遍历过程,适用于需要按序处理文件的场景。