Pandas中pivot与unstack实现数据行转列详解
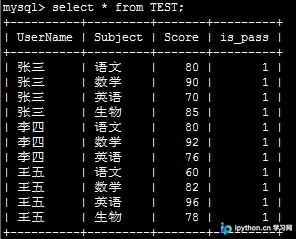
本文详细解析Pandas中DataFrame的行转列操作,重点对比pivot与unstack两种方法。通过示例展示如何利用pivot快速重塑二维表格,并深入探讨基于层次化索引的unstack实现原理。文章包含完整代码示例及MySQL数据交互场景,帮助开发者掌握数据重塑技巧。
2026-10-13
9

本文详细解析Pandas中DataFrame的行转列操作,重点对比pivot与unstack两种方法。通过示例展示如何利用pivot快速重塑二维表格,并深入探讨基于层次化索引的unstack实现原理。文章包含完整代码示例及MySQL数据交互场景,帮助开发者掌握数据重塑技巧。
本文深入解析pandas中的Series数据类型,涵盖由列表、NumPy数组及字典创建Series的多种方法。详细阐述Series的索引机制、与数组的区别,以及shape、index、values等核心属性。同时介绍非空值过滤、name属性设置及isnull/notnull等常用操作,帮助开发者高效掌握Series数据结构。
本文详细介绍 pandas 中层次化索引(MultiIndex)的创建、数据选取、排序及重塑方法。涵盖 Series 和 DataFrame 的多级索引构建,演示 swaplevel、sortlevel 及 set_index/reset_index 等核心函数的具体用法,帮助开发者高效处理复杂数据结构。
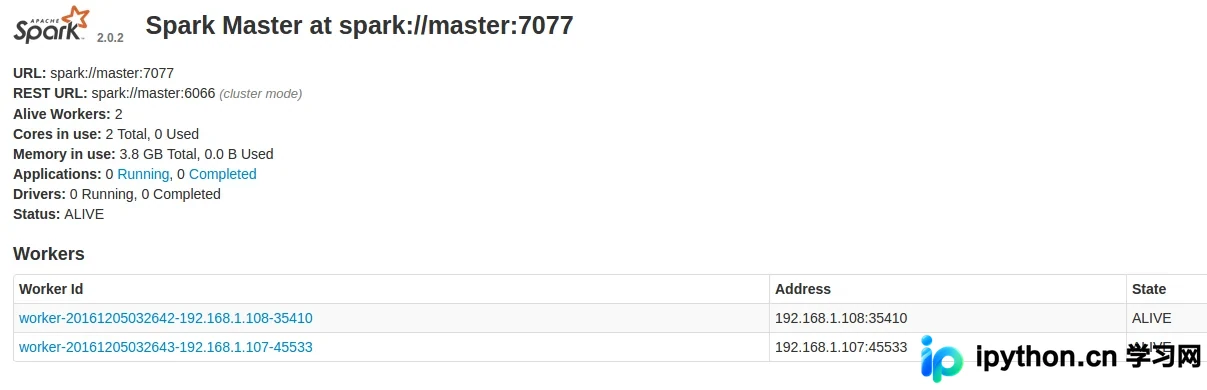
本文详细讲解如何在Python环境下,利用三台物理机搭建Spark分布式集群。教程涵盖从Hadoop集群环境准备、Spark软件安装、环境变量配置,到slaves与spark-env.sh的关键参数设置。最后演示了Master与Slave节点的启动、进程验证及Web界面监控,提供完整的集群部署与关闭步骤。
本文详解Python colorlog库中ColoredFormatter类的用法,涵盖安装、核心参数(format、log_colors等)、颜色转义码语法及secondary_log_colors的高级配置,并提供dictConfig、fileConfig及自定义日志级别的完整代码示例。
本文提供基于Python的微信爬虫完整代码示例,分别演示单线程与多线程两种实现方式。通过urllib库抓取网页内容并保存为HTML文件,多线程版本引入Queue和Thread模块提升效率。代码包含User-Agent设置、代理预留接口及异常处理,适合Python初学者参考学习并发编程与网络爬虫基础。
本文详细介绍使用Python爬取百度图片的完整实现方法。通过构造特定URL请求,利用requests库获取数据,并结合正则表达式与字典映射处理返回的加密字符串,最终将解析出的图片链接保存至本地文件夹。文中提供了完整的Python代码示例,涵盖关键字输入、URL构建、数据解密及文件保存等关键步骤,供开发者参考学习。
本文介绍如何利用Python的pynput库模拟鼠标点击与键盘输入,实现自动登录QQ客户端。通过指定坐标定位并执行点击操作,结合Tab键切换焦点与键盘类型功能输入账号密码,最后模拟回车键完成登录。代码包含完整路径配置及延时控制,适用于Windows环境下的桌面应用自动化测试与操作。
本文介绍Python中zip函数如何同时迭代多个序列。解析zip在Python 2与3中的行为差异,演示生成元组迭代器的用法,并针对序列长度不一致的情况,介绍使用itertools.zip_longest的解决方案,帮助开发者高效处理多数据源遍历。
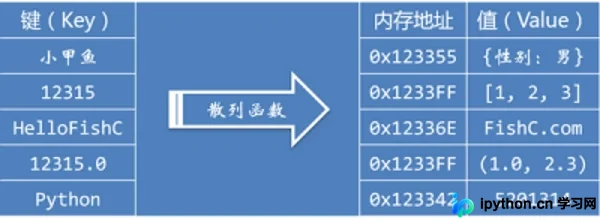
本文深入解析 Python 字典(Dict)的底层存储机制,重点阐述哈希(Hash)算法如何将键转换为唯一内存地址。文章详细说明了为何键必须是可哈希的不可变对象,列举了列表、字典等可变类型不能作为键的原因,并解释了元组作为键的特殊限制条件及数值等价性处理。
本文介绍如何使用Python3结合Appium框架,通过配置不同的udid和端口,实现同时对多台安卓手机或模拟器进行APK包的安装操作。文章提供了基于多线程和多进程并发启动Appium服务及驱动的核心代码示例,强调了必须使用udid区分设备的关键点,旨在帮助测试人员解决批量部署应用的自动化需求。
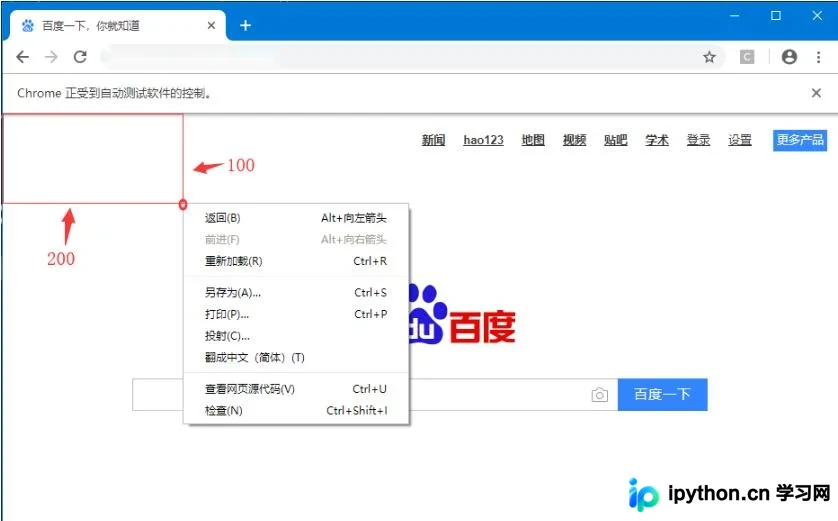
本文介绍如何使用 Python Selenium 的 ActionChains 库通过坐标点击网页元素。重点解析 move_by_offset 导致的坐标累积问题,并提供封装函数恢复鼠标位置的解决方案,适用于元素定位困难但位置固定的场景。