

Python 字典底层存储原理:哈希机制与键值约束详解

本文深入解析 Python 字典(Dict)的底层存储机制,重点阐述哈希(Hash)算法如何将键转换为唯一内存地址。文章详细说明了为何键必须是可哈希的不可变对象,列举了列表、字典等可变类型不能作为键的原因,并解释了元组作为键的特殊限制条件及数值等价性处理。
Python 字典存储原理概述
前言
Python 中的字典拥有多个别称,包括“映射”、“哈希”、“散列”或“关系数组”。你是否了解字典为何被归类为 Hash(即“哈希”或“散列”)类型?
你是否清楚,为什么 Python 字典对键(Key)的存储有着严格的要求,而对对应的值(Value)却相对宽松?
阅读完本文,你将透彻理解这些现象背后的技术真相。
哈希(Hash)算法基础
hash
首先,我们需要明确什么是 Hash。参考维基百科的定义:
散列函数(或散列算法,又称哈希函数,英语:Hash Function)是一种从任意数据中生成小型数字“指纹”的方法。该函数将消息或数据压缩为摘要,从而减小数据量并固定数据格式。它通过打乱和混合数据,重新创建一个称为散列值的指纹。散列值通常表现为由短随机字母和数字组成的字符串。优质的散列函数在输入域中极少出现散列冲突。在散列表和数据处理场景中,若不抑制冲突以区分数据,会导致数据库记录更难查找。
正如世界上没有两片完全相同的树叶或两个相同的指纹,散列函数的作用正是从数据中提取出唯一的数字指纹。
字典底层存储机制
我们参考以下图示进行说明:
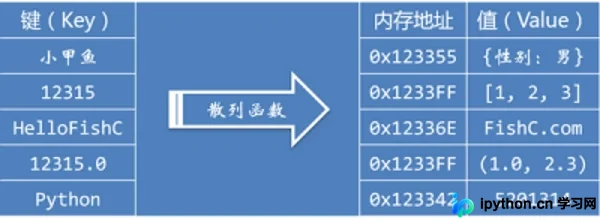
如图所示,Python 调用内部散列函数,将键(Key)作为参数进行转换,生成一个唯一的内存地址(这也解释了为何对相同键赋值会直接覆盖,因为转换后的地址一致)。随后,值(Value)被存储在该地址中。
键(Key)的可哈希性约束
对于 Python 而言,键(Key)必须是可哈希的,即能够通过散列函数计算出唯一地址。那么,能否使用变量作为键(Key)?答案是否定的。因为变量内容可能随时改变,这不符合可哈希性的原则。
同理,列表、字典和集合均为可变类型,因此它们都不能用作字典的键(Key)。
此时可能会有读者疑问:那元组呢?元组通常被视为不可变的。
事实并非如此绝对。由于元组内部可能包含列表等可变元素,因此若确实希望使用元组作为字典的键(Key),必须满足特定限制:只有当元组中仅包含数字、字符串等不可变元素时,它才能作为字典中有效的键(Key)。
此外需注意,Python 的哈希算法对相同数值计算出的结果一致。例如,12315 和 12315.0 被视为具有相同的哈希值,因此它们被认为是相同的键(Key)。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









