Python正则表达式过滤HTML标签提取纯文本
本文介绍如何在Python中使用正则表达式过滤HTML标签并提取纯文本。通过定义多个正则规则,依次移除CDATA、Script、Style标签及HTML注释,并将换行符转换为标准格式,最后替换字符实体。该方法能有效清理HTML字符串,适用于网页内容抓取与数据处理场景。
2026-10-13
16

本文介绍如何在Python中使用正则表达式过滤HTML标签并提取纯文本。通过定义多个正则规则,依次移除CDATA、Script、Style标签及HTML注释,并将换行符转换为标准格式,最后替换字符实体。该方法能有效清理HTML字符串,适用于网页内容抓取与数据处理场景。
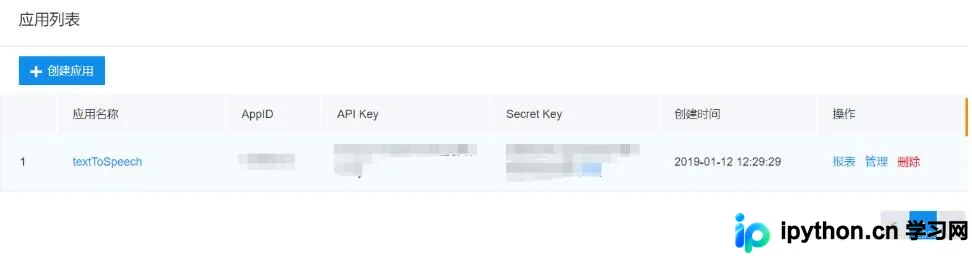
本文详细解析Python实现文字转语音的三种方法:调用百度语音合成API生成音频文件、使用Pyttsx3库直接调用系统引擎(含中文配置),以及利用gTTS生成MP3并播放。涵盖环境配置、代码示例及注意事项,帮助开发者快速实现语音播报功能。
本文介绍如何在Python3中使用requests库发送HTTPS请求时,通过关闭证书验证(verify=False)避免控制台输出InsecureRequestWarning警告。提供了针对Python2和Python3的具体代码解决方案,包括使用urllib3.disable_warnings()方法,帮助开发者清理控制台输出并简化调试过程。
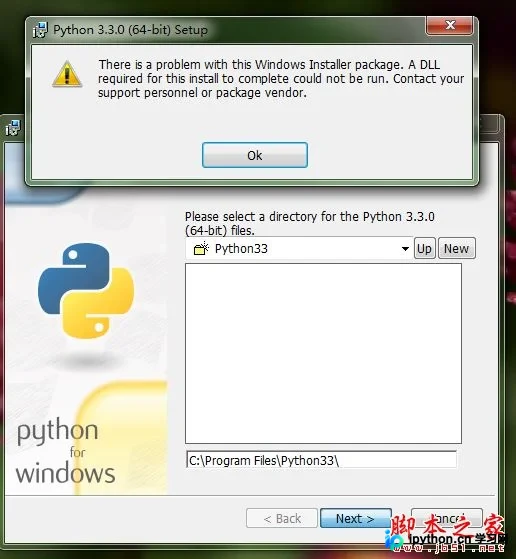
本文介绍了Python安装过程中遇到的“缺少DLL”错误及其两种解决方法。方法一通过以管理员身份运行安装包并修改Temp文件夹权限解决;方法二利用Windows的msiexec命令进行静默或无人值守安装。文章详细解析了msiexec的关键参数用法,帮助用户顺利完成Python环境搭建。
本文介绍如何在Python中使用re模块的split函数进行多符号分割。通过示例展示如何同时使用逗号、句号和问号作为分隔符,将字符串拆分为列表。
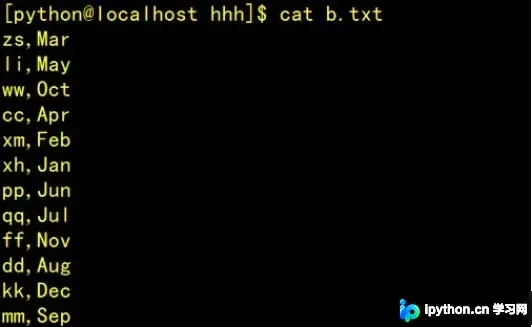
本文介绍如何使用Python读取包含月份数字的文本文件,并通过条件判断将数字替换为对应的英文月份缩写(如1转为Jan)。文中详细解析了open函数的不同模式(r, w, a等)及二进制操作,提供了完整的代码示例和注意事项,帮助开发者理解基础的文件流处理逻辑。
本文介绍在Python中如何使用正则表达式一次性提取被任意标点符号隔开的短句。通过定义包含中英文标点的匹配模式,利用re.split函数实现高效分割,并展示完整代码示例与结果验证。
本文介绍在 Python 中利用正则表达式判断字符串是否包含简体中文或非简体中文的方法。通过定义匹配 Unicode 汉字范围的编译对象,结合 search 方法实现检测,并提供了完整的代码示例供参考。
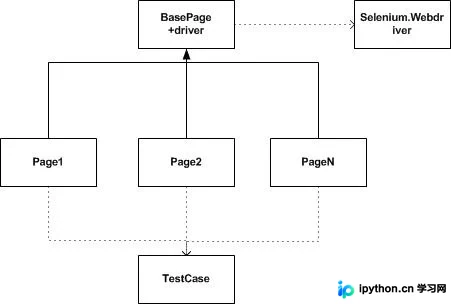
本文深入剖析Selenium自动化测试中常见的代码混乱问题,并引入Page Object设计模式进行重构。通过对比传统写法与基于BasePage继承的Page模式,详细展示了如何分离页面元素定位与业务逻辑,从而显著提升测试用例的易读性、可扩展性、可复用性及可维护性,帮助开发者构建更稳健的Web自动化测试体系。
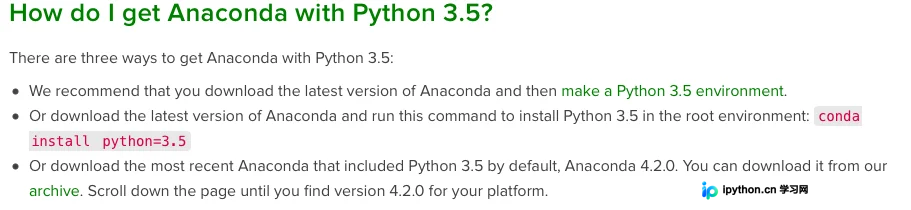
本文介绍在Anaconda中将Python版本从3.6降级至3.5的三种方法,以解决TensorFlow仅支持Python3.5的问题。包括新建独立环境、直接修改当前环境版本以及重新安装特定版本Anaconda,帮助用户灵活管理Python环境。
本文详解Python Pandas库中时间序列处理的核心功能。涵盖使用pd.date_range和pd.period_range生成日期序列的区别,通过pd.Timestamp和pd.to_datetime创建及转换时间戳对象,解析Period对象的时间间隔计算,以及利用asfreq和resample进行频率转换与数据重采样统计。
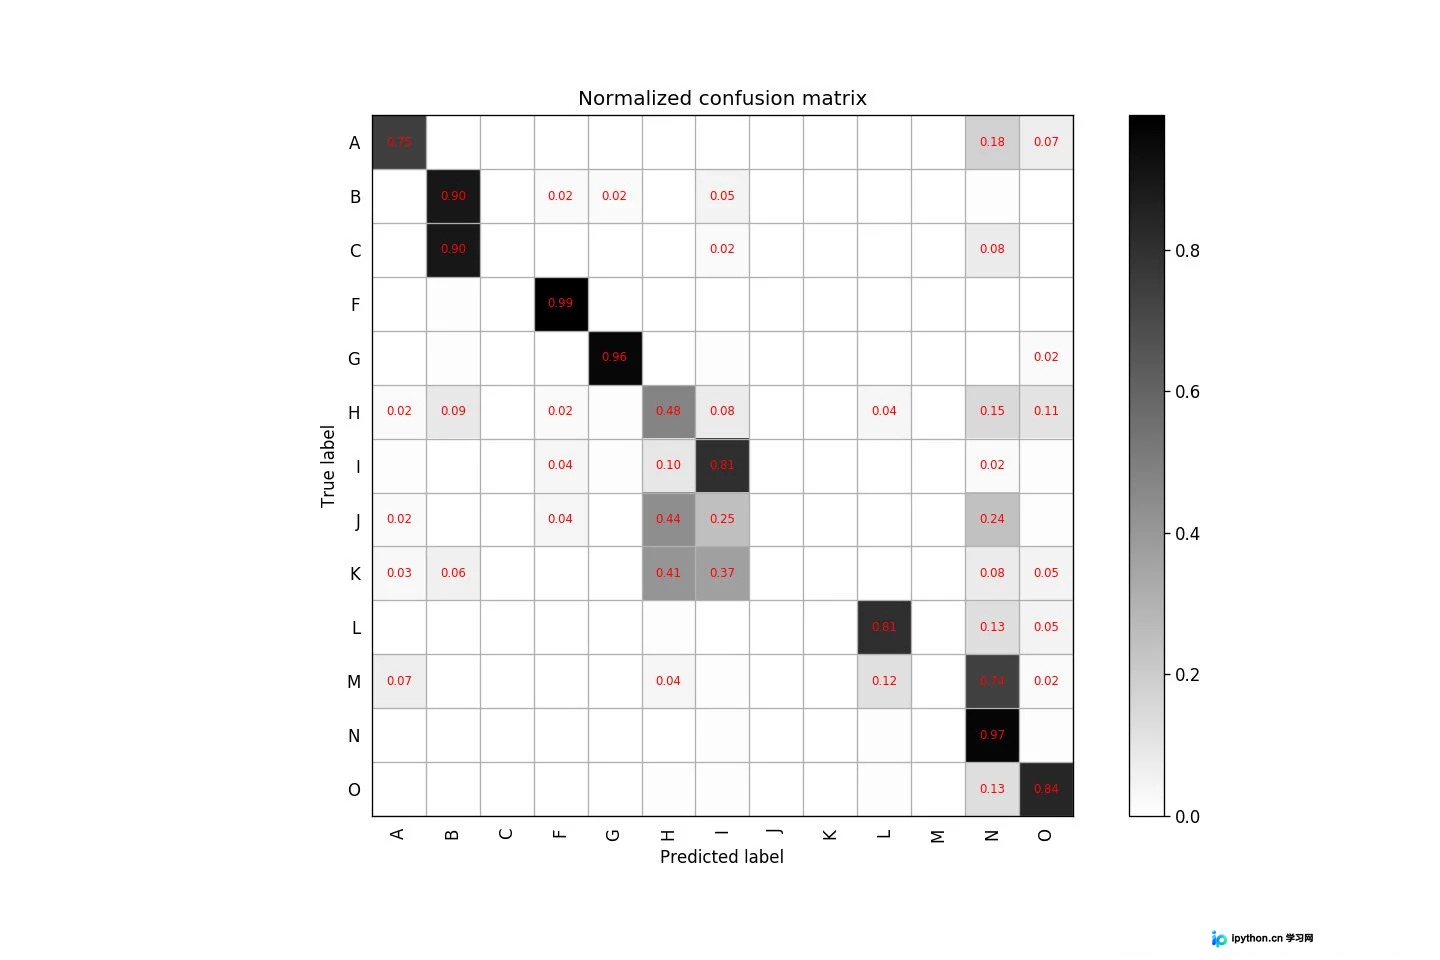
本文详细介绍如何利用Python和sklearn绘制混淆矩阵以分析分类问题。通过读取真实标签与预测标签文件,计算并可视化归一化混淆矩阵,帮助开发者直观评估模型性能并制定调参策略。