Python使用PyPDF2分割指定页数PDF文件的实现方法
本文介绍如何使用Python的PyPDF2库将PDF文件按指定页码范围进行分割。通过定义起始页和结束页参数,遍历源文件并提取对应页面写入新文件,实现精确的PDF分页操作。代码示例展示了完整的读取、提取及保存流程,适用于需要批量处理或拆分PDF文档的场景。
2026-10-13
6

本文介绍如何使用Python的PyPDF2库将PDF文件按指定页码范围进行分割。通过定义起始页和结束页参数,遍历源文件并提取对应页面写入新文件,实现精确的PDF分页操作。代码示例展示了完整的读取、提取及保存流程,适用于需要批量处理或拆分PDF文档的场景。
面对PDF文档中的冗余页、敏感信息或重复排版,手动调整效率低下。本文基于Python生态,对比PyPDF2、Spire.PDF与PyMuPDF三大工具的特性差异,提供单页删除、多页面批量过滤及空白页自动清理的核心代码。结合内存耗时实测数据与加密文档处理技巧,帮助开发者快速定位技术选型并规避索引越界等常见陷阱。
扫描转换或排版过程中,PDF文档常会混入无实际内容的空白页,逐页手动删除耗时费力。通过Python结合PyPDF2库读取页面字典结构,利用/Resources节点中是否包含图像(XObject)或字体(Font)对象作为判断依据,遍历过滤空页并输出新文件,即可实现自动化批量清理。
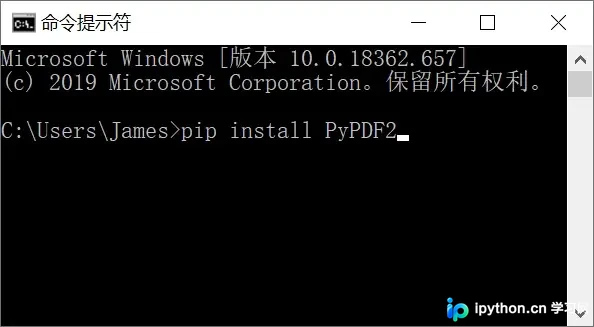
本文介绍如何利用Python生态中的PyPDF2、pdfminer.six与reportlab等工具,完成PDF文本读取、图片提取、新建生成以及拆分合并等常见操作。包含基础环境配置、核心代码示例与注意事项,适用于日常文档自动化处理场景。
本文介绍如何使用Python的PyPDF2库进行PDF文件的读取、写入、加密、解密、页面旋转、合并及添加水印等操作。涵盖从基础安装到具体代码实现的完整流程,包括处理加密文档的技巧和常见问题的解决方法。
本文详细介绍Python中处理PDF文件的常用方法。利用PyPDF2库实现文本提取、页面旋转、加密保护及合并操作;结合reportlab库演示如何创建包含图片与字体的PDF文档。涵盖从基础读取到高级编辑的完整流程,提供具体代码示例与参数说明,帮助开发者高效处理PDF文档。
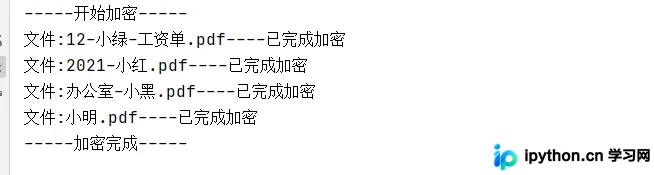
本文介绍如何使用Python脚本批量对PDF文件进行加密。通过读取Excel名单,提取身份证号码后六位作为密码,利用PyPDF2库对指定目录下的PDF文件进行加密处理。文章提供了完整源码、依赖说明及运行环境配置指南,适用于需要保护个人隐私信息的办公场景。
本文介绍如何利用Python开发一款永久免费的PDF编辑工具。通过PyPDF2库实现PDF页面的删除、合并、旋转及加密功能,并结合pdfminer库进行文本提取与格式转换。文章提供详细代码示例与安装步骤,帮助开发者快速掌握PDF处理技术。
本文详解如何使用Python主流库处理PDF文件。涵盖PyPDF2执行合并拆分与加解密、pdfminer.six与PyMuPDF精准提取文档文本、ReportLab动态创建页面及嵌入图片。提供完整代码示例、依赖安装步骤与安全操作规范,助您快速掌握自动化文档处理全流程。
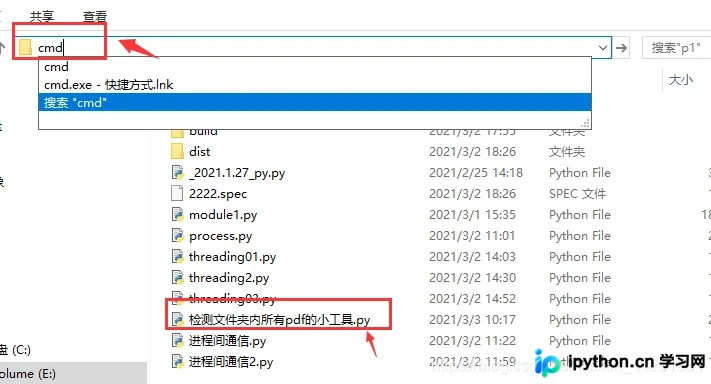
本文介绍如何使用 Python 编写一个批量统计文件夹内所有 PDF 文件页数的工具,并通过 PyInstaller 将其打包为无需安装 Python 环境的独立 exe 可执行文件。