

使用Python批量删除PDF空白页的代码与实现步骤

扫描转换或排版过程中,PDF文档常会混入无实际内容的空白页,逐页手动删除耗时费力。通过Python结合PyPDF2库读取页面字典结构,利用/Resources节点中是否包含图像(XObject)或字体(Font)对象作为判断依据,遍历过滤空页并输出新文件,即可实现自动化批量清理。
解决思路与原理
PDF的每个页面底层均以字典对象存储。有文字的页面通常包含字体引用(/Font),有图片的页面包含图像对象(/XObject),而真正的空白页往往缺失这些资源键值,或仅保留基础的/MediaBox和/Contents占位符。通过脚本遍历所有页码,识别并剔除不满足上述特征的空页,最后将有效页面追加至新的PDF实例中导出,即可完成批量去重。
环境与准备条件
本方案基于以下环境验证:Python 3.10 及以上版本,PyPDF2 3.0.1 及以上版本(注:PyPDF2 3.x 已废弃旧版 PdfFileReader 接口,统一采用 PdfReader/PdfWriter)。执行前建议先备份原始PDF文件,避免写入操作覆盖原数据。
第1步:安装依赖库
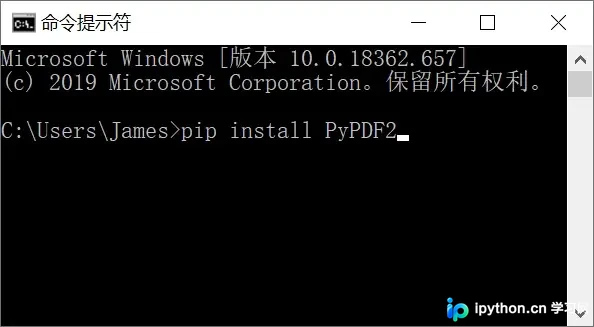
打开终端、CMD或PowerShell,执行以下命令安装核心处理库:
pip install PyPDF2
第2步:检测目标页面的内部结构
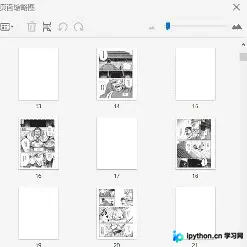
在实际编码前,需明确待处理PDF中空白页与内容页的结构差异。以一份包含多页内容的测试文档为例,分别读取对应索引的页面对象查看其字典键值:
blank = reader.getPage(16)
full = reader.getPage(17)
对比发现,顶层结构可能一致,但 /Resources 层级存在关键区别。空白页通常缺少 /XObject(图像)或 /Font(字体)标识:
第3步:编写过滤与导出代码
依据结构检测结果,筛选包含 /XObject 或 /Font 键的页面,并将其写入新文件。完整代码如下:
from PyPDF2 import PdfReader, PdfWriter

def remove_blank_pages(input_path, output_path):
    # 读取源文件
    with open(input_path, 'rb') as f:
        reader = PdfReader(f)

    writer = PdfWriter()

    for i, page in enumerate(reader.pages):
        # 检查 /Resources 下是否存在内容资源
        resources = page.get("/Resources", {})
        has_content = False

        if isinstance(resources, dict):
            if "/XObject" in resources or "/Font" in resources:
                has_content = True
            # 兼容部分生成器将结构父级信息直接放在顶层的情况
            elif "/StructParents" in page or "/Tabs" in page or "/Annots" in page:
                has_content = True

        if has_content:
            writer.add_page(page)

    # 写入新文件
    with open(output_path, 'wb') as f:
        writer.write(f)
    print(f"处理完成,共保留 {len(writer.pages)} 页有效内容。")

# 调用示例(请替换为实际路径)
# remove_blank_pages(r"D:\ebook\PDF\test.pdf", r"D:\ebook\PDF\output.pdf")
完成判断与排错指南
运行脚本后,打开生成的新PDF核对页码与内容完整性,若无意外空白残留即表示操作成功。若遇到异常,可参考以下排查方向:
- 版本接口变更:若使用的是低于3.0版本的PyPDF2,需将
PdfReader/PdfWriter替换为PdfFileReader/PdfFileWriter,并将.pages改为.getPage()循环。 - 检测条件失效:不同软件导出的PDF结构存在差异。部分纯文本生成器可能不写 /Font 而是直接压缩在 /Contents 流中。此时可将判断条件调整为
if page.get("/Contents"):或打印首尾页的page.keys()对照修改。 - 文件占用冲突:确保在代码执行期间没有外部编辑器(如Adobe Reader、WPS)打开该PDF,否则会出现权限拒绝报错。
以上就是使用Python批量删除PDF空白页的详细内容,更多关于自动化处理电子文档与提升办公效率的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









