Python处理海量复杂CSV数据:多进程与算法优化实战
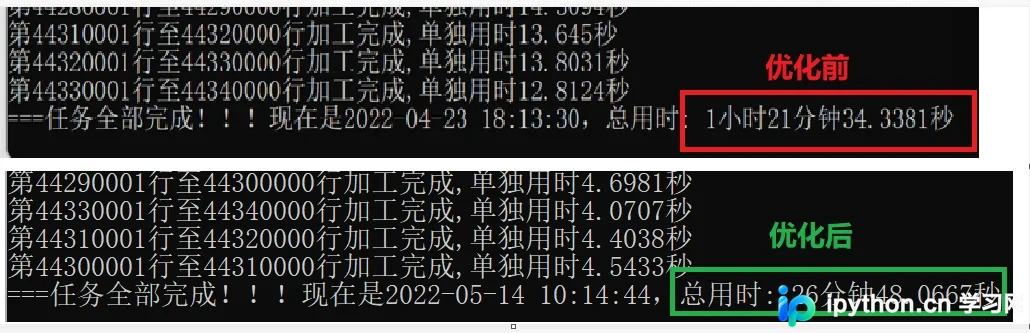
本文深入解析Python处理海量且逻辑复杂的CSV文件方案。针对千万级数据,采用分批读取、多进程计算与多线程I/O结合策略,利用chunksize与category类型优化内存。通过类对象映射、遍历算法重构及NumPy函数加速,显著提升处理效率,实现从小时级到分钟级的性能跨越。
2026-10-15
3

本文深入解析Python处理海量且逻辑复杂的CSV文件方案。针对千万级数据,采用分批读取、多进程计算与多线程I/O结合策略,利用chunksize与category类型优化内存。通过类对象映射、遍历算法重构及NumPy函数加速,显著提升处理效率,实现从小时级到分钟级的性能跨越。
本文详细介绍在 Go 语言中统计字符串内数字和英文字母数量的两种主流方法:基于 ASCII 码值的遍历与正则表达式匹配。通过基准测试数据对比,揭示了正则表达式在内存分配和耗时上的显著劣势,并推荐在高性能要求的 UGC 字数校验场景中优先使用字节遍历的 ASCII 法,以实现最优执行效率。
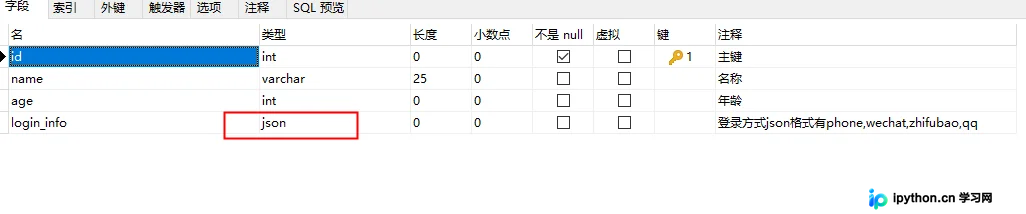
MySQL 5.7 原生支持 JSON 数据类型,适合存储结构灵活的用户画像或配置信息。本文详解如何通过 JSON_EXTRACT 提取数据、利用生成列优化查询性能,以及在 MySQL 8.0 中使用多值索引加速 JSON 数组检索,解决传统关系型字段扩展困难的问题。
本文针对PHP开发中在循环内执行数据库查询导致的性能瓶颈,提供从单点优化到批量处理的完整解决方案。通过对比分析,展示如何将N次查询降为1-3次,利用前置批量获取数据并在内存中组装,显著提升响应速度并降低服务器压力。
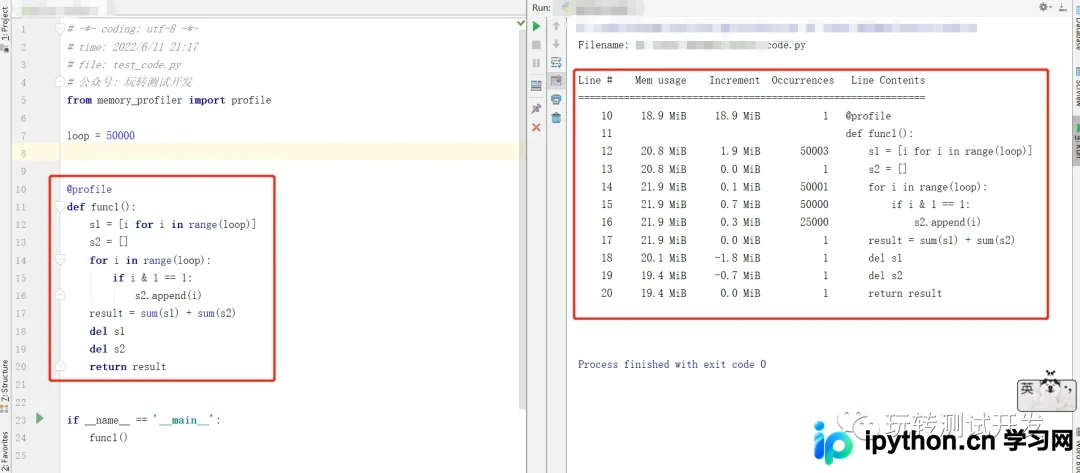
本文介绍Python第三方库memory_profiler的使用方法,用于监视进程内存消耗及逐行分析。通过装饰器@profile和命令行模式两种方式进行内存检测,支持终端直接打印或输出至文件并自定义精度,帮助开发者定位内存占用高的代码段。
针对业务数据量增长导致的缓存命中率降低问题,本文介绍在PHP开发中避免在for循环中进行DB操作的进阶优化方案。通过将全量预加载改为基于业务场景的按需精准批量查询(whereIn),显著提升数据获取效率与内存利用率,适用于高频列表展示等场景。
针对C++11标准库缺乏原生路径拼接功能的痛点,本文对比了基于std::stringstream的实现与手写C风格字符串处理方案的性能差异。测试表明,经过优化的C风格实现将平均耗时从2-4微秒降至0.2微秒左右,通过直接操作字符数组避免重复分配,显著提升高频调用下的效率。
本文介绍如何使用Go语言的singleflight机制解决热点Key缓存失效导致的数据库冲击问题。文章通过代码示例详细阐述了其去重合并请求的核心原理,展示了如何确保同一时刻对同一Key只执行一次数据获取操作,从而降低系统负载并优化高并发场景下的性能表现。
在 JavaScript 中,频繁使用加法运算符(+)拼接长字符串会导致严重的性能瓶颈,因为每次操作都会创建新的临时字符串对象。本文将通过代码对比分析直接拼接与数组推送两种方式的耗时差异,并详细讲解如何利用 Array.prototype.join() 方法实现高性能的字符串合并,适用于需要处理大量文本数据的场景。
本文汇总了五款实用的Python性能检测工具,涵盖内存占用、运行耗时及代码行级分析。通过memory_profiler、timeit、line_profiler及heartrate等工具,结合具体代码示例,展示如何精准定位程序瓶颈,帮助开发者优化Python应用效率。
当MySQL执行计划未达预期时,仅靠Explain难以得知优化器决策细节。本文介绍如何通过开启optimizer_trace追踪优化器生成执行计划的完整过程,通过cost成本计算排查索引误选原因,帮助DBA精准定位SQL性能问题。
本文详解 Go 语言的单元测试与基准测试方法,通过斐波那契数列案例演示 Test 函数的编写规范。介绍使用 go test -coverprofile 生成覆盖率报告并消除红区代码。进阶讲解基准测试(Benchmark)的时间控制、内存统计与并发测试,并通过缓存优化将算法性能提升约 28 倍。