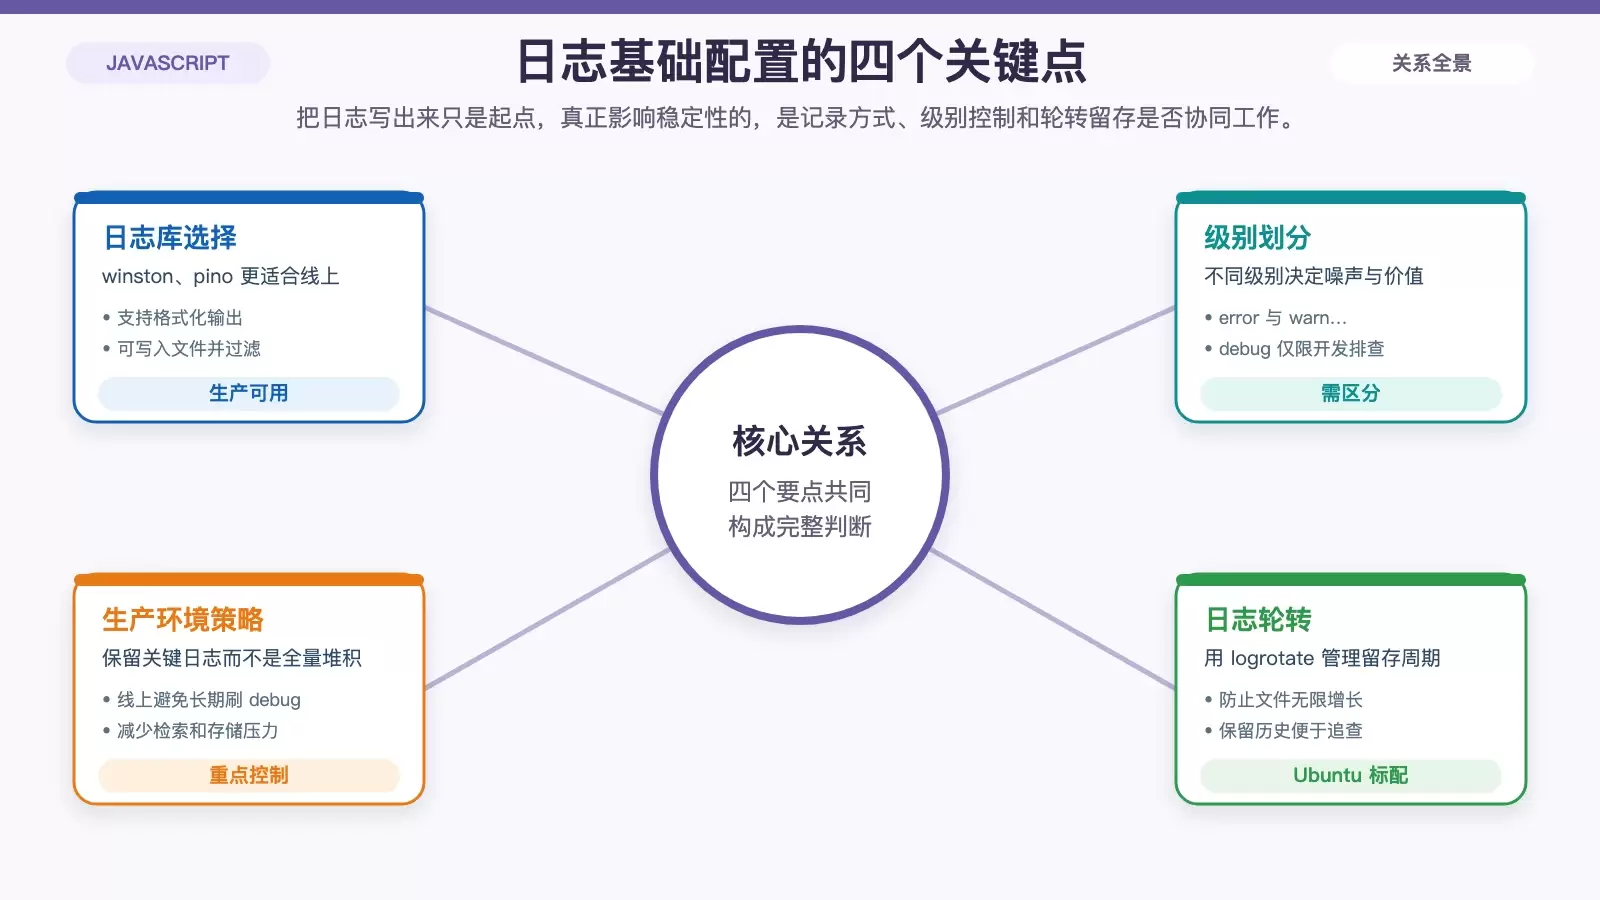
怎样利用日志提升 Ubuntu 上 JavaScript 应用的稳定性
在 Ubuntu 上提升 JavaScript 应用稳定性,关键不只是“把日志打出来”,而是把记录、留存、汇总、告警和代码异常处理串成一套可执行方案。本文从日志级别、轮转、集中管理到性能监控逐步梳理,帮助你判断哪些做法适合开发环境,哪些必须落实到生产环境。
2026-08-24
51

在 Ubuntu 上提升 JavaScript 应用稳定性,关键不只是“把日志打出来”,而是把记录、留存、汇总、告警和代码异常处理串成一套可执行方案。本文从日志级别、轮转、集中管理到性能监控逐步梳理,帮助你判断哪些做法适合开发环境,哪些必须落实到生产环境。
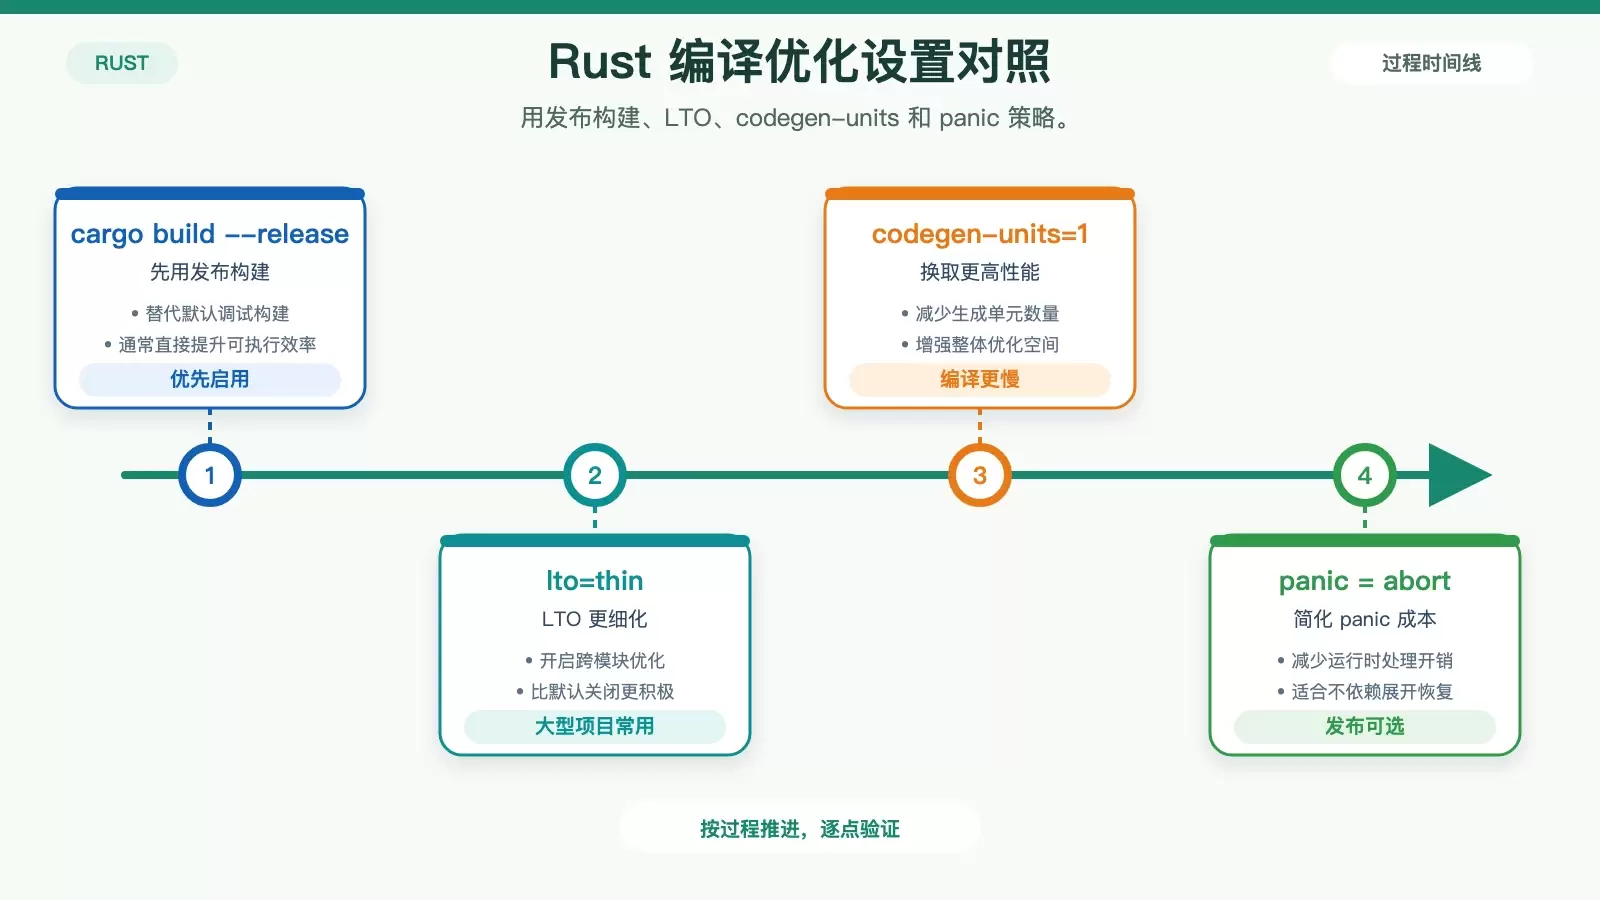
在 Ubuntu 上做 Rust 性能优化,通常先从编译参数入手,再回到数据结构、并发模型、内存分配和性能分析工具。本文按“先低成本、再定位瓶颈”的顺序整理可直接落地的技巧,保留关键命令、配置项和适用场景,便于判断哪些优化值得优先做。
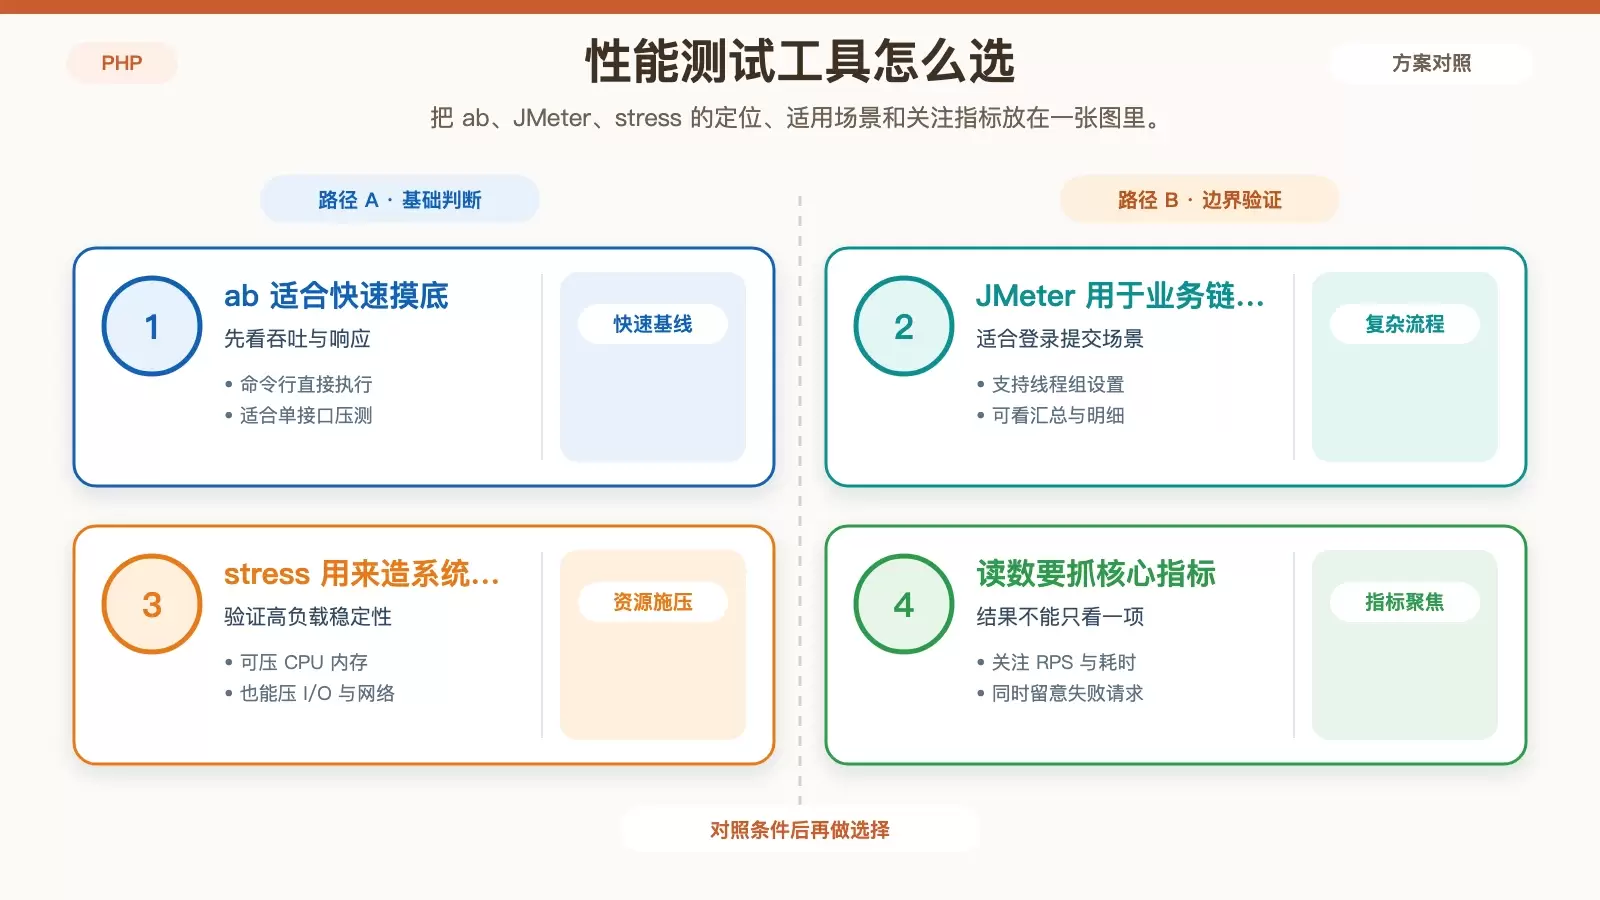
在 CentOS 上给 ThinkPHP 项目做性能测试,重点不只是“跑一遍压测”,而是保证环境一致、场景真实、指标可解释。本文按准备、工具使用、监控分析到优化落地的顺序,整理出一套可直接执行的方法,帮助你判断瓶颈究竟出在接口、系统资源还是数据库。
Nginx 性能调优不能只盯着几个参数,而要同时看配置、内核、硬件、缓存和监控。本文按“先改哪里、为什么改、要避开什么坑”的顺序梳理常见优化手段,并保留关键配置项、典型数值和适用场景,方便快速形成可执行的调优清单。
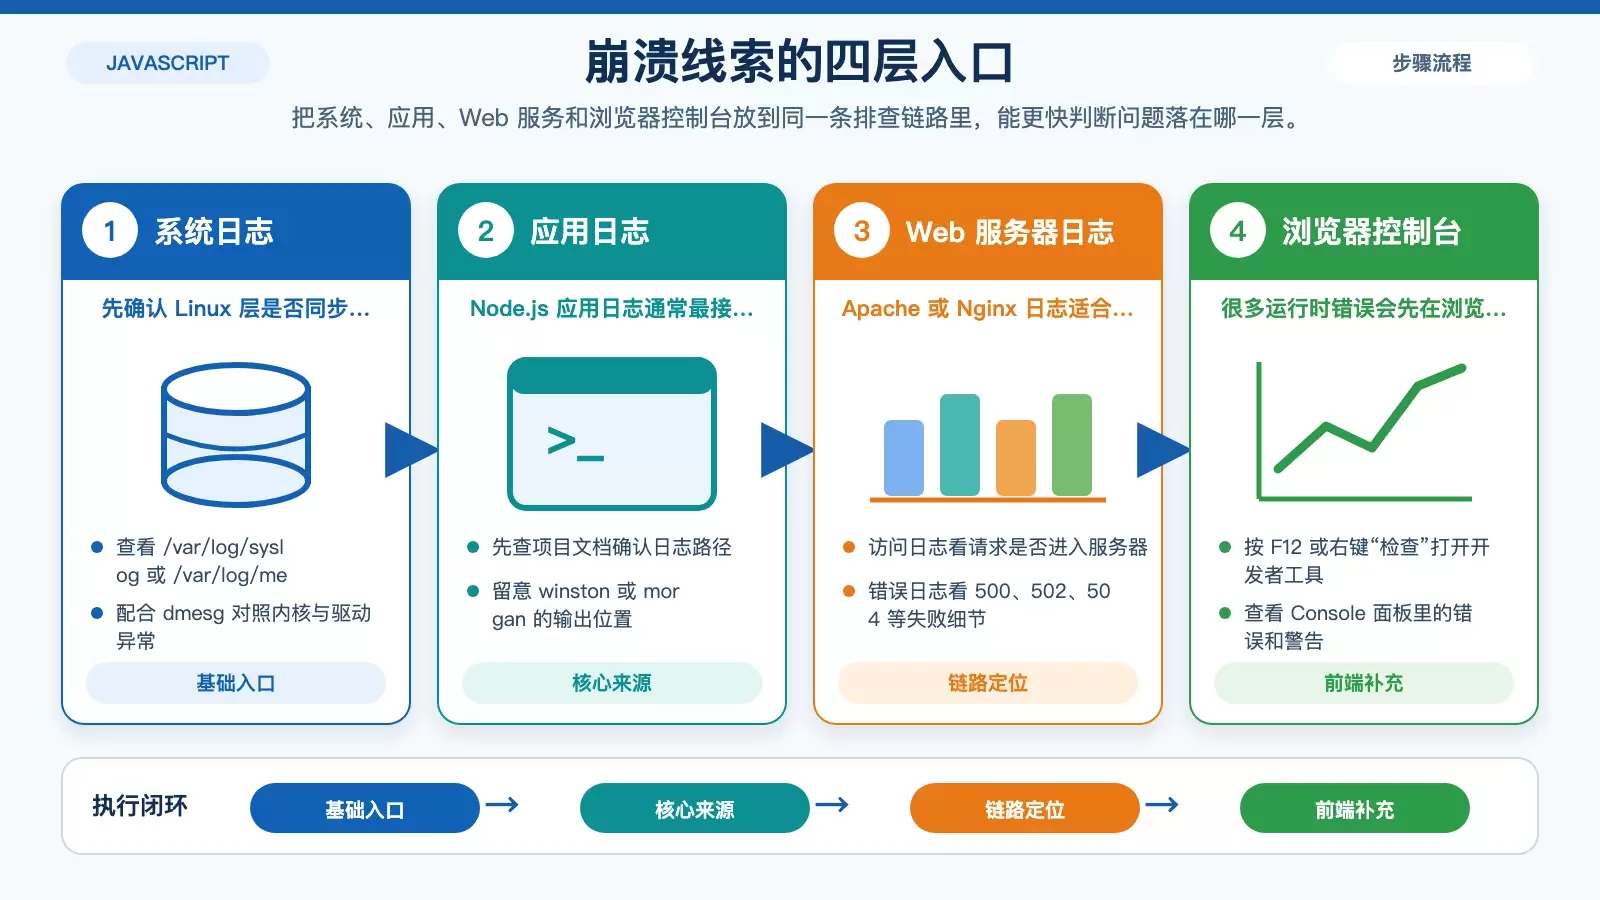
JavaScript 脚本在 Linux 上崩溃时,真正有用的线索往往分散在系统日志、应用日志、Web 服务器日志和性能监控里。本文按排查场景拆开说明每类信息能回答什么问题、该看哪些位置,以及怎样用时间戳和错误关键词把崩溃原因尽快收敛。
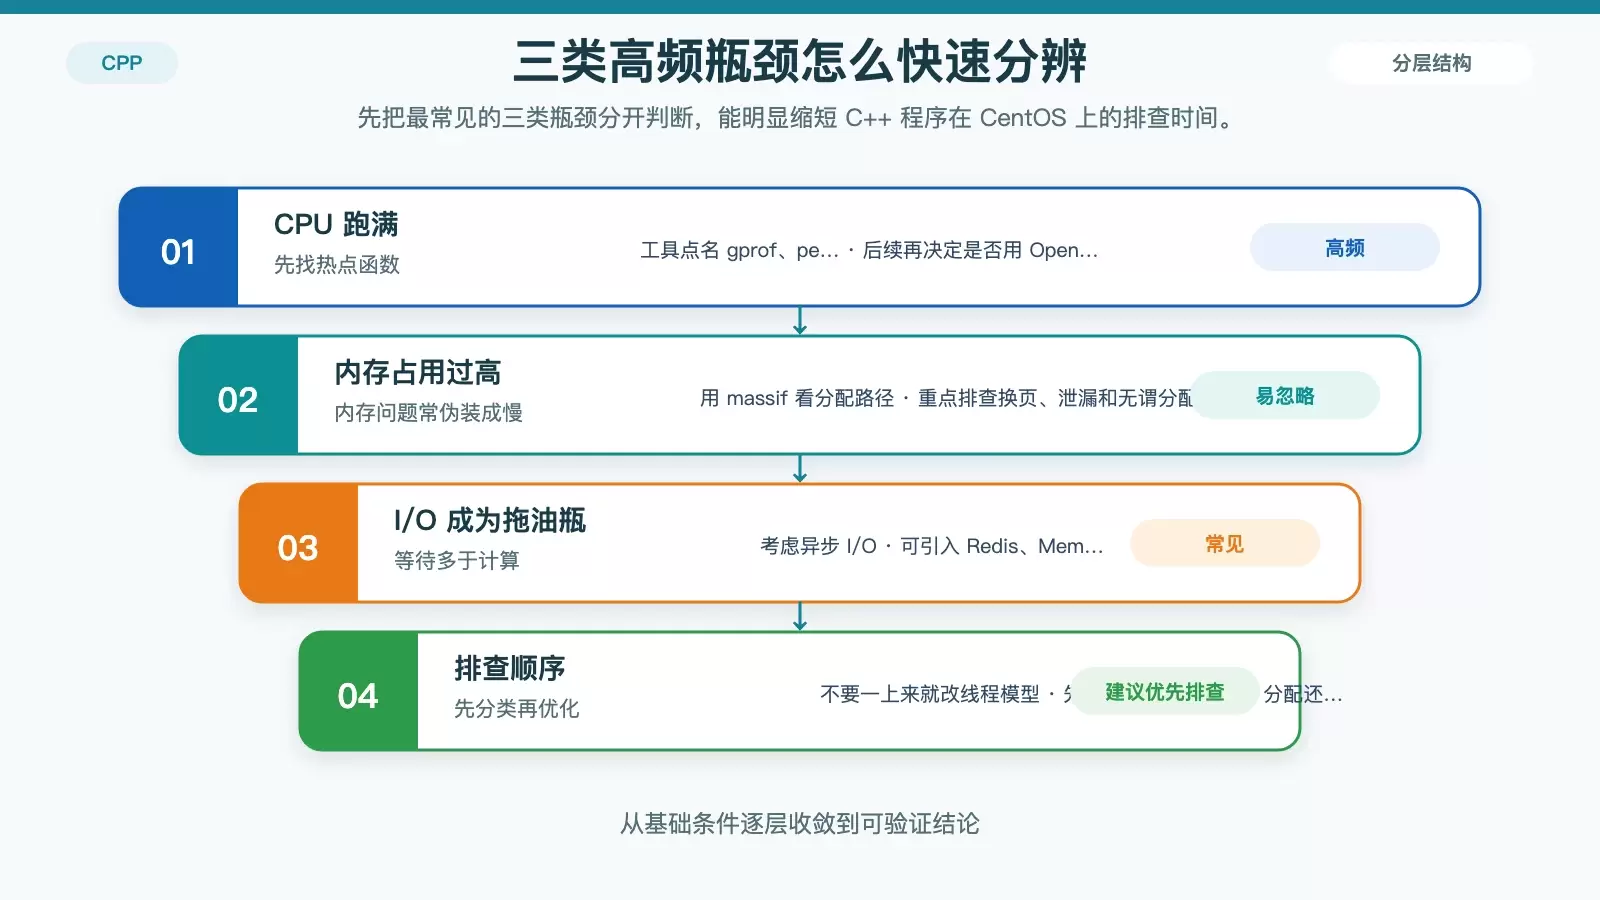
在 CentOS 上跑 C++ 程序时,性能问题通常不只出在代码本身,还可能落在内存、I/O、锁、网络、数据库甚至硬件层。本文按常见瓶颈逐类拆解,并给出对应的分析工具与优化方向,便于快速定位问题。
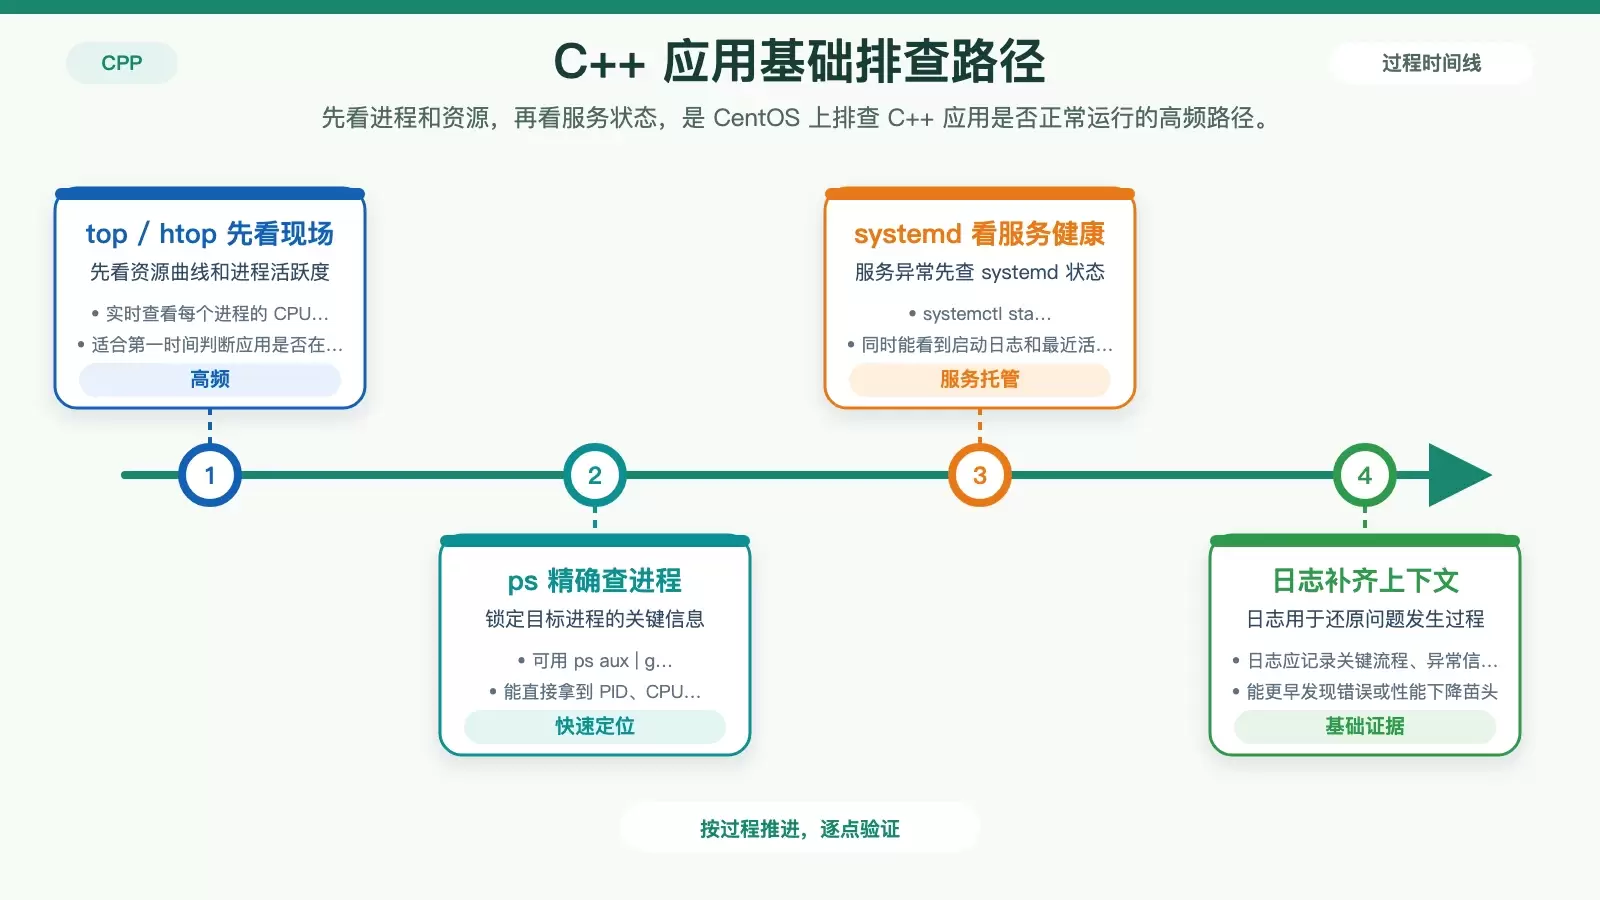
在 CentOS 上监控 C++ 应用,常见方案可以分成命令行巡检、服务与日志排障、性能分析,以及长期可视化监控四类。本文按使用场景梳理每种方法的作用、适用边界和常用命令,方便你快速组合出适合开发或生产环境的监控方案。
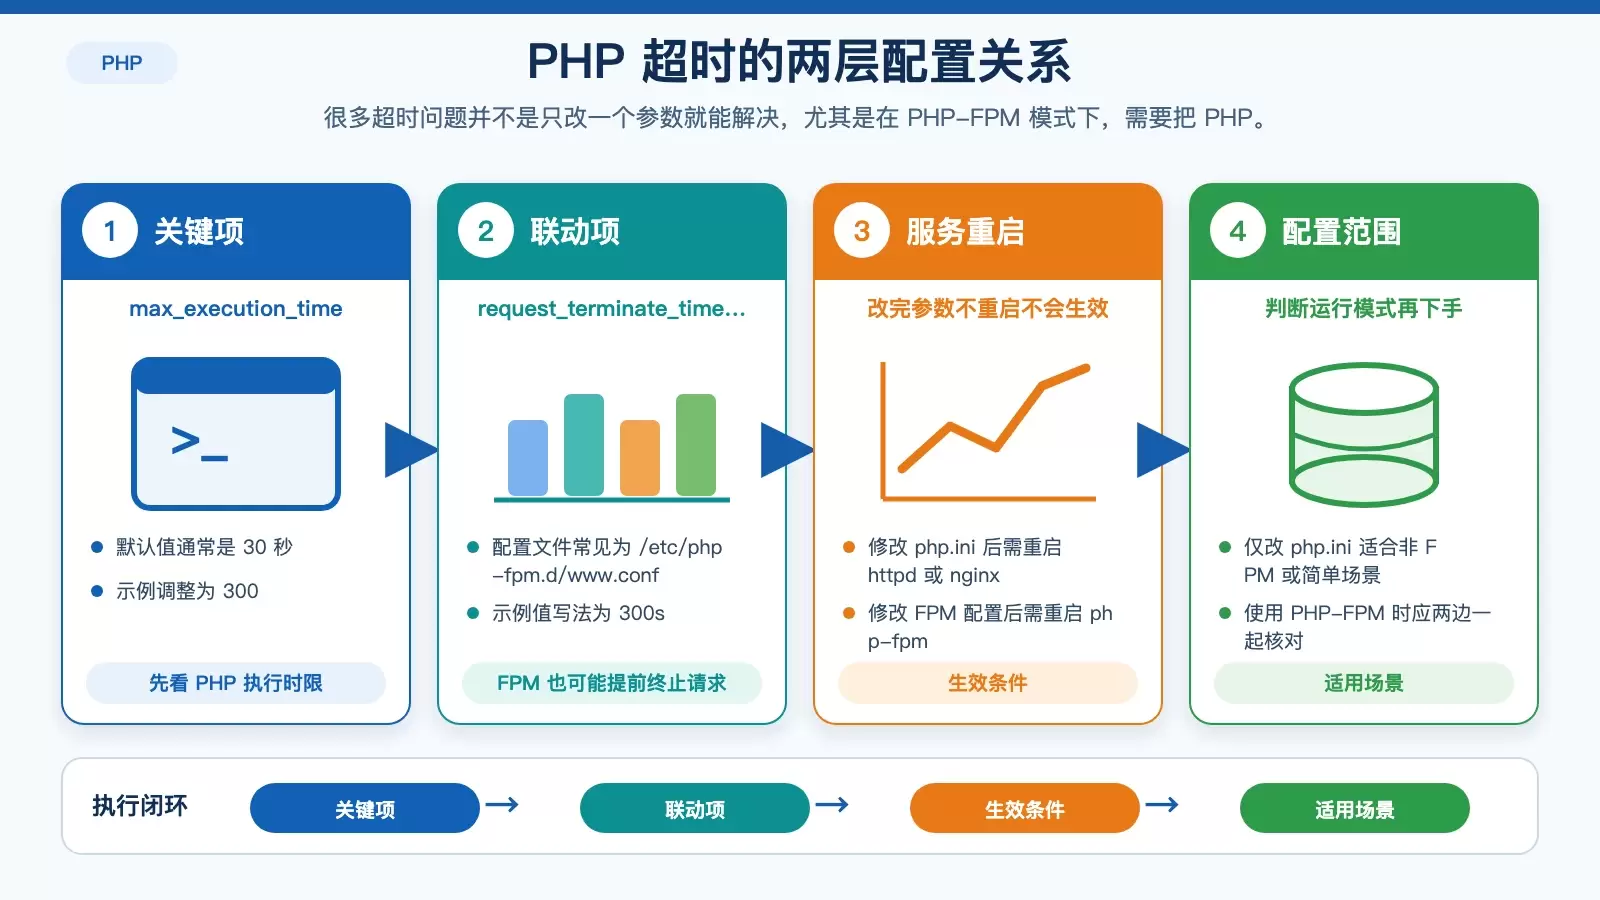
CentOS 上的 PHP 超时,通常不只是把 `max_execution_time` 从 30 秒改大这么简单。本文按全局配置、单脚本放宽、PHP-FPM 联动和性能排查四个层次梳理处理方法,保留关键命令、配置项和常见路径,方便你快速判断该改哪里、何时该转向查瓶颈。
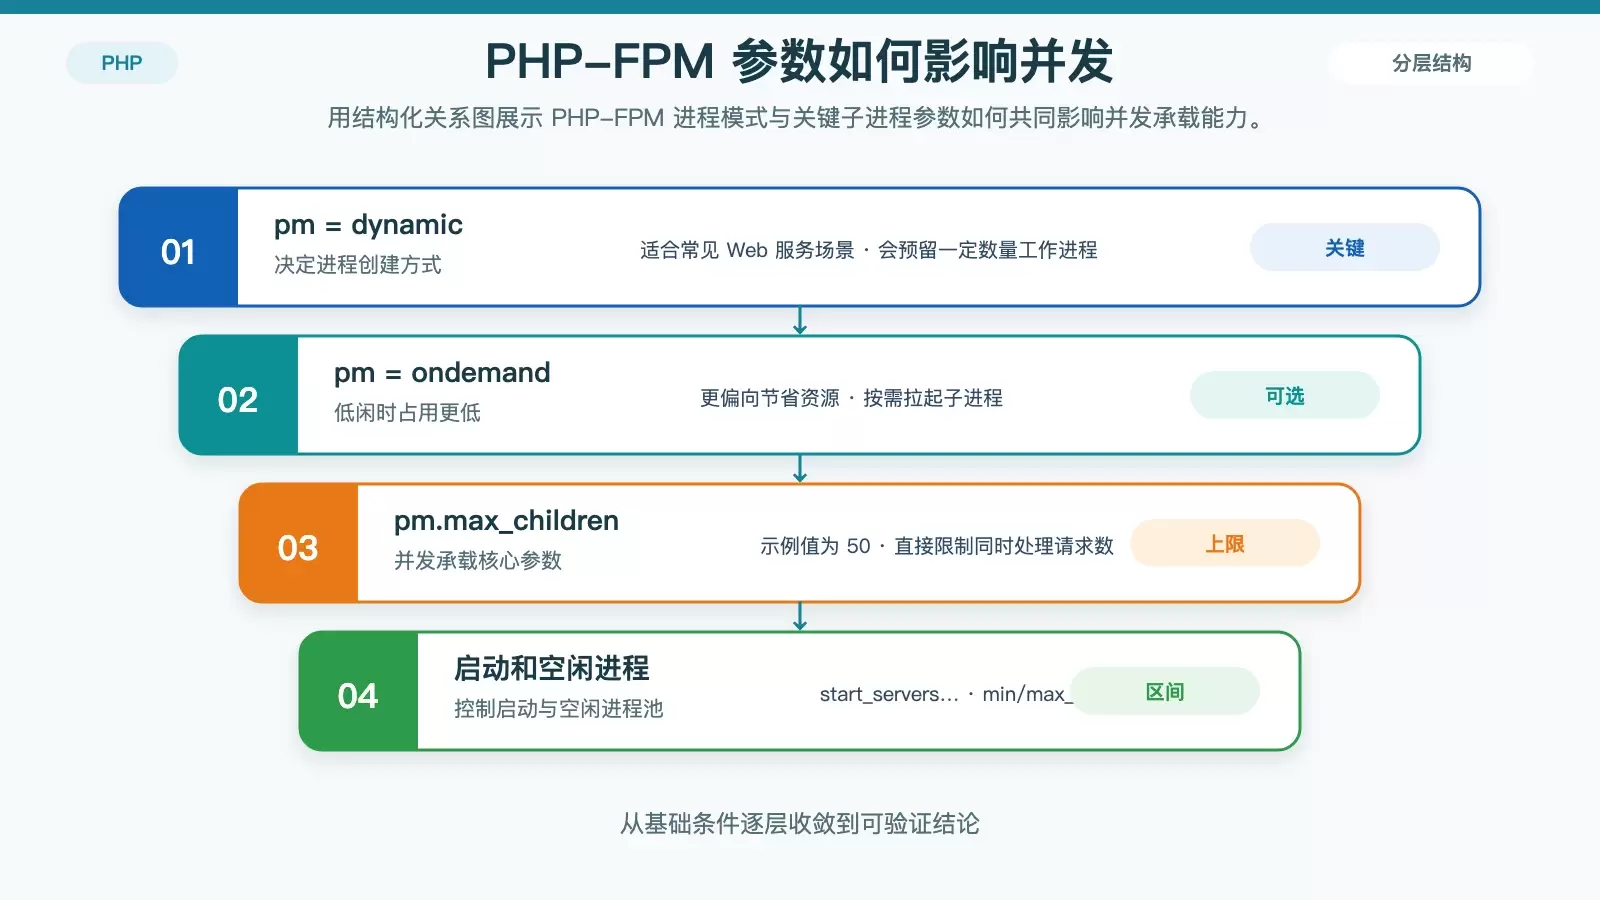
在 Ubuntu 上提升 PHP 并发,核心不是单独调大某一个参数,而是把 PHP-FPM、内存、OPcache、Web 服务器与监控手段配合起来。本文按实际排查顺序梳理关键配置项、适用场景和修改后的验证要点,便于你判断瓶颈究竟出在进程数、缓存、请求入口还是硬件资源。
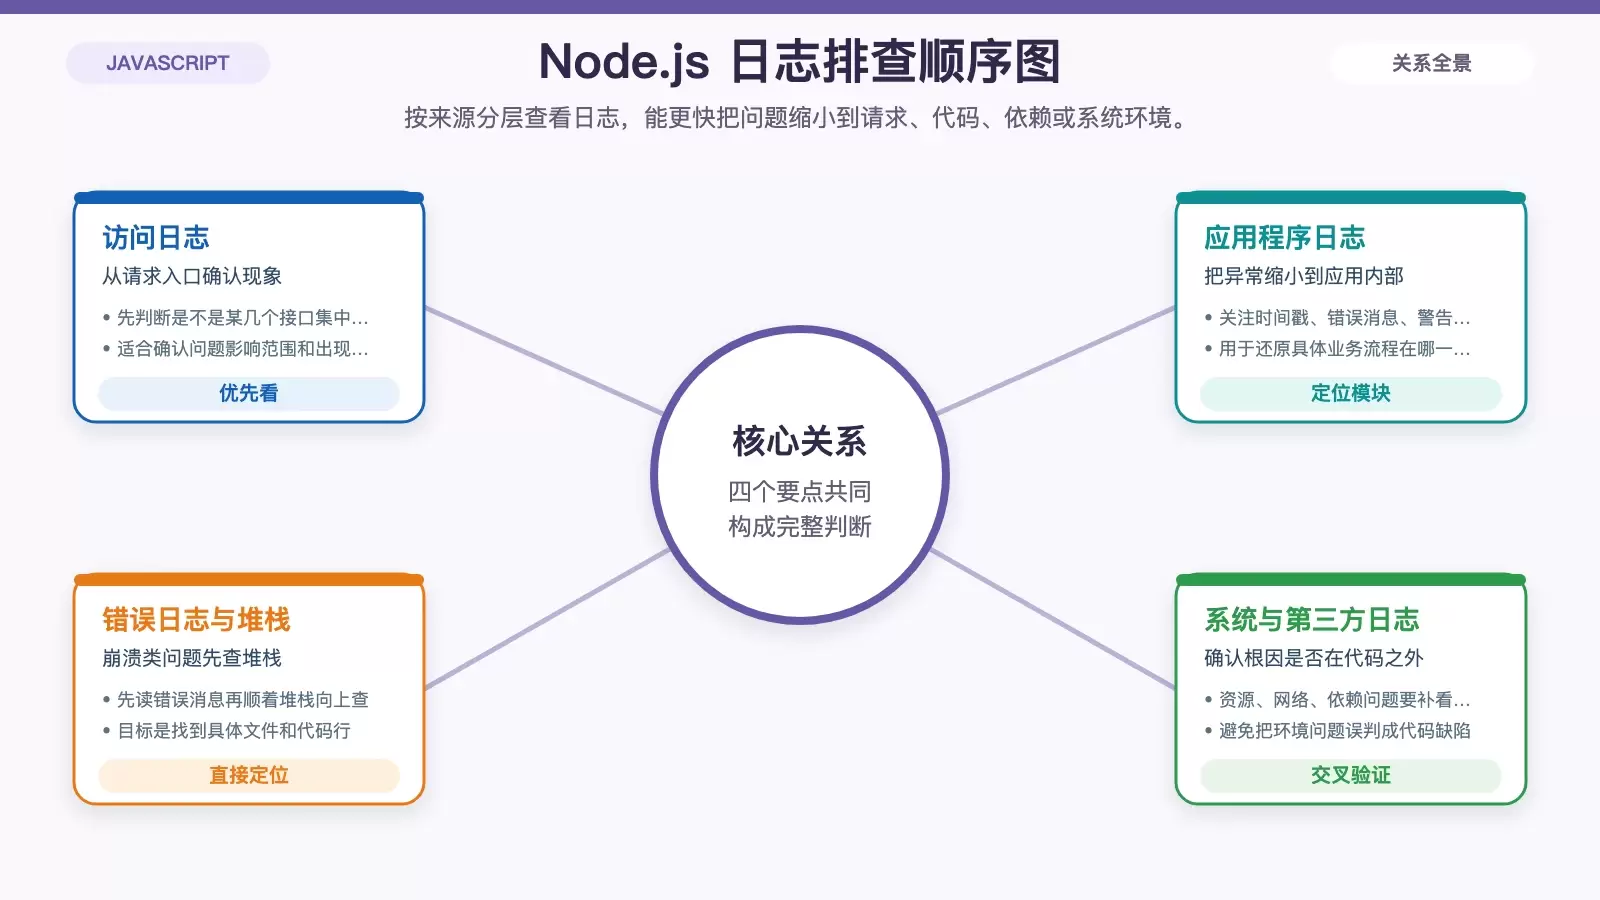
Node.js 部署在 Debian 后,真正难的往往不是“有没有日志”,而是出了问题该先看哪一类、每类日志该抓什么信号。本文按应用日志、系统日志、错误堆栈、第三方库日志和访问日志逐项拆解,帮你建立一套更适合日常排障和性能分析的读法。
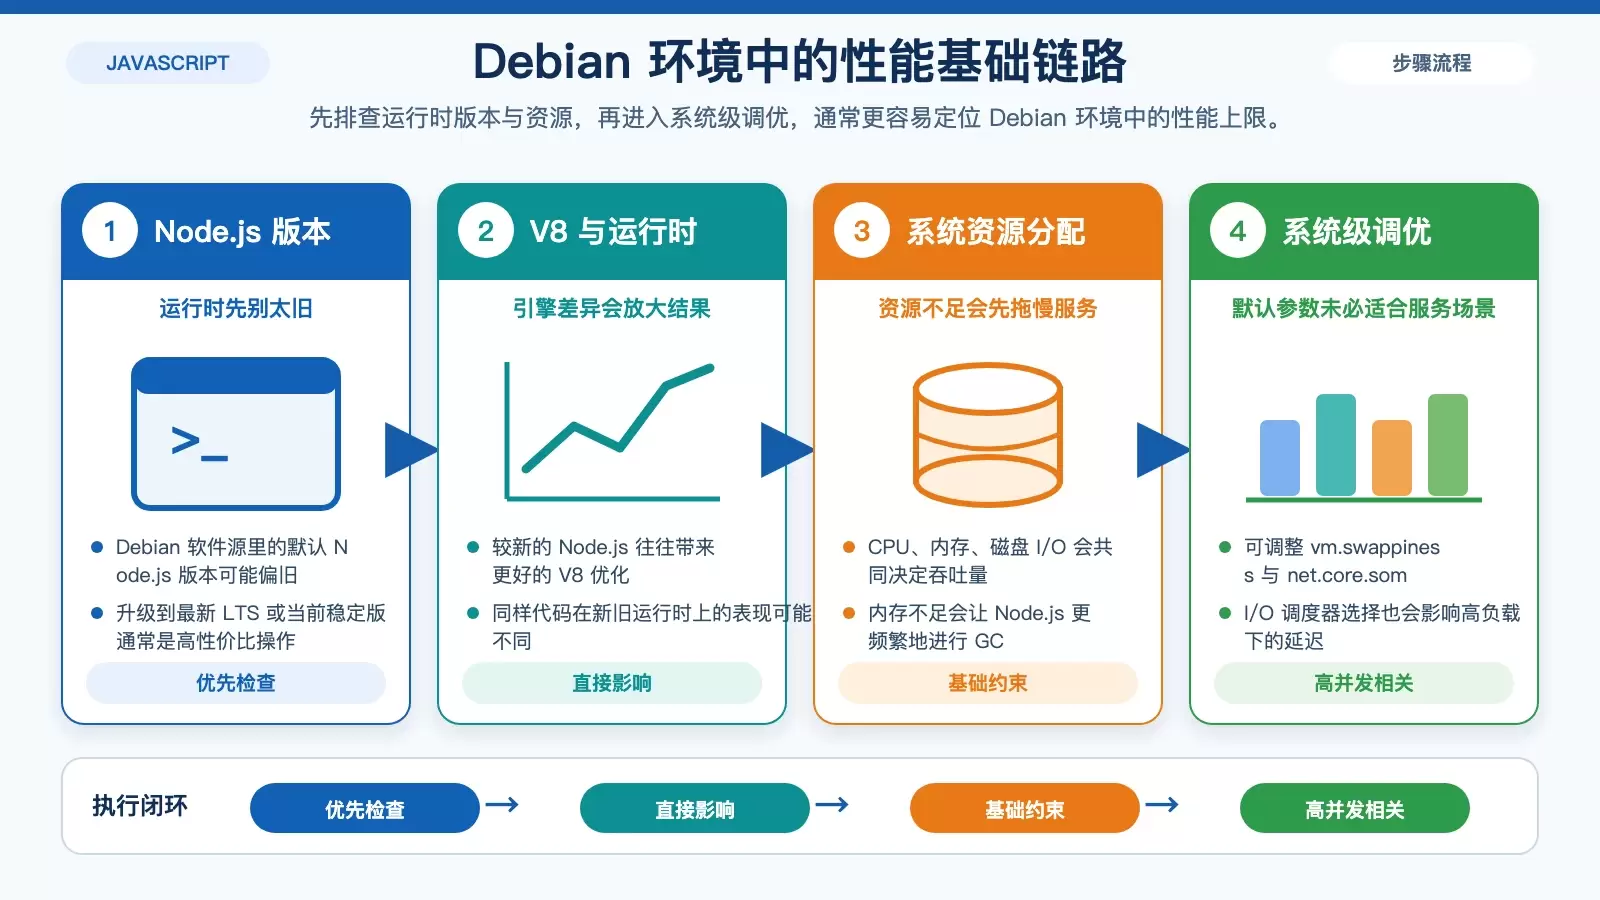
Debian 不会直接决定 JavaScript 的执行效率,但它会通过 Node.js 版本、系统资源、内核参数和网络路径影响应用上限。判断性能问题时,先分清系统环境瓶颈和代码层瓶颈,优化方向才不会跑偏。 很多人会把 Debian 和 JavaScript 性能看成两条互不相干的线,但真正上线部署时,操作系统环境往往决定了应用能不能稳定跑出预期表现。
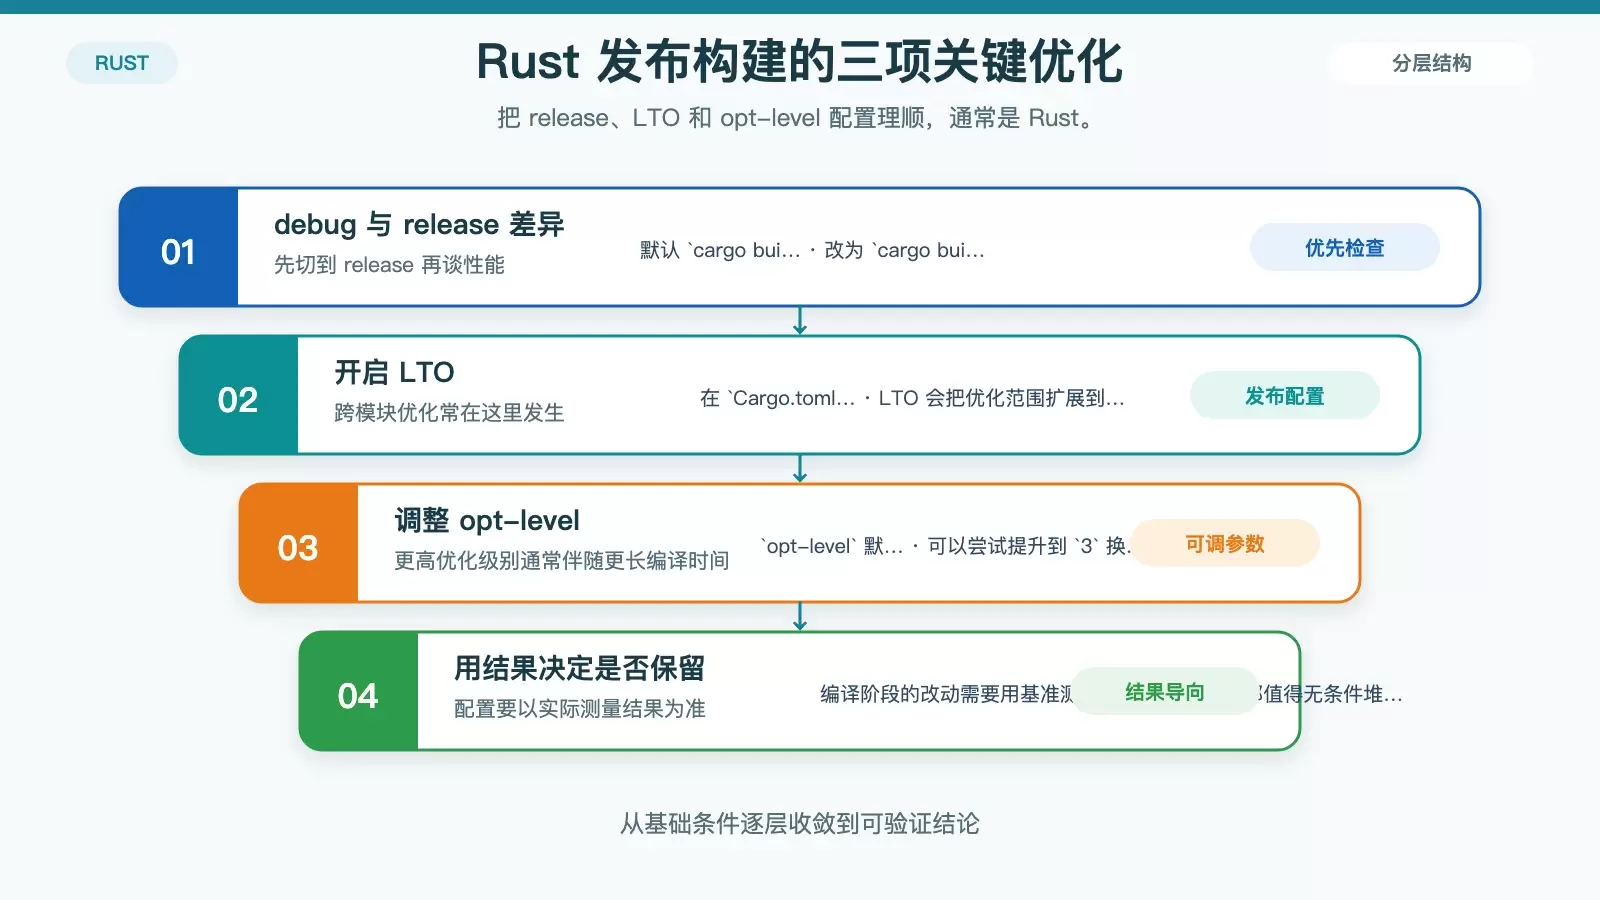
Rust 在 Linux 上的性能优化不能只盯着一处,编译参数、代码写法、系统配置和分析工具都可能决定最终结果。本文按“先测量、再调优”的顺序梳理常见手段,保留可直接使用的命令、配置项和适用场景,方便你逐项排查瓶颈。