


在 Debian 上运行 Node.js 应用时,日志既是故障排查入口,也是判断系统是否稳定的日常依据。但很多人面对一堆输出时,容易把应用问题、系统问题和依赖问题混在一起看,结果越看越乱。更实用的方式,是先分清日志来源,再针对不同字段判断是代码异常、资源瓶颈,还是请求流量本身出了变化。
先看应用程序日志:判断业务流程哪里开始异常
应用程序日志是 Node.js 服务最直接的一层信息,通常由应用自身输出,记录请求处理过程、错误、警告以及关键业务状态。无论是自己封装日志方法,还是使用 Winston、Morgan 这类日志库,核心目标都一样:把运行时发生了什么清楚地记下来。
解读这类日志时,建议优先盯住几类字段:
- 时间戳:确认问题发生的准确时间,方便和系统日志、访问日志交叉比对。
- 错误消息:先判断是业务校验失败、依赖调用失败,还是未捕获异常。
- 警告信息:很多性能抖动或即将发生的故障,最早就是从 warning 暴露出来的。
如果你的应用日志足够规范,通常可以很快回答两个问题:故障最先出现在哪个模块,以及异常是偶发还是持续发生。对线上服务来说,这一步往往比一上来翻系统层信息更高效。
再看 Debian 系统日志:排除资源和环境层面的根因
当应用日志只能告诉你“出错了”,却解释不了“为什么突然出错”,就该去看 Debian 的系统日志。系统日志覆盖内核、服务、硬件和资源状态,很多 Node.js 服务异常其实根因都在这一层,比如内存耗尽、磁盘空间不足,或者网络连接抖动。
在 Debian 上,可以通过 journalctl 查看系统日志。真正有价值的不是把日志从头翻到尾,而是重点关联 Node.js 服务运行期间的几类异常信号:
- 内存压力:是否存在内存被打满、进程被系统回收的迹象。
- 磁盘状态:日志写入失败、临时文件异常、空间不足都可能直接影响服务。
- 网络异常:依赖数据库、缓存、外部 API 的服务,经常会因为网络波动表现成“应用报错”。
这类日志的价值在于,它能帮助你判断问题是不是出在 Node.js 本身。如果系统层已经出现资源告警,那么继续只盯着业务代码,通常很难找到真正原因。
重点读错误日志和堆栈:把问题定位到具体代码行
Node.js 在遇到无法自行处理的异常时,通常会留下更详细的错误日志,其中最关键的部分就是错误消息和堆栈跟踪。对崩溃、启动失败、接口直接 500 这类问题来说,这是最值得优先处理的一手资料。
解读时可以按这个顺序来:
- 先看错误消息,判断异常类型,例如参数问题、模块加载失败、权限不足或运行时引用错误。
- 再看堆栈跟踪,从最靠近报错位置的调用层开始,确认具体文件和代码行。
- 最后结合出错前后的应用日志,判断这是单次触发,还是某个固定流程稳定复现。
很多排障之所以效率低,不是因为日志不够,而是把堆栈只当作“报错附带信息”。实际上,堆栈本身就是定位入口,能直接把排查范围从整套服务缩小到具体模块甚至某一行代码。
别忽略第三方库日志:问题常常不在业务代码里
实际项目里的 Node.js 应用,往往依赖数据库驱动、认证中间件、消息队列客户端、HTTP SDK 等第三方库。这些组件很多都有独立日志能力,而且它们报出来的问题,经常比应用层提示更接近根因。
阅读第三方库日志时,可以重点关注:
- 连接超时:常见于数据库、Redis、消息队列等外部依赖不可用或响应过慢。
- 异常行为提示:例如重试过多、连接池耗尽、握手失败。
- 版本兼容警告:升级 Node.js、驱动或中间件后,这类信息尤其值得注意。
如果应用日志只显示“请求失败”或“服务不可用”,但第三方库日志明确给出了连接错误、协议错误或兼容性警告,那么基本就能确认排查重点不在业务逻辑,而在依赖环境或组件配置。
用访问日志看流量和性能:谁慢、谁错、谁最常被调用
对于使用 Express 等 HTTP 框架的 Node.js 服务,访问日志是观察接口表现最直接的数据来源。它记录的不是“程序内部发生了什么”,而是“外部请求是怎么打进来的,以及服务怎么响应了这些请求”。
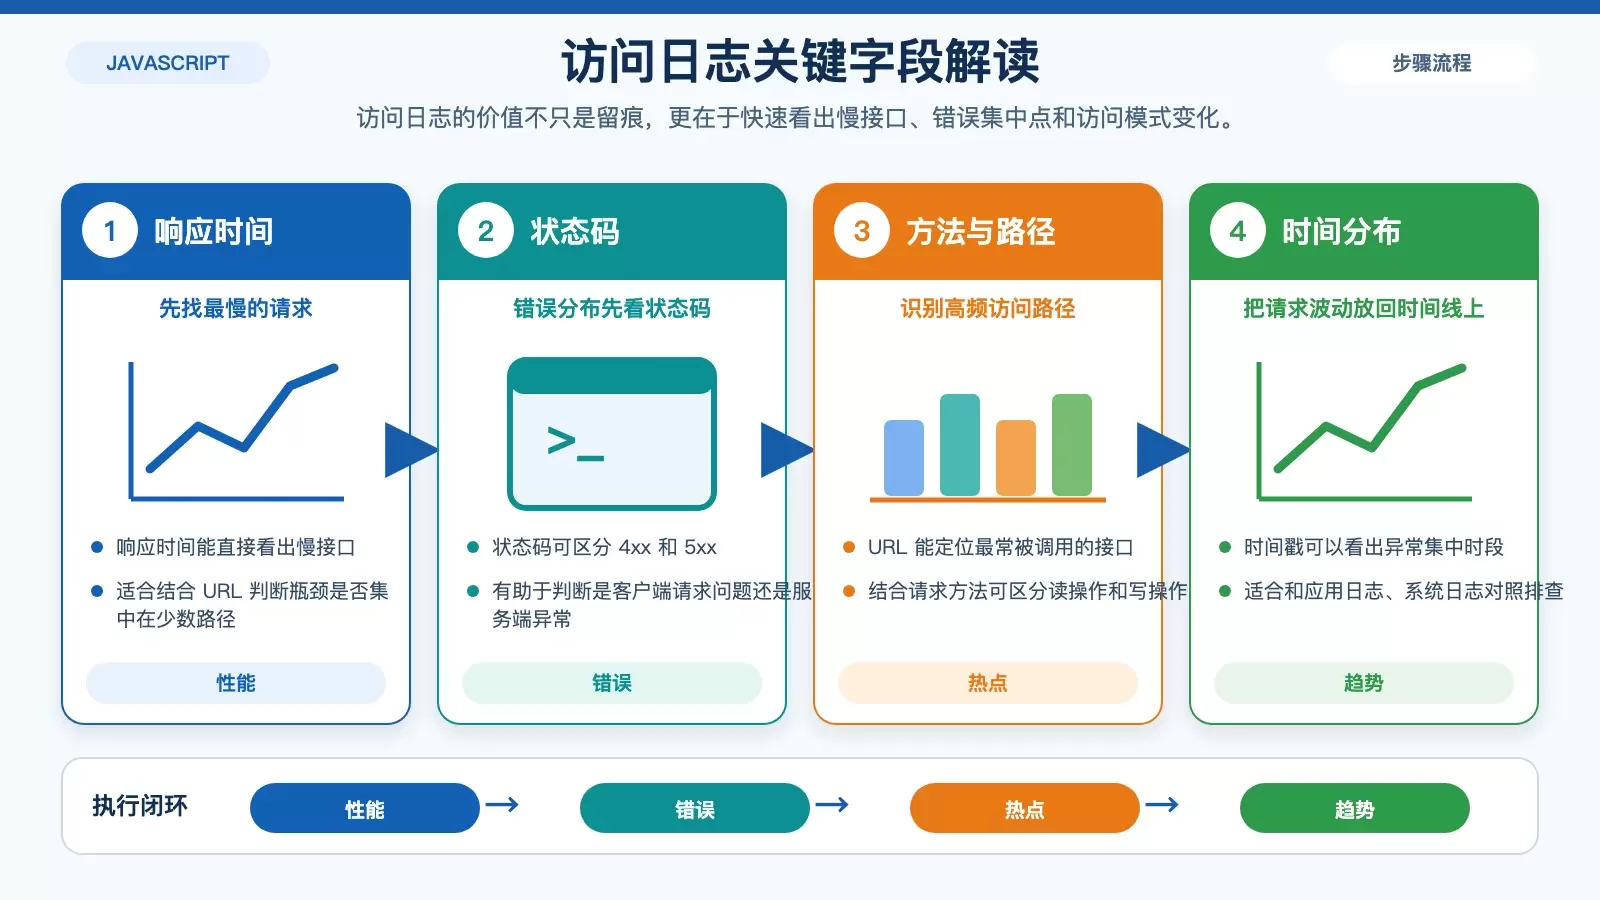
一条典型访问日志通常会包含这些信息:
- 时间戳:确认请求集中出现的时段。
- 请求方法:例如
GET、POST,帮助区分读写操作。 - URL:定位具体接口或路径。
- 状态码:识别 4xx、5xx 是否集中在某一类请求。
- 响应时间:判断性能瓶颈是否已经影响用户体验。
访问日志最适合回答三类问题:哪些接口最慢、哪些请求最容易报错、最近的访问模式有没有变化。它对性能优化、容量评估和故障复盘都很有帮助,尤其适合和应用日志一起使用,建立“外部请求”与“内部执行”之间的对应关系。
实际排查时怎么组合看:按来源分层,比混着翻更有效
把 Node.js 在 Debian 上的日志读明白,关键不只是“知道有哪些日志”,而是形成一套稳定的阅读顺序。一个更实用的做法是:
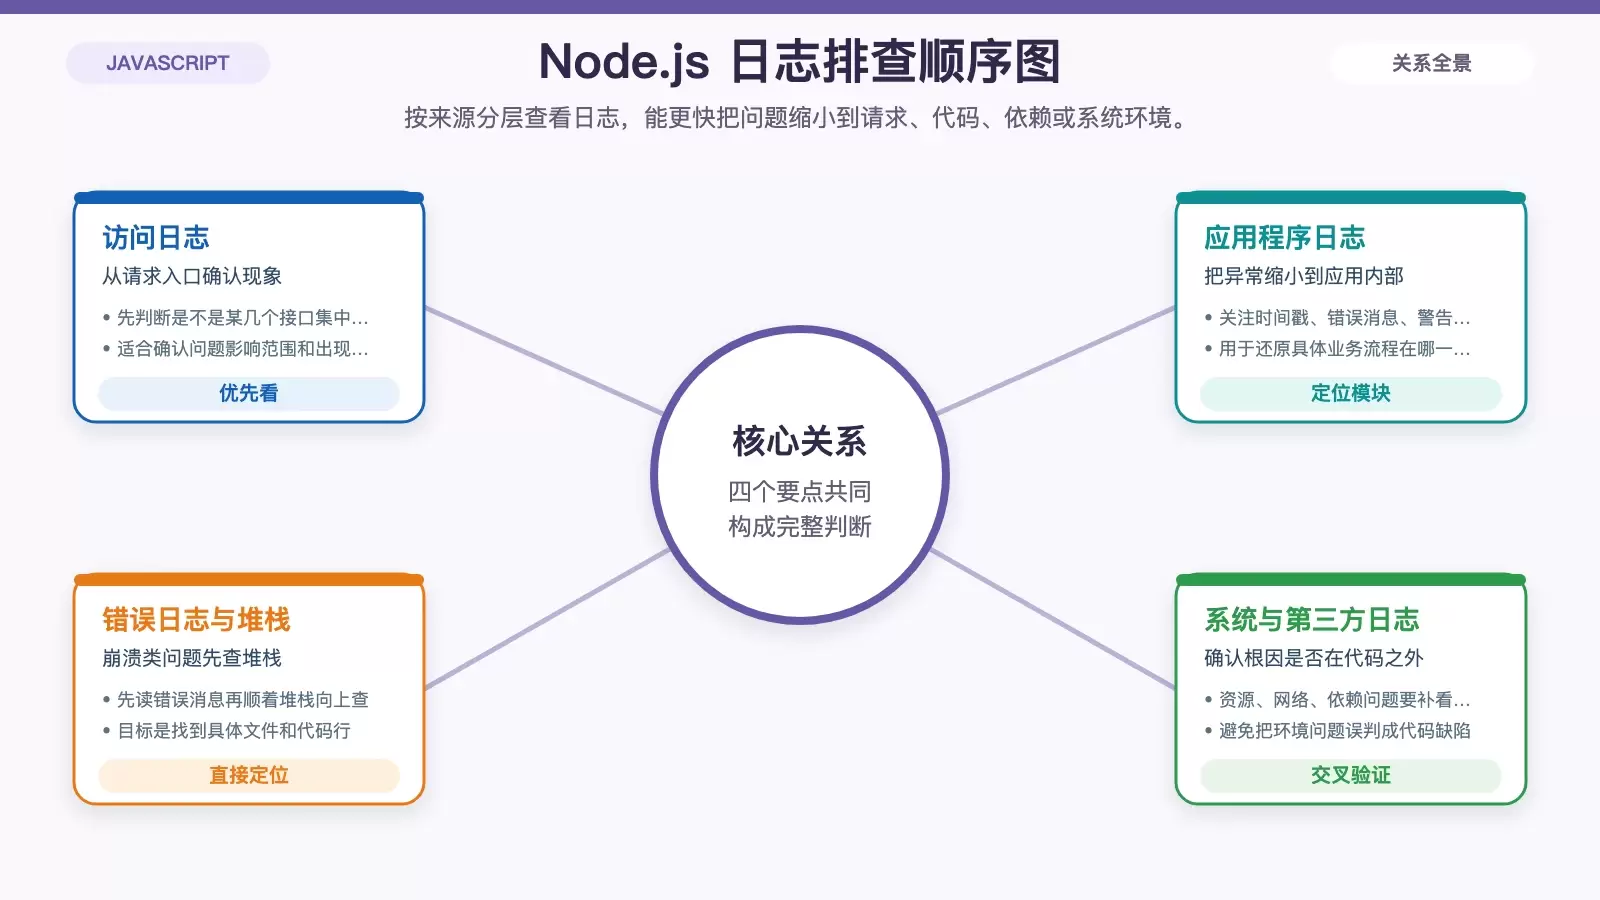
- 先从访问日志确认问题影响了哪些接口、出现频率如何。
- 再看应用程序日志,定位异常模块和业务流程。
- 如果存在崩溃或未捕获异常,继续查错误日志和堆栈。
- 若现象和资源、网络、进程状态有关,再去核对journalctl 里的系统日志。
- 涉及数据库、认证、缓存或外部服务时,补看第三方库日志。
前期配置同样重要。像 Winston 适合做结构化应用日志,Morgan 适合处理访问日志;日志级别、输出格式和字段设计越清晰,后续判断就越快。等到线上出问题再临时补日志,通常已经错过了最佳排查窗口。
说到底,日志不是只在故障时才有用。平时持续观察这些关键信号,往往更容易提前发现性能退化、依赖异常和资源风险,把问题处理在真正影响用户之前。









