pandas通过字典生成dataframe的方法步骤
本文详解在Python中使用pandas库通过字典创建DataFrame的两种主要方法。首先介绍单个字典输入时要求所有值列表长度一致;其次讲解多字典列表输入时如何处理键值缺失及自动对齐。包含具体代码示例与错误处理说明,帮助开发者快速掌握数据框构建技巧。
2026-10-13
3

本文详解在Python中使用pandas库通过字典创建DataFrame的两种主要方法。首先介绍单个字典输入时要求所有值列表长度一致;其次讲解多字典列表输入时如何处理键值缺失及自动对齐。包含具体代码示例与错误处理说明,帮助开发者快速掌握数据框构建技巧。
本文详解pandas中SettingWithCopyWarning警告的产生机制,通过复现案例对比直接索引与.loc方法的差异,指出使用.loc进行链式赋值可避免该警告,并提供代码修正示例,帮助开发者规范DataFrame操作习惯。
本文深入解析pandas中concat()函数的核心用法,详细讲解objs、axis、join、ignore_index等关键参数的具体含义与配置方法。通过outer并集与inner交集两种连接模式的代码示例,展示如何处理索引对齐、层级索引构建及数据复制优化,帮助开发者高效实现多DataFrame的数据合并。
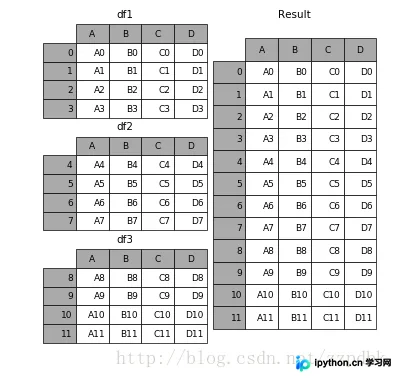
本文深入解析pandas库中pd.concat函数的核心用法,详细讲解objs、axis、join等关键参数的配置方法。通过相同字段首尾相接、横向拼接、忽略索引及增加分组键等多种场景示例,展示如何实现Series和DataFrame的高效合并与重塑,帮助开发者掌握数据整合技巧。
本文介绍在 pandas DataFrame 中对指定列进行逻辑处理并生成新列或覆盖原值的方法。通过 df.apply 结合 lambda 函数,可实现按行处理数据。示例展示了如何根据列内容匹配特定关键词,利用正则表达式判断条件并赋值,适用于自动化测试分类等场景。
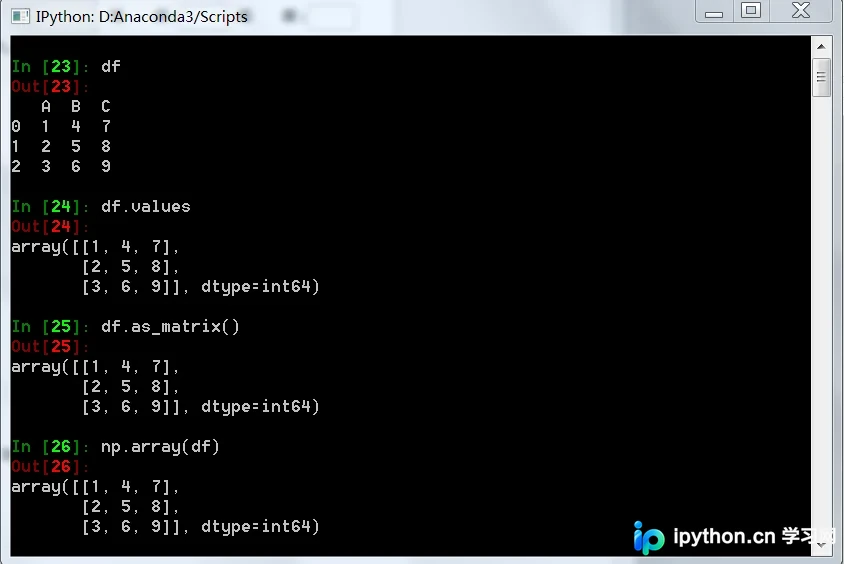
本文介绍了在Python数据分析中,将Pandas DataFrame转换为Numpy array的三种常用方法。通过导入必要的模块并创建示例数据,详细演示了使用values属性、as_matrix()函数以及np.array()函数的具体操作。这三种方法均能实现类型转换,适用于不同的数据处理场景。
本文介绍Python中Pandas库的核心数据结构Series和DataFrame。Series是一维带标签数组,支持列表和字典创建;DataFrame是二维表格型数据,支持嵌套列表和字典实例化。文章通过代码示例演示了如何创建对象、设置自定义索引及列名,帮助初学者快速掌握Pandas基础用法。
本文介绍如何利用pandas的to_sql方法将DataFrame数据保存至数据库。重点解析chunksize批量处理、if_exists冲突策略及index索引控制等关键参数,结合MySQL连接与数据汇总示例,展示从数据读取、处理到入库的完整流程。
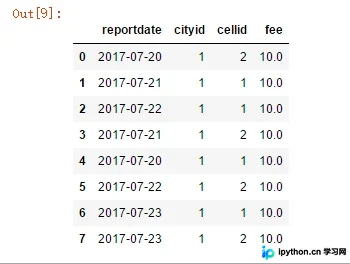
本文详解 pandas DataFrame 的行列索引创建与值提取方法。通过 index 和 columns 参数自定义索引,演示如何获取单列、单行及特定单元格数值。结合车站客流数据实例,展示利用 iloc 和 loc 进行数据筛选与统计计算,如查找最大客流车站及其日均值对比。
本文详解如何在 Python Pandas 中高效获取满足特定条件的行索引。对比了低效的迭代方式,重点介绍了使用布尔索引直接获取 index 列表的方法,并深入解析了 iloc(位置索引)与 loc(标签索引)的区别。同时提供了利用 np.flatnonzero 获取序数索引的技巧,帮助开发者避免常见的索引混淆错误。
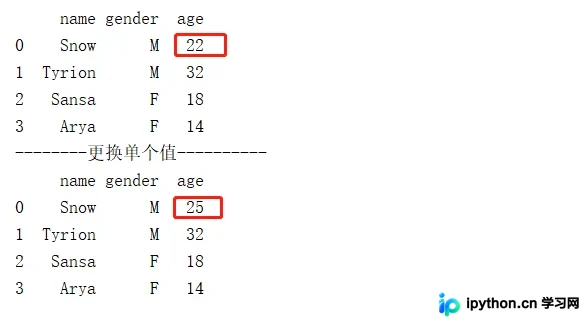
本文介绍如何使用Pandas库修改DataFrame中的特定值,包括使用loc、iloc、at和iat方法。同时详细讲解如何在DataFrame末尾或指定位置新增列,以及如何通过append方法添加新行,提供完整代码示例和注意事项。
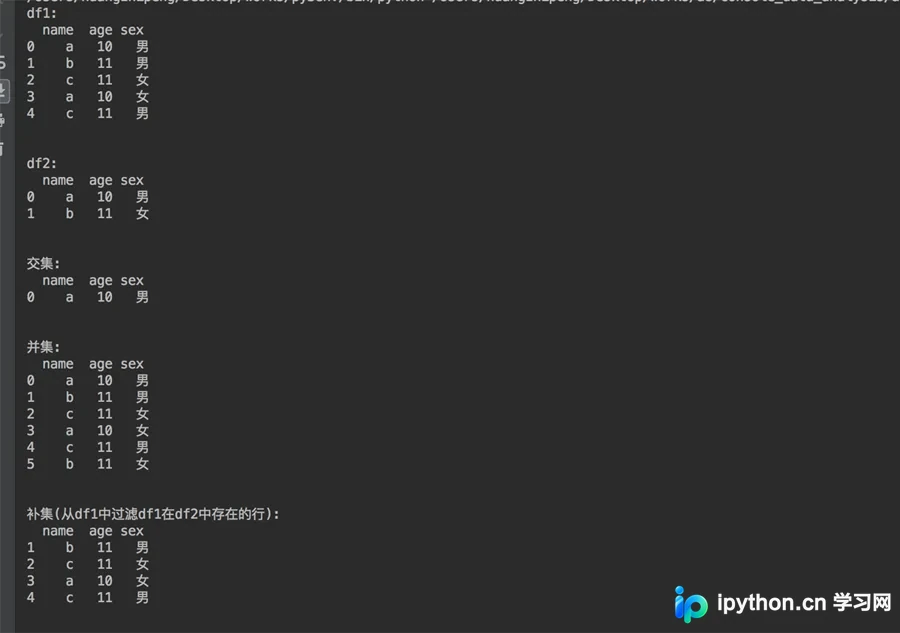
本文介绍在 columns 相同的 DataFrame 中进行集合运算的方法。利用 pd.merge 配合 on 参数可获取交集,设置 how='outer' 获取并集。对于补集(从 df1 中剔除 df2 存在的行),通过 append 合并后使用 drop_duplicates 保留唯一值实现。