Python中Pandas库的核心数据结构与导入方法详解
本文详细介绍Python数据分析库Pandas的核心数据结构,包括Series、DataFrame和Panel的定义与区别,重点讲解DataFrame作为二维表格型数据容器的应用。同时提供Pandas的安装命令及模块导入的标准写法,帮助开发者快速上手处理金融时间序列及多维数据集。
2026-10-13
8

本文详细介绍Python数据分析库Pandas的核心数据结构,包括Series、DataFrame和Panel的定义与区别,重点讲解DataFrame作为二维表格型数据容器的应用。同时提供Pandas的安装命令及模块导入的标准写法,帮助开发者快速上手处理金融时间序列及多维数据集。
本文详细介绍Python中pandas库创建DataFrame的多种方法,包括从字典和列表构建数据框、指定列名与顺序、修改列名以及生成随机整数数据。同时演示如何使用时间序列作为索引,并简要提及类SQL操作功能,帮助开发者快速掌握DataFrame的基础构建技巧。
本文介绍如何利用Python的Pandas库,从读取的Dataframe中筛选出满足特定条件的数据行。通过示例展示如何读取包含问号的数据,并过滤掉无效值,实现数据清洗与预处理。
本文介绍pandas 0.23.4版本中DataFrame的行列索引方法。详细解析loc、iloc及已弃用的ix三种方式,涵盖单行/多行、单列/多列及行列同时索引的用法。通过Series与DataFrame返回类型的对比,结合代码示例说明切片范围的闭开区间差异,帮助开发者准确掌握数据筛选技巧。
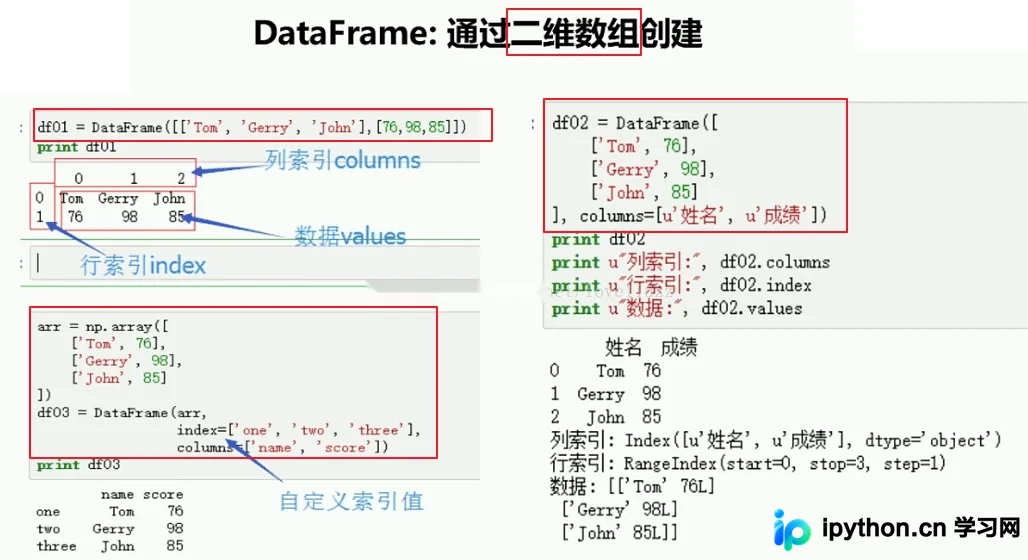
本文详细介绍Python3.5中Pandas模块DataFrame的用法。涵盖通过二维数组和字典创建DataFrame的方法,演示如何获取单列、单行数据,以及如何修改数据值。此外,还讲解了从CSV文件读取数据、更改列索引、筛选特定行列以及删除NaN值行的基本功能,适合Python初学者参考。
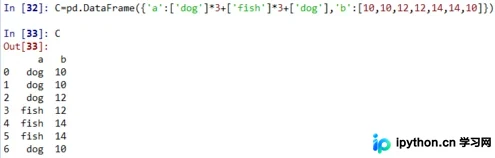
本文详解在pandas DataFrame中如何高效筛选和删除指定行。通过isin()方法传入列表或字典可实现精确匹配,同时介绍针对包含特定字符串行的处理技巧,帮助开发者快速完成数据清洗与过滤操作。
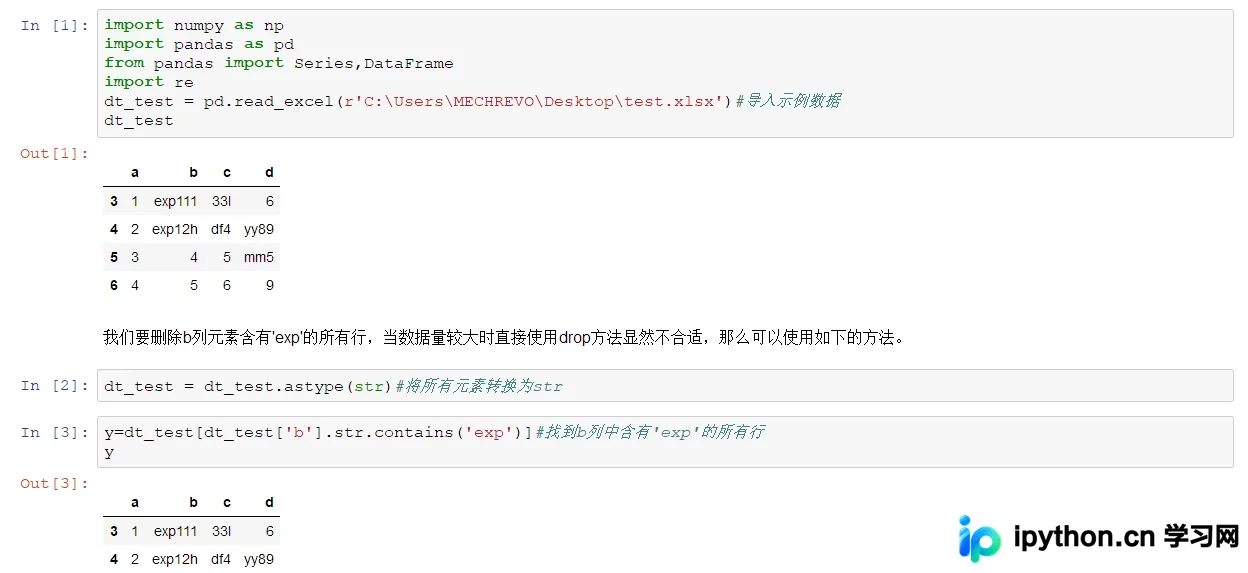
本文介绍在pandas中如何高效删除DataFrame中包含特定字符串的行。通过示例演示利用str.contains()结合逻辑取反或query()方法,快速筛选并剔除含有固定字符的数据行,适用于数据预处理与清洗场景。
本文详细介绍Python操作MySQL数据库的两种常用方式。首先通过pymysql模块建立连接,详解connect参数及游标操作,实现基础增删改查;其次利用pandas库的read_sql和to_sql函数,结合SQLAlchemy引擎,将数据直接读写为DataFrame格式,便于后续数据处理与分析。
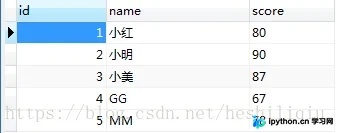
本文介绍如何在Python中利用texttable库为Pandas DataFrame格式化输出添加表格边框。通过设置列对齐方式(左、中、右)和数据类型(文本、整数等),并使用header=False参数避免首行被误识别为标题,从而实现美观的表格展示。
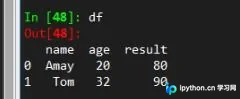
本文详细介绍如何在Pandas中通过提取的索引获取原始DataFrame的行数据。重点讲解将索引转换为列表后,利用iloc函数进行数据块提取的操作步骤。该方法适用于需要基于特定条件(如缺失值处理)筛选数据并进行后续替换或分析的场景,帮助开发者高效完成数据预处理任务。
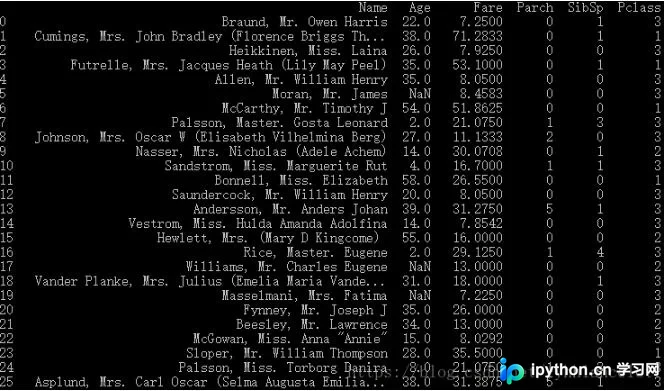
本文介绍如何在 Python 的 DataFrame 中计算差集,即删除指定列中与给定列表元素重复的行。通过 isin 方法生成布尔掩码并取反,实现高效筛选,最后重置索引输出结果。
本文介绍在 pandas 中处理重复数据的方法。通过示例展示如何创建 DataFrame,使用 duplicated() 检测重复项,并利用 drop_duplicates() 移除重复行。重点解析 subset 参数指定特定列,以及 keep 参数('first', 'last', False)控制保留策略,帮助开发者高效清理数据。