

Pandas中多列数据合并为一列的实现方法
在数据处理中常需将多个字段整合为单列。本文演示利用Pandas结合NumPy进行条件标记,并通过字符串转换与加号运算符实现多列值合并为新列的具体流程,涵盖数据准备、核心操作与结果核对步骤,适用于日常清洗与报表输出。
2026-10-12
6

在数据处理中常需将多个字段整合为单列。本文演示利用Pandas结合NumPy进行条件标记,并通过字符串转换与加号运算符实现多列值合并为新列的具体流程,涵盖数据准备、核心操作与结果核对步骤,适用于日常清洗与报表输出。
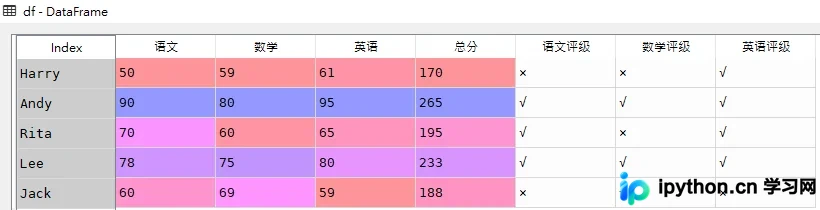
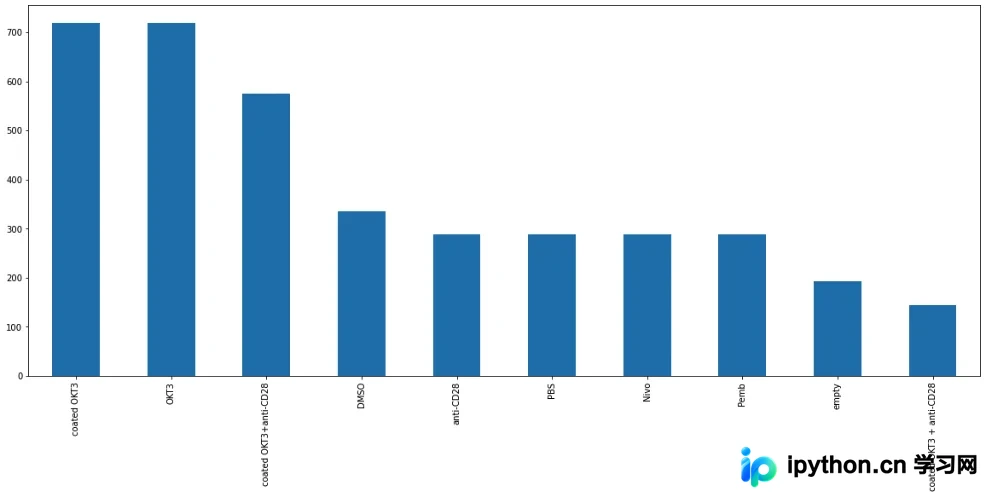
本文详细介绍使用Python Pandas处理CSV文件的标准工作流。针对中文编码导致的读取报错提供解决方案,演示如何利用value_counts统计频次、loc进行精确筛选、iterrows逐行遍历,并结合Matplotlib完成柱状图与直方图绘制,助力快速实现结构化数据的清洗与可视化分析。
本文深入解析 pandas DataFrame 赋值时的 Index 对齐机制,解释为何 Index 不匹配会导致 NaN。通过对比三种 Index 场景,阐明 df[condition] 赋值的潜在风险,并给出使用 loc 和 iloc 进行安全、规范赋值的最佳实践。
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作方法。涵盖基础属性获取(如 index、shape)、数据访问(loc、iloc)、多行多列切片、条件筛选、列的新增与删除,以及数据修改。通过具体代码示例,帮助开发者快速掌握 DataFrame 的高效数据处理技巧。
本文详解pandas中df.dropna()函数的使用,涵盖Series和DataFrame的缺失值删除。重点解析axis、how、thresh、subset和inplace等关键参数,通过具体代码示例展示如何灵活处理不同场景下的NaN数据,帮助开发者高效清理数据。
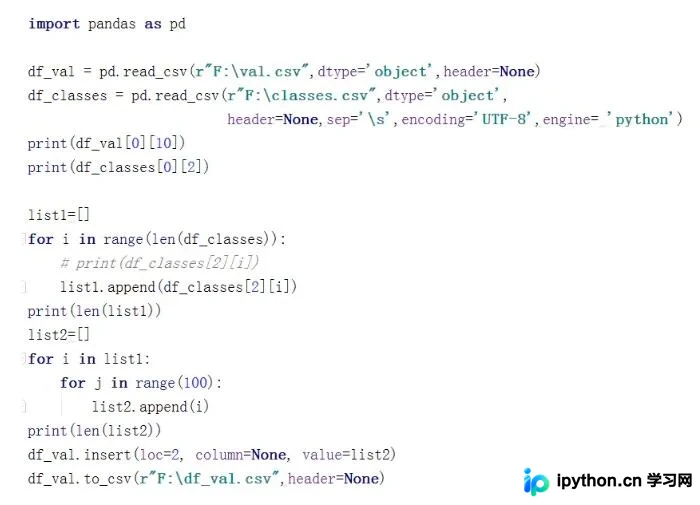
本文介绍在 pandas 中为 DataFrame 添加空列并赋空值的方法。通过 apply 函数或直接赋值实现,并解决多文件标签映射时的列扩展问题。
本文介绍在pandas中统计DataFrame重复值次数的两种核心方法。通过duplicated()标记重复行,结合布尔索引筛选并统计数量;或利用drop_duplicates()计算去重前后的行数差值。文章包含完整的代码示例与结果解析,帮助快速处理数据清洗中的重复项问题。
本文介绍在Pandas中将单列数据按分隔符拆分为多列的多种方法。通过str.split()结合expand参数、索引提取或解包赋值,可高效完成数据清洗。同时涵盖处理列表数据及生成测试数据的技巧,帮助开发者快速实现列拆分操作。
本文介绍如何使用 Pandas 库对 DataFrame 进行按行计算百分比(比例)的操作。通过结合 `sum()` 与 `div()` 方法,并正确指定 `axis` 参数,可以快速实现数据在行维度上的归一化处理,适用于不同月份或类别数据的比例分析。
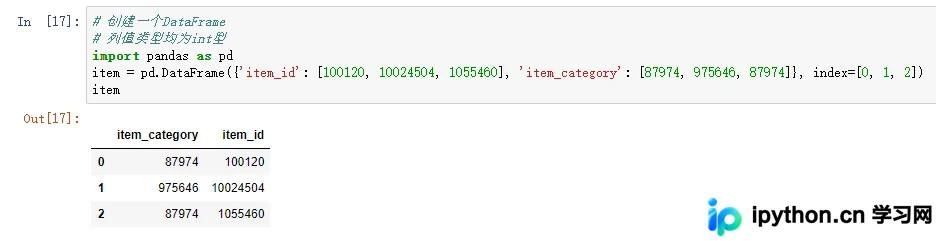
本文详细解析了如何将Python Pandas中的DataFrame转换为字典。通过处理商品ID与类别的一对多映射关系,演示了数据类型转换(int转str)以及利用set_index和to_dict方法实现高效映射的具体步骤。
在Python数据分析中,快速定位包含空值(NaN)的行是数据清洗的关键步骤。本文介绍利用pandas库的.isnull()结合.any()方法,通过转置操作高效筛选出含有缺失值的DataFrame行,并附带完整的代码示例与结果解析。
本文介绍在pandas中修改DataFrame列名的5种方法,包括直接赋值、map函数、rename函数、字典法和映射法。通过具体代码示例,展示如何高效修改列名,适用于数据清洗和预处理场景。