

Python使用Pandas拆分大型CSV文件的完整代码与逻辑解析
本文提供使用Python和Pandas库拆分大型CSV文件的完整代码示例。通过设置chunksize参数进行分块读取,根据指定行数动态计算输出文件数量,并自动处理有表头和无表头两种情况。代码演示了如何遍历数据块并逐一保存为独立CSV文件,适用于处理超出内存限制的大规模数据集。
2026-10-13
6

本文提供使用Python和Pandas库拆分大型CSV文件的完整代码示例。通过设置chunksize参数进行分块读取,根据指定行数动态计算输出文件数量,并自动处理有表头和无表头两种情况。代码演示了如何遍历数据块并逐一保存为独立CSV文件,适用于处理超出内存限制的大规模数据集。
本文详解Python Pandas中处理Excel数据缺失值的两种核心方法:dropna用于删除全空行或列,fillna用于填充特定值或前向/后向填充。通过读取含空行的Excel文件,演示如何忽略前导空行、检测空值、删除无效数据列及行,并将分数列空值填为0,姓名列使用前向填充。最终保存清洗后的数据,提供从读取到保存的完整清洗流程。
本文介绍在Python中将DataFrame字符串列转换为日期类型的两种常用方法。首先讲解使用pd.to_datetime函数的简洁实现,其次深入解析利用datetime模块中strptime和strftime函数进行格式匹配转换的技巧。重点强调格式字符串必须与原数据完全一致,否则会导致转换失败。
本文详解如何使用 Python3 的 pandas 库读取、修改并保存 Excel 文件。通过实例演示了安装依赖、读取指定 Sheet、新增列(处理 Series 长度一致性)、以及调用 to_excel 方法保存结果的关键步骤,帮助开发者快速掌握基础数据操作。
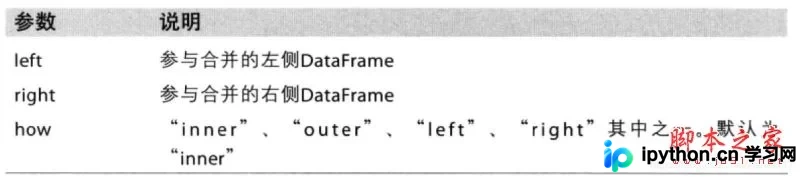
本文深入解析Python3中pandas库的merge函数,详细讲解其核心参数如on、how、left_on、right_on及suffixes的用法。通过对比内连接、外连接、左连接和右连接的区别,并演示如何利用索引进行合并,帮助开发者高效完成数据清洗与重塑任务。
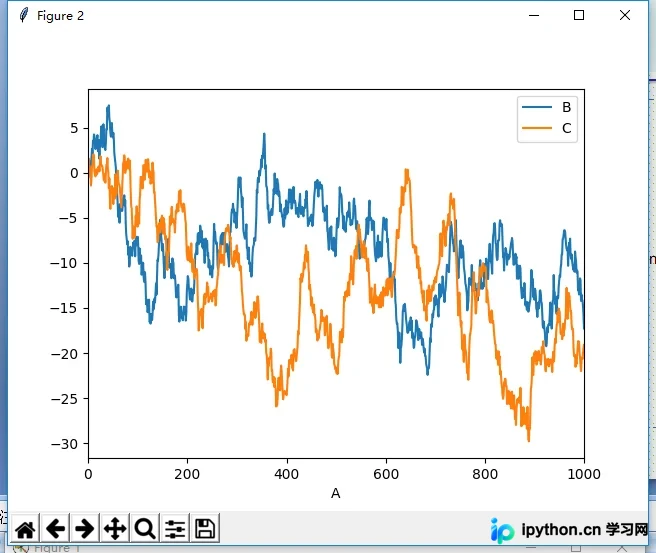
本文详细介绍Python数据分析库pandas的核心用法。涵盖Series、DataFrame和Panel三种数据结构,演示如何生成一维与二维数组、查看索引与统计信息、执行数据转置与排序、进行数据选择与修改,以及处理缺失值和结合matplotlib绘图。通过具体代码示例,帮助开发者快速掌握pandas在数据清洗与分析中的实际应用。
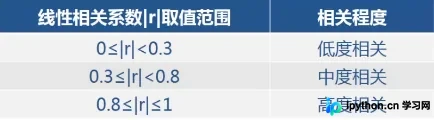
本文介绍Python中利用Pandas库进行相关分析的方法。重点讲解DataFrame.corr()与Series.corr()函数的区别与返回值类型,阐述皮尔逊相关系数r在衡量变量线性关系中的应用,包括正负相关判定及r=0的含义。
本文详细介绍如何使用Python的pandas库合并Excel文件中的多个工作表。通过读取指定文件夹下的Excel文件,分别提取不同工作表的数据,并对特殊工作表进行索引截取处理,最终将结果保存为新的Excel文件。
本文提供一段Python代码,用于批量将Excel文件中的多个Sheet页转换为CSV格式。通过xlrd和pandas库,自动处理包含空格字段的复杂表格,并按指定规则清洗数据。该脚本适用于需要高效处理大量Excel数据的场景,避免手工转换的低效与错误。
本文介绍Python中三种将数据写入CSV或Excel文件的方法:使用csv模块处理CSV文件,利用openpyxl模块操作xlsx格式,以及通过pandas库同时支持两种格式。其中pandas方法代码最简洁,适合快速实现数据持久化需求。
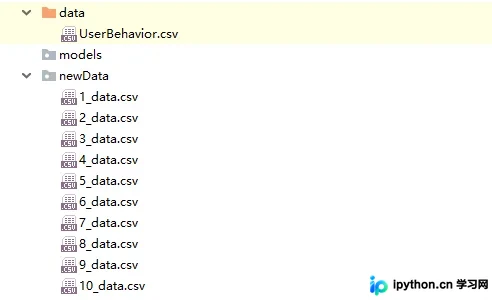
本文介绍如何使用Python的Pandas库将包含亿级数据的CSV文件等分为10份,并采用规则命名。针对文件路径含中文导致内存占用翻倍的问题,提供了通过文件对象读取的替代方案,同时建议优先修改路径为英文以优化性能。
本文详解 pandas 中 to_datetime 函数的使用,重点解决 DataFrame 中混合时间格式导致的转换报错。通过实战案例,展示如何识别 object 类型日期列,利用 errors='coerce' 和 infer_datetime_format 参数处理包含 ISO8601 等不一致格式的数据,并提供筛选异常行与批量转换的高效技巧。