

NumPy中np.nonzero()函数用法详解:获取非零元素索引
本文详细解析NumPy库中np.nonzero()函数的核心用法。该函数用于返回数组中非零元素的索引位置。文章通过一维、二维及三维数组的具体代码示例,展示了返回值作为包含多个一维数组的元组的结构特征,并说明了如何利用np.transpose()将索引重组为坐标形式,帮助开发者高效处理数组筛选与定位任务。
2026-10-13
6

本文详细解析NumPy库中np.nonzero()函数的核心用法。该函数用于返回数组中非零元素的索引位置。文章通过一维、二维及三维数组的具体代码示例,展示了返回值作为包含多个一维数组的元组的结构特征,并说明了如何利用np.transpose()将索引重组为坐标形式,帮助开发者高效处理数组筛选与定位任务。
本文介绍Softmax回归函数在Python中的两种实现方式。Softmax通过指数变换对分类得分进行归一化,使较大值的贡献更显著。第一种方法通过手动循环计算实现,第二种利用NumPy库进行向量化操作,代码更简洁高效。
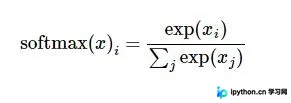
本文深入解析Python中二分查找算法的原理与实现,对比递归与循环方式的性能差异。重点介绍bisect模块如何高效维护有序列表,并详细对比其与numpy.searchsorted在普通列表与大型数组场景下的执行效率,为开发者提供实用的性能优化建议。
本文深入解析NumPy数组的高级操作,涵盖自定义结构体数组的定义与数据类型映射,详细演示hstack、vstack、dstack等组合函数的用法及axis参数控制。同时对比hsplit、vsplit等分割方法,并重点剖析完全复制、视图(View)与深复制在内存共享与数据修改上的本质区别,帮助开发者避免常见的内存陷阱。
本文深入解析NumPy核心对象ndarray,详解其维度、形状、大小及数据类型等关键属性。通过array、zeros、arange等函数演示多种数组创建方式,并介绍NumPy特有的数据类型转换与输出显示控制,帮助开发者掌握高效的数据处理基础。
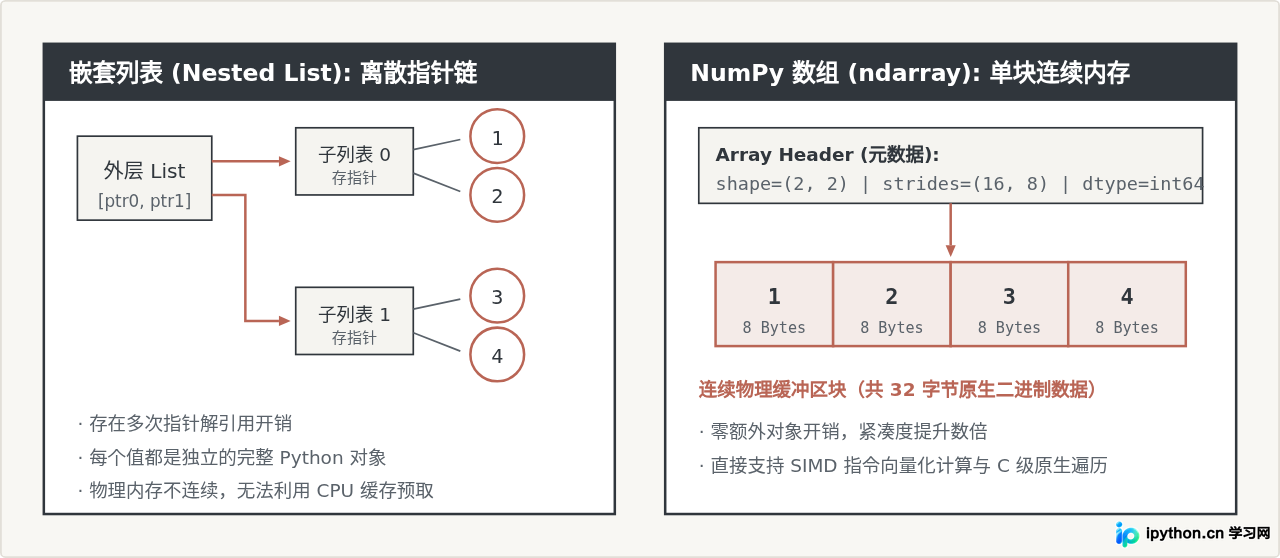
深入解析Python嵌套列表与NumPy ndarray在底层内存布局、索引语法、数学运算机制及适用边界上的核心区别,帮助开发者根据实际场景合理选择数据结构。
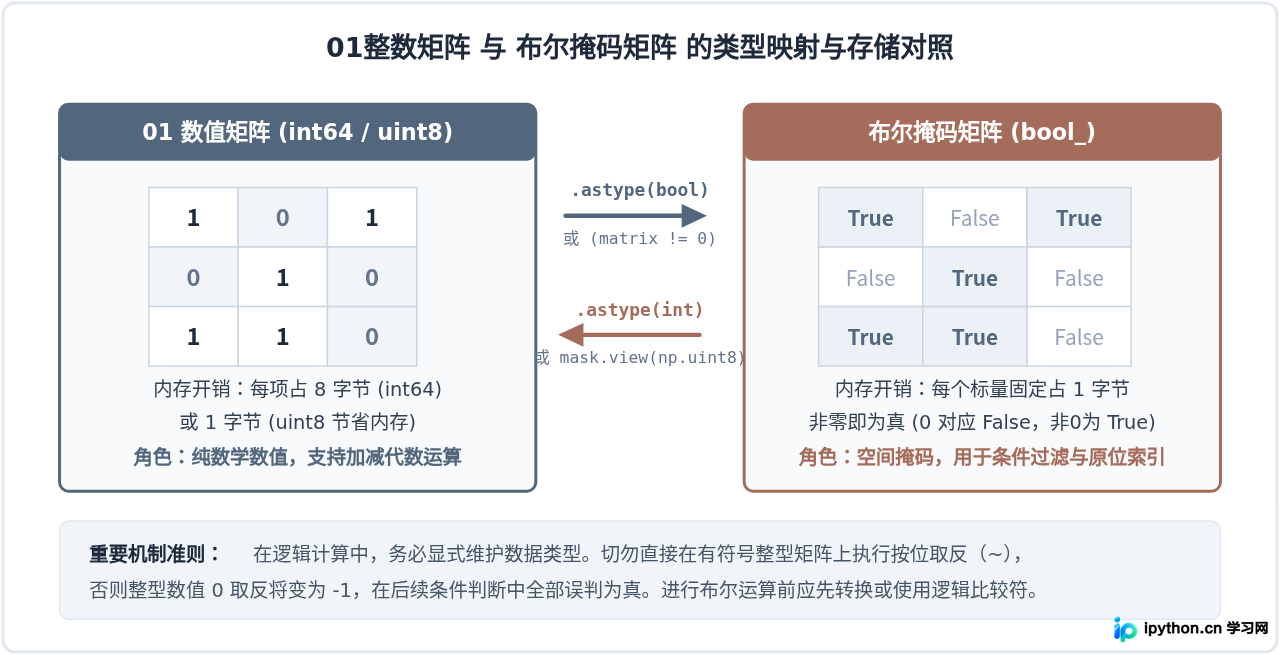
深入解析Python与NumPy中01矩阵的底层存储机制、向量化位逻辑运算、布尔掩码筛选的维度折叠原理、原位赋值及常见整型取反陷阱,提供系统实战技巧与速查指南。
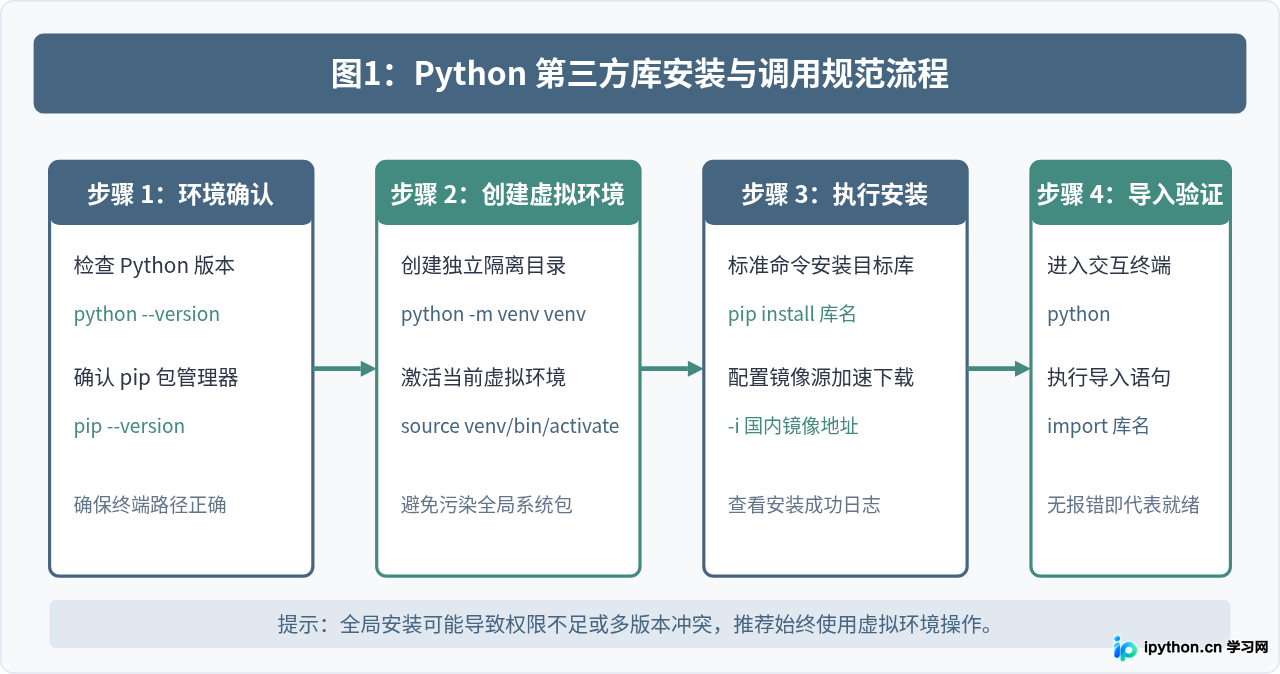
本文为Python初学者系统介绍十个最常用且实用的第三方库,涵盖网络请求、数据分析、数值计算、可视化、办公自动化、图像处理及开发调试,提供明确安装指南与代码示例。
本文系统梳理在Python中从列表随机抽取五个元素的四种标准实现路径。通过解析 random.sample()、random.choices()、numpy.random.choice() 以及 shuffle() 组合切片的底层行为、去重机制与内存占用差异,指导开发者依据抽样规则、原数据保真度要求及运行环境进行精准选型,并附带长度校验与动态范围生成的生产级示例。
在 Python 项目中安装第三方库时,自动解析的 NumPy 旧版本常引发运行时报错。通过 pip 显式指定兼容的版本号并配合环境清理,可有效避免依赖冲突导致的 Windows 运行时异常或模块导入失败,确保项目稳定运行。
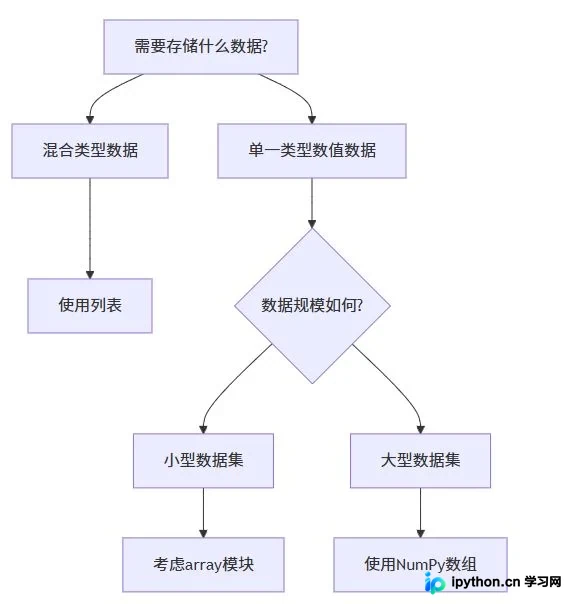
聚焦Python开发中异构数据管理与大规模数值计算场景,对比内置列表与NumPy数组的核心差异。通过内存分配机制、运算性能实测与类型参数说明选型逻辑,提供混合使用策略、视图切片与内存映射等进阶技巧,帮助开发者在灵活性与执行效率间做出最优决策。
本文系统梳理提升Python执行效率的八种核心方法,涵盖利用内置函数、NumPy向量化操作、Numba JIT编译、多进程绕过GIL限制、Cython扩展、高效数据结构选择、函数缓存及作用域优化。通过针对性替换低效代码并配合性能分析工具定位瓶颈,可在数据密集型与循环计算场景中实现数倍至数百倍的运行速度提升。