Python NumPy教程之遍历数组详解
本文详细介绍Python NumPy中高效的多维数组遍历方法。通过numpy.nditer对象,开发者可以控制迭代顺序(C/Fortran风格)、修改数组值以及处理广播数组。文章涵盖基础遍历、顺序控制、值修改、外部循环及索引跟踪等核心功能,帮助深入理解NumPy数组操作。
2026-10-16
7

本文详细介绍Python NumPy中高效的多维数组遍历方法。通过numpy.nditer对象,开发者可以控制迭代顺序(C/Fortran风格)、修改数组值以及处理广播数组。文章涵盖基础遍历、顺序控制、值修改、外部循环及索引跟踪等核心功能,帮助深入理解NumPy数组操作。
本文深入解析Python NumPy中每个ndarray关联的数据类型对象(dtype)。详细阐述如何使用numpy.dtype类构造dtype对象,解析obj、align和copy等关键参数,并对比type与dtype的区别。此外,通过代码示例演示如何利用结构化dtype创建包含不同字段类型的数组,涵盖字节序、大小及子数组形状等核心概念。
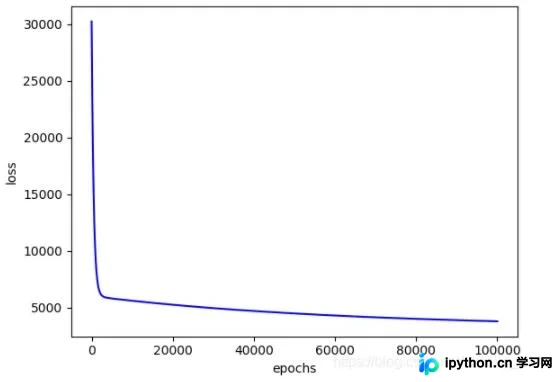
本文通过Python和NumPy库从零实现线性回归模型,封装为类结构。利用sklearn的糖尿病数据集进行训练与测试,涵盖数据预处理、参数初始化、损失计算及交叉验证等核心步骤,并提供完整代码与可视化结果供参考。
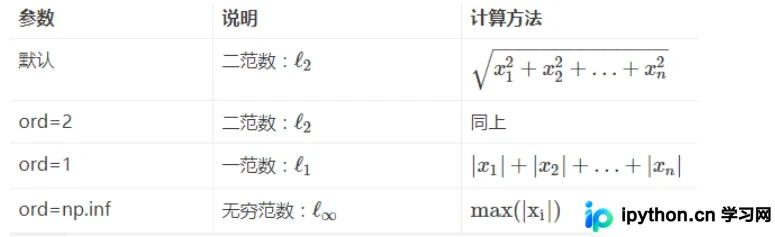
本文详细介绍Python中numpy库的np.linalg.norm()函数,涵盖其求范数的核心功能。文章解析了x、ord、axis和keepdims四个关键参数的含义,并通过具体代码示例演示了默认状态、改变axis、ord及keepdims时的计算结果,帮助开发者掌握向量与矩阵范数的计算方法。
本文详细解析numpy中reshape(-1,1)与reshape(1,-1)的具体用法。通过多个代码示例,说明当指定新数组shape为-1时,Numpy如何根据剩余维度自动计算。重点区分单特征数据使用reshape(-1,1)转为列向量,以及单样本数据使用reshape(1,-1)转为行向量的场景,帮助开发者准确处理数据维度。
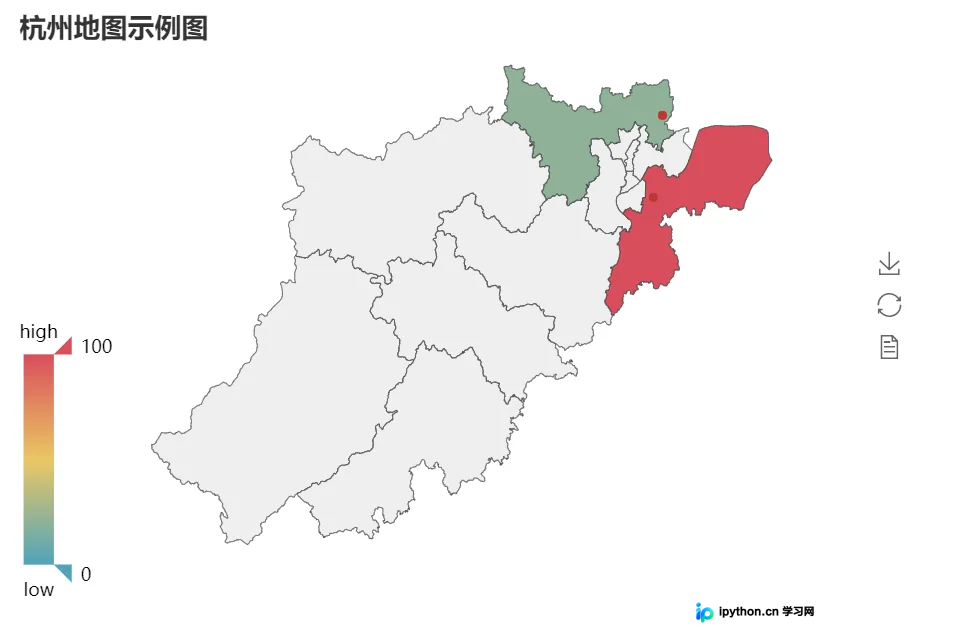
本文介绍如何利用pyecharts在Python中绘制中国及杭州地图,涵盖环境配置、包安装及核心API用法。重点解析因pandas处理导致数据变为numpy.int64从而引发图表不显示的常见错误,并提供转换为标准int类型的解决方案。
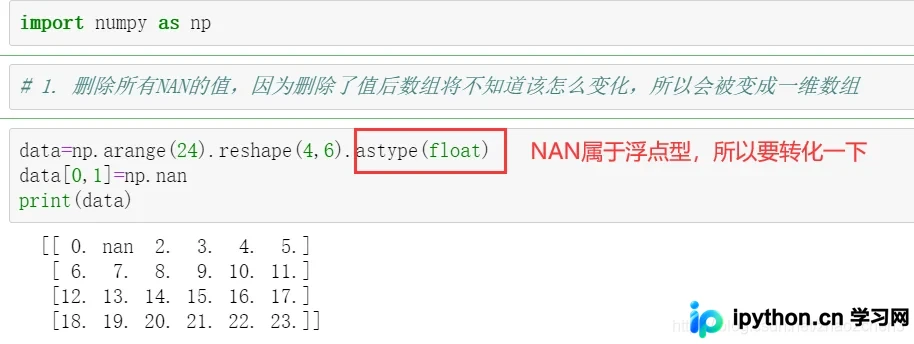
本文详解Python中NAN(非数字)与INF(无穷大)的定义及特性,重点讲解数据分析中缺失值的两种处理策略:直接删除与使用特定值(如0或均值)进行填充,并提供基于NumPy的代码示例与注意事项。
本文深入解析Python中np.random.seed()的作用机制,解释其作为伪随机数生成器初值的原理。通过代码示例对比不同种子值对结果的影响,指出参数选取的任意性,并强调每次使用前需重新调用seed()以确保结果可复现,避免常见的使用误区。
本文深入解析Python生态中十大核心库,涵盖数据处理、机器学习与可视化领域。从Pandas的数据清洗到NumPy的高效数组计算,再到Scikit-learn的建模与TensorFlow、Keras的深度神经网络实现,最后介绍Gradio、SciPy、Statsmodels、Plotly及Seaborn在模型部署、科学计算与动态可视化中的关键作用,助您构建完整的AI工作流。
本文详细介绍 Python NumPy 库中数组的索引与切片技术。内容涵盖基础的一维及多维数组切片、整数数组索引、布尔索引以及花式索引的具体实现与差异,通过代码示例展示如何高效提取和处理数据,帮助开发者掌握 NumPy 核心数据处理技能。

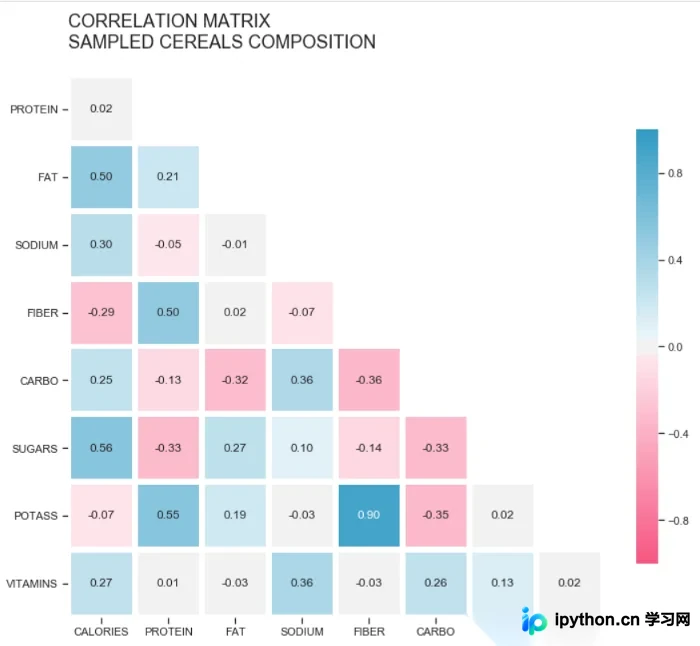
本文详细介绍如何使用Python的Seaborn库绘制高质量热力图。内容涵盖从导入Pandas和Numpy进行数据预处理开始,通过corr()计算相关性矩阵,利用Mask矩阵去除冗余上三角区域,以及调整参数显示具体数值。此外,还深入讲解了如何使用diverging_palette优化发散型调色板,提升视觉表现力,最终生成带有标题和格式优化的专业级相关性热力图。
本文介绍Python数据分析的核心工具链。首先讲解Jupyter Notebook的基本操作与帮助获取方法;随后深入NumPy数组的创建、索引及形状变换;接着详解SciPy稀疏矩阵(CSR/LIL)在机器学习中的高效存储与格式转换;最后演示Matplotlib在Jupyter中的内联绘图及多种图表类型,为机器学习预处理提供基础支持。