

Python NumPy随机数模块np.random常用函数详解
本文详细介绍Python NumPy库中np.random模块的常用函数,包括生成均匀分布、标准正态分布、整数随机数及自定义概率选择的多种方法。通过具体代码示例,解析rand、randn、randint、uniform、normal、random和choice等函数的参数用法与输出结果,帮助开发者在人工智能与数据处理中高效使用随机数生成工具。
2026-10-15
5

本文详细介绍Python NumPy库中np.random模块的常用函数,包括生成均匀分布、标准正态分布、整数随机数及自定义概率选择的多种方法。通过具体代码示例,解析rand、randn、randint、uniform、normal、random和choice等函数的参数用法与输出结果,帮助开发者在人工智能与数据处理中高效使用随机数生成工具。
本文深入解析Python中np.random.seed()的作用机制,解释其作为伪随机数生成器初值的原理。通过代码示例对比不同种子值对结果的影响,指出参数选取的任意性,并强调每次使用前需重新调用seed()以确保结果可复现,避免常见的使用误区。
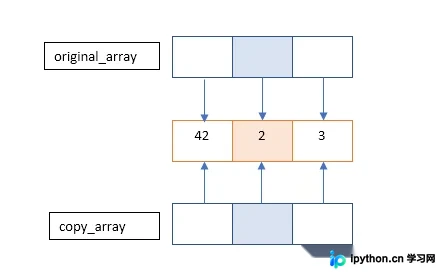
本文详细解析Python NumPy库中数组赋值的浅拷贝机制与使用copy()方法实现的深拷贝原理。通过对比内存地址指向,展示修改数组元素时两种操作对原始数据的不同影响,并提供判断内存共享的is运算符技巧,帮助开发者避免数据意外修改。
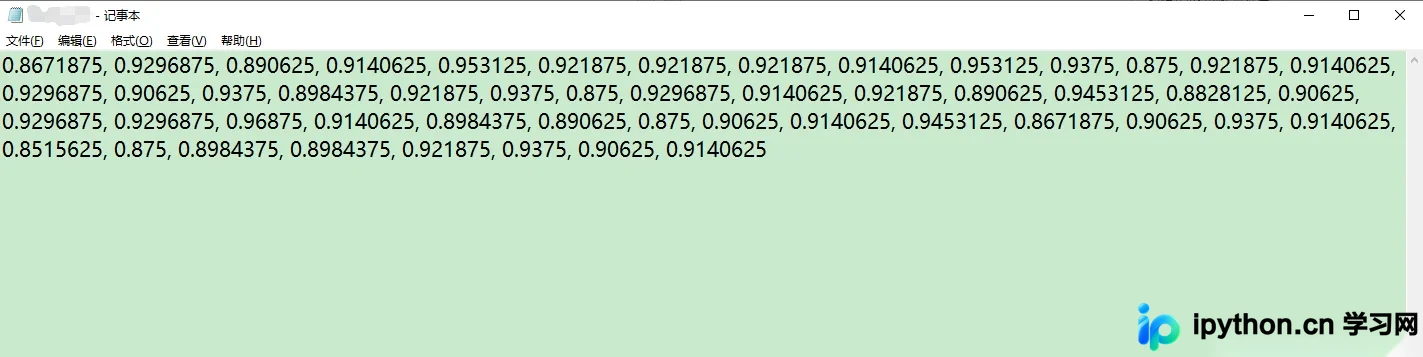
本文介绍如何使用Python的numpy库读取和查看npz及npy格式的文件数据。重点讲解当输出包含省略号时,如何通过设置np.set_printoptions(threshold=np.inf)来完整显示数组内容,并对比了npz与npy文件的处理差异,最后提供了保存为文本文件的示例代码。

本文详细解析在Python调用C++生成的DLL时,如何处理OpenCV图像数据类型的转换。重点讲解Python中Numpy Array与C++中cv::Mat通过unsigned char指针进行交互的方法,包括数据传递、内存拷贝及返回值处理的具体代码实现。
本文详解OpenCV中图像堆叠的三种实现方式。首先介绍使用numpy的hstack和vstack进行水平与垂直简单拼接;随后深入解析自定义stackImages函数,支持不同尺寸、通道数(如彩色与灰度混合)及任意行列矩阵的灵活堆叠,并提供完整代码与缩放比例参数说明。
本文详细解析 NumPy 中 axis 参数的核心机制,解释其如何在多维数组中指定运算方向。通过 sum、mean、min、max、sort 及 prod 等函数的具体示例,阐述 axis=0 与 axis=1 在二维及高维数组中的行为差异,帮助开发者准确掌握数据处理的维度控制。
本文通过实测对比Python中Numpy二维数组的两种遍历方式:双层循环与切片后一维遍历,并引入Numba JIT加速。结果显示,切片遍历通常更快,但Numba首次调用存在编译开销。文章详细解析了不同数据规模下的耗时差异及底层内存引用机制,为高性能计算提供实践参考。
本文详细介绍在Python中读取TXT数据的三种主流方法。首先演示使用内置open函数进行基础读取与列表转换;其次讲解利用NumPy的loadtxt方法处理纯数值型实验数据,强调其返回ndarray类型的特性;最后介绍通过Pandas的read_table方法处理更复杂的文本格式,返回DataFrame对象。内容涵盖环境配置、代码示例及结果分析,适用于不同场景下的数据读取需求。
本文详细解析Numpy中各种下标操作,涵盖二维矩阵的单行与元素提取、List与Tuple索引机制的区别、冒号切片的高级用法、None扩维技巧以及高维张量的索引策略。重点阐明List与Tuple在语义上的差异及历史遗留问题,帮助开发者避免常见陷阱并掌握高效的数据访问方法。
本文深入解析Python大数据处理中Numpy Array的核心优势。通过对比原生List,详细阐述Numpy在内存占用(降低20倍)和运算速度(提升近2倍)方面的显著性能,并结合C语言底层实现与内置代数运算优势,说明其在金融等大数据场景下的必要性。
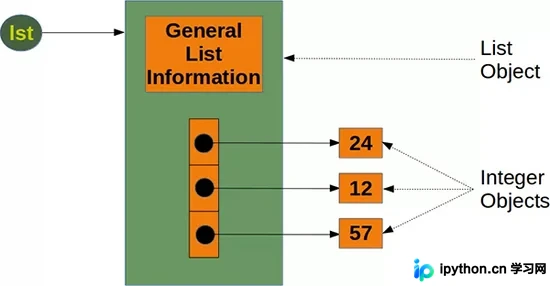
本文详细介绍Python NumPy库中ndarray数组基于索引的增删改查操作。通过np.insert()实现指定位置插入,np.append()在末尾添加,np.delete()执行删除,直接索引赋值修改及切片查找。文章包含完整代码示例与运行结果解析,帮助开发者高效掌握数组元素管理技巧。