

Python数据挖掘核心技能:从数据处理到模型实战
本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
2026-10-13
6

本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
本文详细介绍Python中NumPy库的通用函数在数组计算中的应用。内容涵盖数组的基础算术运算(加减乘除)、绝对值的三种实现方式、三角函数(sin/cos/tan)计算,以及指数和对数运算。通过具体代码示例,帮助开发者掌握NumPy高效处理数值数据的核心方法。
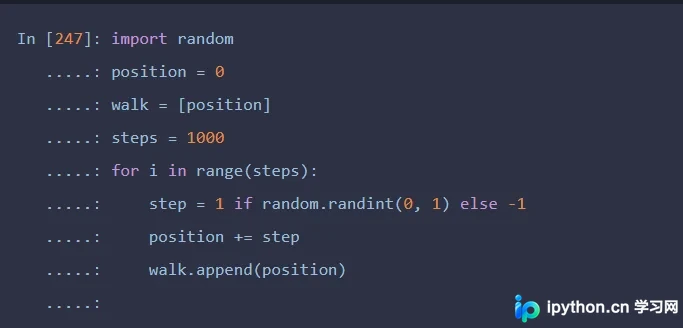
本文介绍如何利用Python和NumPy模块模拟随机漫步过程。通过生成随机步长并计算累计和,展示数组运算的高效性。同时深入解析如何结合布尔数组与argmax函数,统计首次达到特定距离阈值所需的步数,为理解随机过程及数据分析提供实用代码示例。
本文介绍在Python中使用set对二维数组进行去重并转换为一维数组的方法。由于set无法直接处理嵌套列表,直接调用matrix.tolist()会产生二维列表导致报错。通过结合使用.A.flatten()方法将矩阵展平为一维后再转换为列表,即可成功传入set进行去重操作。
本文详解Python内置random模块及numpy库的随机数生成方法。涵盖random.random、randint、choice等基础函数,以及numpy的rand、randn、randint多维数组生成。重点解析seed种子机制对伪随机数可复现性的控制,适用于密码加盐、蒙特卡洛算法等场景。
本文详细解析NumPy中ndarray对象的核心属性(如shape, dtype, T)及常用方法。内容涵盖数组维度变换、元素筛选、统计计算(均值、方差、累积和)、复数处理及数组重复与切片操作,帮助开发者高效掌握NumPy数组编程技巧。
本文深入解析numpy库中argmax函数的具体使用方法。通过一维、二维及三维数组的实例,详细讲解如何利用axis参数在不同维度上查找最大值的索引位置,帮助开发者准确掌握该函数的核心逻辑与应用场景。
本文系统梳理numpy.random模块的核心函数,涵盖uniform、rand、randint等基础随机数生成方法,详解choice抽取、permutation与shuffle序列操作,以及seed随机种子设置。通过具体代码示例展示各函数的参数用法、取值范围及数组维度处理,帮助开发者高效掌握NumPy随机数生成技巧。
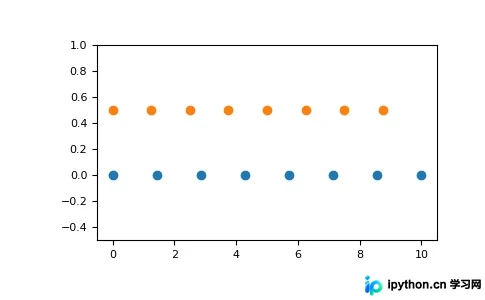
本文详细解析Python中numpy库的linspace函数,涵盖start、stop、num、endpoint等核心参数的具体用法。通过对比arange与logspace,结合代码示例演示如何生成均匀分布的数值序列,并深入讲解endpoint=False及retstep=True时的特殊行为,帮助开发者高效进行数据预处理与科学计算。
本文详细介绍numpy库中flatten()函数的使用方法。该函数用于将多维数组折叠为一维,支持order参数控制存储顺序。文章通过array、mat对象示例展示其应用,并指出其不适用于普通list,提供了使用列表推导式实现同等效果的替代方案。
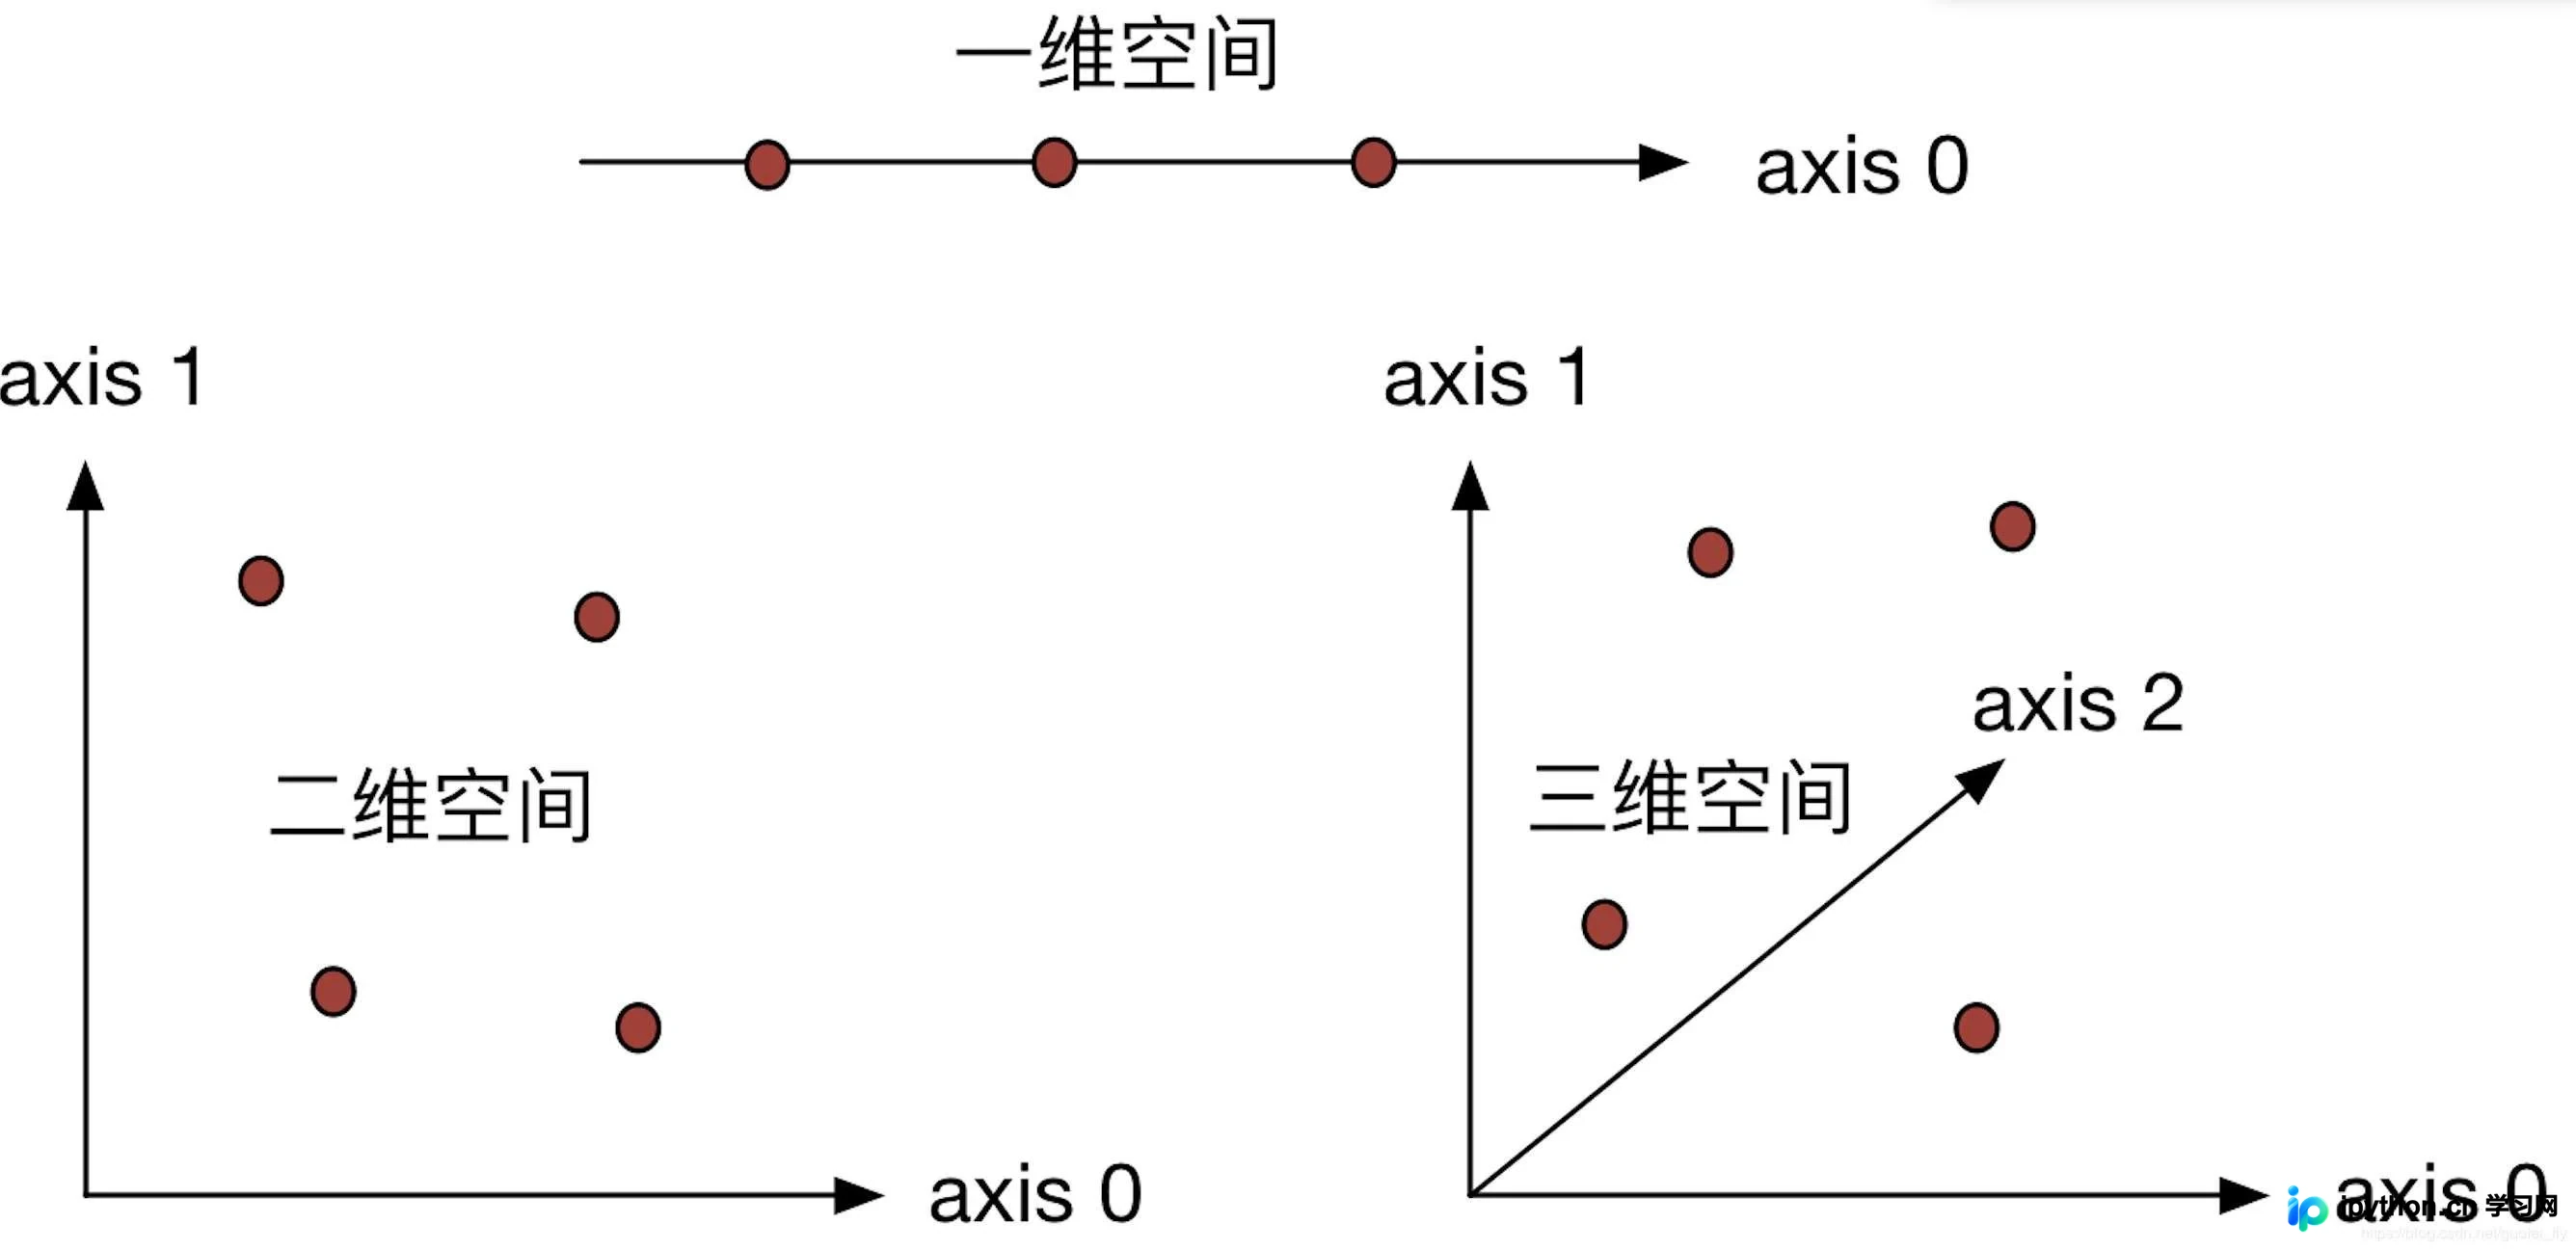
本文详细解析Numpy中数组拼接与合并的核心函数,包括concatenate、append、stack系列及hstack、vstack、r_、c_等。通过对比维度、轴概念及各函数的参数行为,结合具体代码示例,阐明如何在不同场景下高效实现数组的行/列拼接与维度扩展,帮助开发者选择最合适的合并策略。
本文详细介绍NumPy中数组拼接的三种常见方法:列表转换法、append函数及concatenate函数。重点对比了append与concatenate在大规模数据拼接时的运行效率,指出concatenate因避免重复内存分配而具有更高性能,适合处理大量数据。