Python高效计算词频:从自定义函数到NLTK的优化实践
本文对比了Python中两种计算词频的方法。首先分析了通过自定义cut_word和union_dict函数结合Pandas apply与reduce进行字典合并的传统实现,指出其代码冗余问题。随后引入NLTK库的FreqDist方法,展示如何利用jieba分词后直接生成频率字典。通过去重拼接字符串的技巧,实现了更简洁高效的词频统计方案,适用于各类文本处理场景。
2026-10-13
40

本文对比了Python中两种计算词频的方法。首先分析了通过自定义cut_word和union_dict函数结合Pandas apply与reduce进行字典合并的传统实现,指出其代码冗余问题。随后引入NLTK库的FreqDist方法,展示如何利用jieba分词后直接生成频率字典。通过去重拼接字符串的技巧,实现了更简洁高效的词频统计方案,适用于各类文本处理场景。
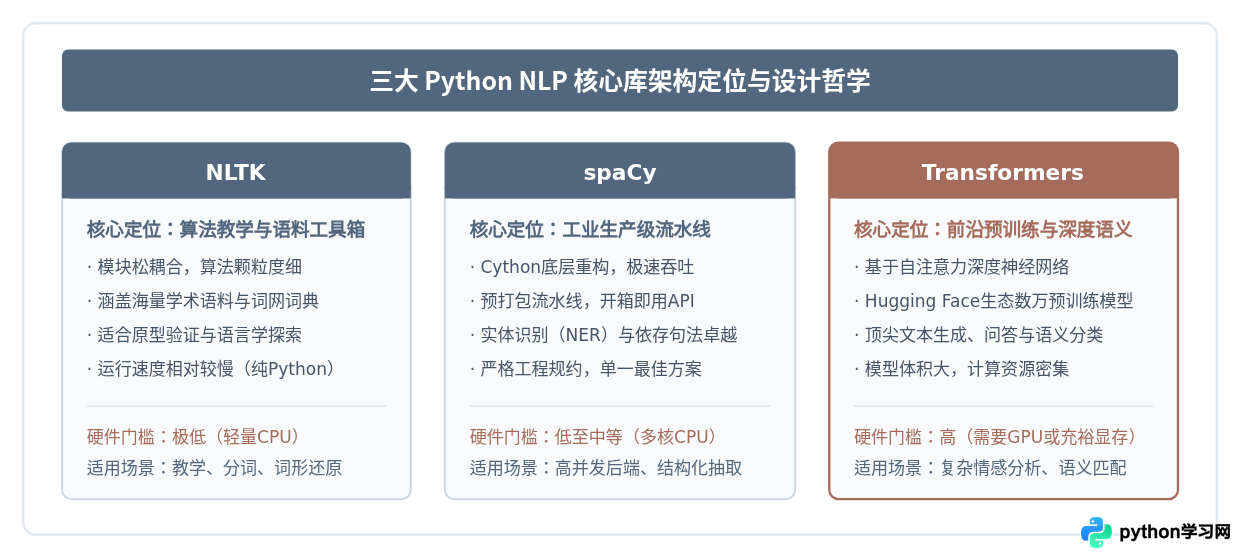
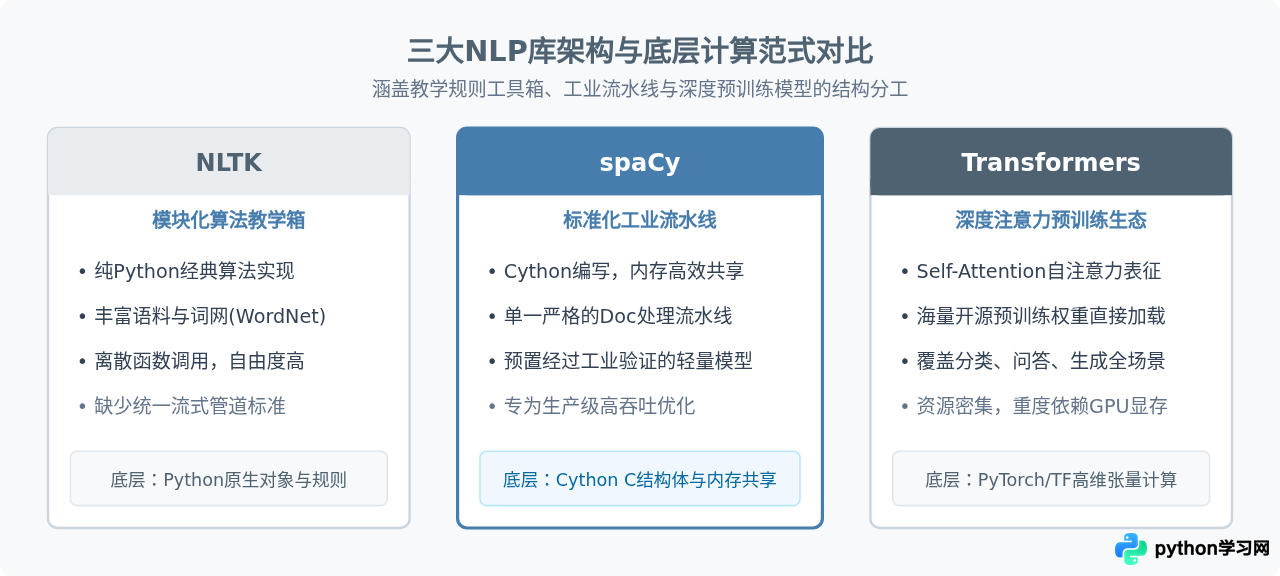
深度对比Python NLP主流工具NLTK、spaCy与Transformers的架构设计、运行效率、硬件需求与适用边界,提供完整的选型决策树与工程落地指导。
本文介绍Python中从HTML提取纯文本的三种常用方法:使用正则表达式移除标签、调用NLTK库的clean_html函数以及自定义HTMLParser解析器。文章对比了各方案的代码实现、依赖要求及适用场景,帮助开发者根据项目需求选择最高效的文本提取方案。
本文详解Python中NLTK库的基础应用,涵盖环境配置、分句与分词操作。重点解析WordPunctTokenizer与regexp_tokenize的使用,并针对NLTK 3.1+版本中compile_regexp_to_noncapturing废弃导致的兼容性问题,提供修正后的正则分词代码方案,帮助开发者高效进行文本预处理。
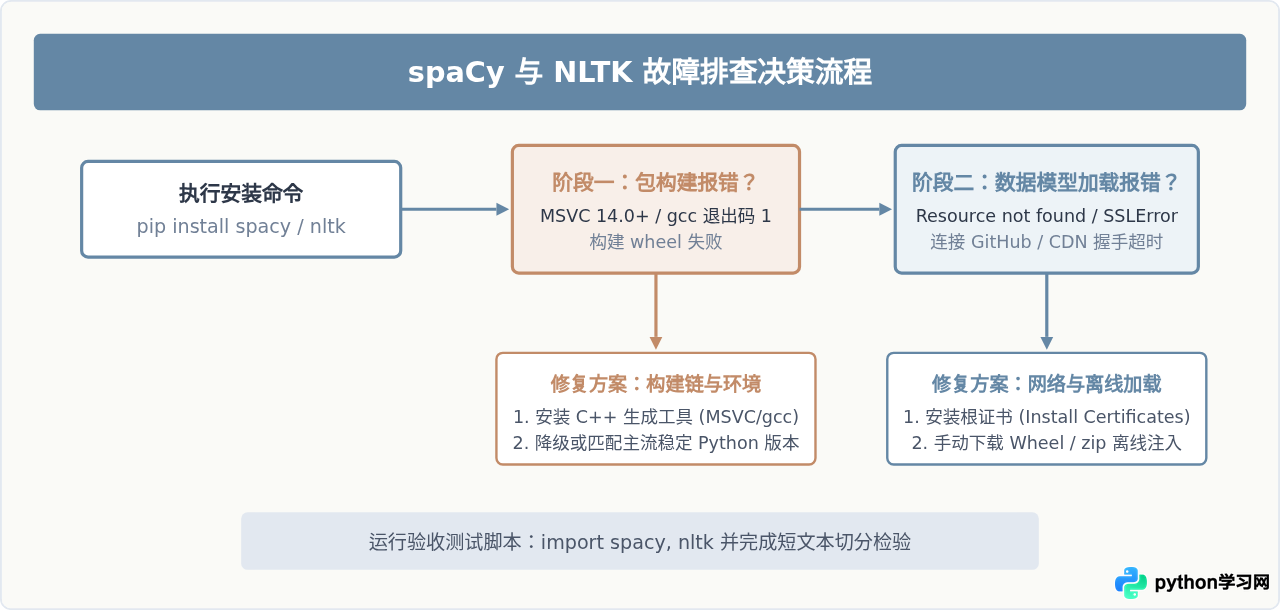
系统梳理Python自然语言处理库spaCy和NLTK在安装与资源配置过程中的高频报错,针对C/C++编译链缺失、Wheel匹配失败、SSL证书校验及语料模型拉取超时等问题提供详实修复方案与验证流程。
面向Python自然语言处理初学者,全面对比NLTK、spaCy与Transformers三大核心库的架构定位、处理流程、性能差异与应用场景,提供清晰实用的选型指南与工程建议。
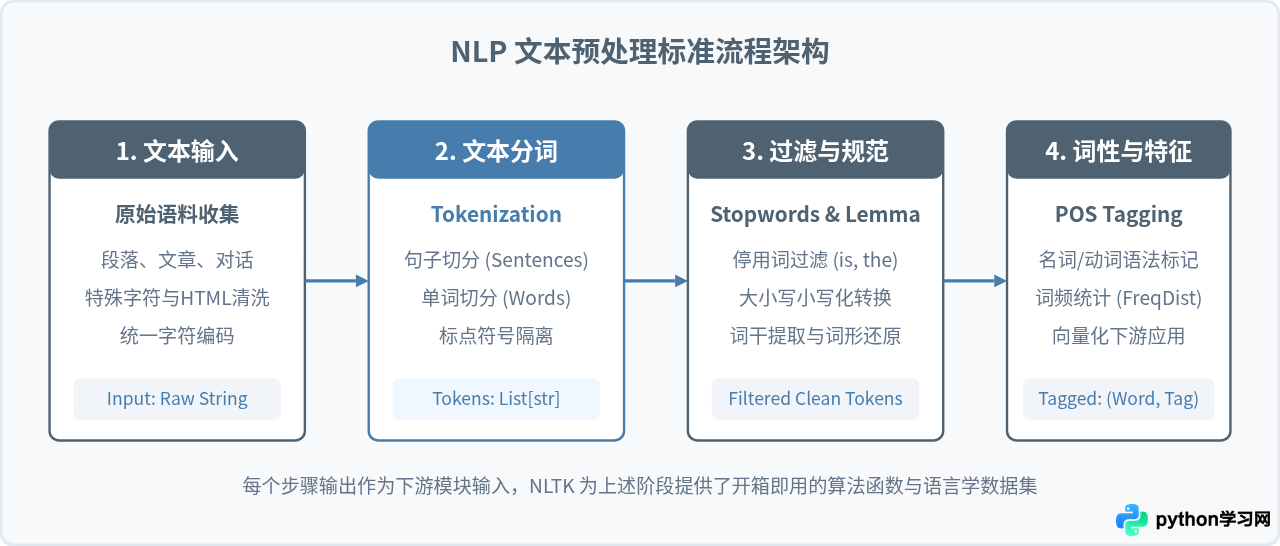
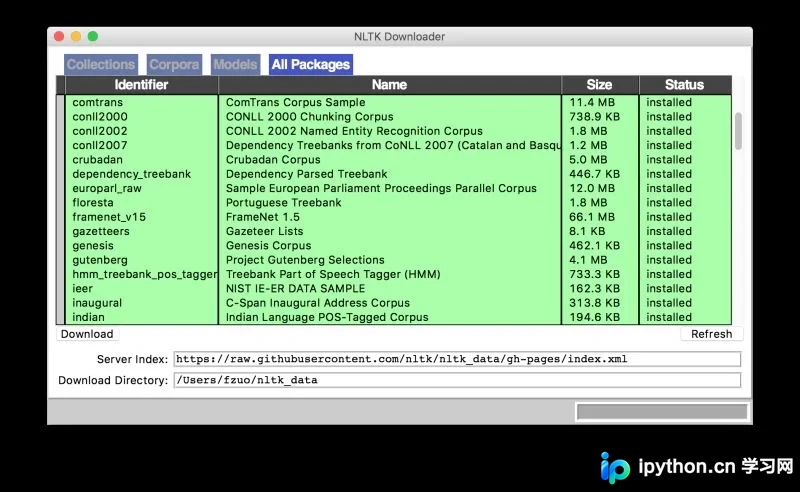
本教程针对Python自然语言处理(NLP)初学者,详细讲解独立虚拟环境搭建、NLTK库与语料数据下载配置,并提供分词、停用词过滤、词形还原与词性标注的完整实操代码。