

PHP实现百万级数据分表:1亿条数据拆分至MySQL 100张表的实战
本文详细解析如何在PHP环境下将1亿条海量数据存储于MySQL数据库,通过crc32算法对主键进行哈希运算,自动路由至预先创建的100张子表中。结合MERGE存储引擎汇总查询,解决单一表性能瓶颈,提供完整的建表、路由与合并逻辑代码示例。
2026-10-13
6

本文详细解析如何在PHP环境下将1亿条海量数据存储于MySQL数据库,通过crc32算法对主键进行哈希运算,自动路由至预先创建的100张子表中。结合MERGE存储引擎汇总查询,解决单一表性能瓶颈,提供完整的建表、路由与合并逻辑代码示例。
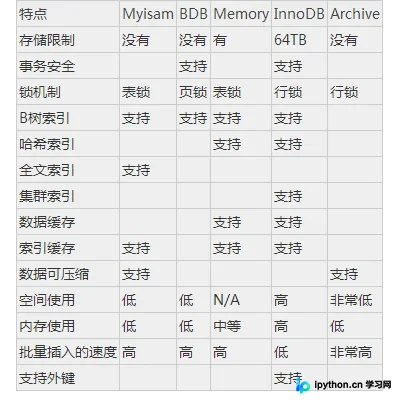
详解MySQL核心存储引擎InnoDB、MyISAM及Archive的特性差异。InnoDB支持ACID事务与行级锁,适合高并发业务;MyISAM提供全文索引与压缩优化,侧重读取效率。根据数据一致性要求、备份需求及并发特性选择合适引擎,并给出my.cnf关键配置参数。
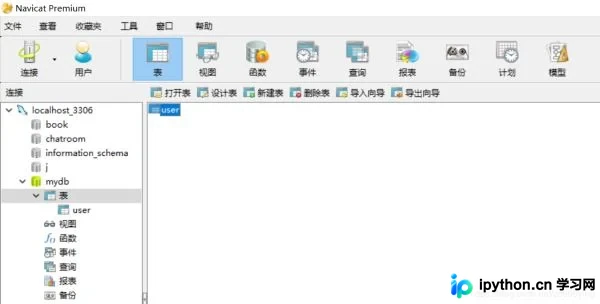
本文详细介绍 Python 中 PyMySQL 模块的使用方法,涵盖建立数据库连接、配置连接参数、创建游标对象及常用方法。通过具体代码示例演示数据的查询、插入、更新与删除操作,并对比 Java 说明 Python 在数据库处理上的简洁性,帮助开发者快速掌握 Python 操作 MySQL 的核心技巧。
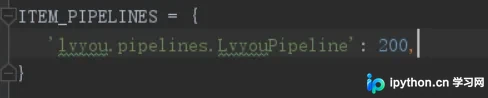
本文详细介绍 Scrapy 框架将数据持久化至 MySQL 数据库的两种核心方式:同步操作与基于 Twisted 的异步存储。文章涵盖 pipelines.py 配置、数据库连接池建立及错误处理机制,并针对中文乱码、特殊字符报错及重复数据累积问题提供具体解决方案,包括使用 pymysql.escape_string 和 scrapy-deltafetch 等插件实现增量爬取。
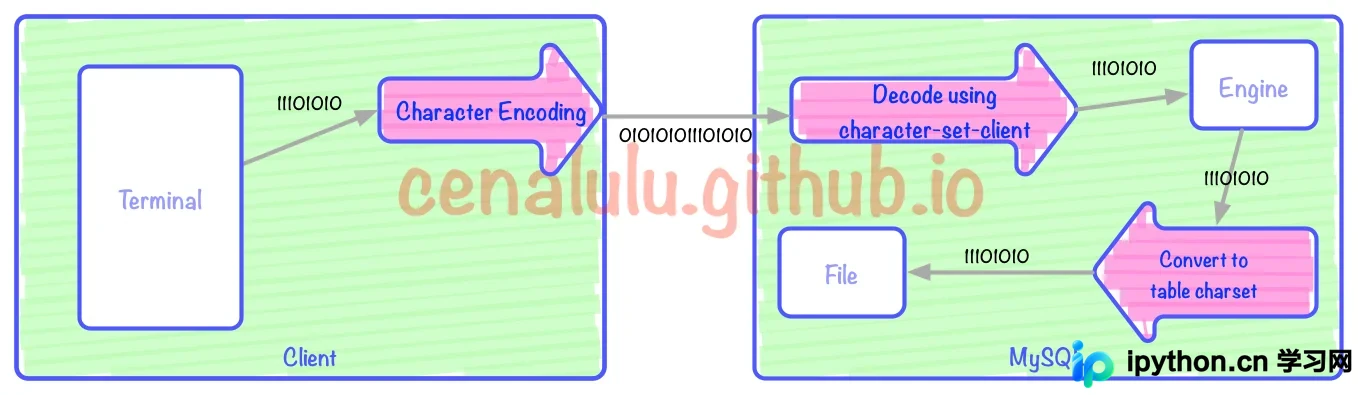
本文解析MySQL乱码的底层原理,重点阐述“错进错出”现象及有损/无损转换机制。通过对比错误操作(ALTER CHARSET)与正确修复手段(Dump/Reload、二进制中转),提供避免数据损坏并彻底解决UTF-8与GBK兼容问题的实操方案。
本文详细解析 MySQL 常用数据管理命令。涵盖利用 mysqldump 进行单库、多库及全库备份与结构导出的方法,介绍通过管道 gzip 实现压缩备份,以及使用 SELECT...INTO OUTFILE 和 LOAD DATA INFILE 进行高速 CSV 格式数据交换的操作步骤与参数配置。
本文介绍了在Linux和Windows系统下使用命令行工具备份和还原MySQL数据库的方法。详细讲解了mysqldump与mysql命令的参数用法,涵盖普通SQL文件的导出导入以及gzip压缩文件的处理流程,并简述了Windows环境下的操作路径,帮助规避Web界面超时风险,实现高效数据安全操作。
本文详解MySQL高效查询语句的设计方法。涵盖合理建立索引(连接键、排序字段)、避免低效的 LIKE 模糊匹配与非开头子串查询、使用 UNION 替代 OR 以利用索引、消除相关子查询、以及通过临时表和排序替代顺序存取等策略,旨在显著降低I/O开销并提升数据库响应速度。
本文详细介绍如何在 Python 3.6 环境中通过 pip 安装 PyMySQL 库,并演示如何使用该库连接 MySQL 数据库。内容涵盖建立连接、执行查询、插入、更新及删除数据的具体代码示例,包括参数传递、事务提交与回滚处理,帮助开发者快速掌握 Python 操作 MySQL 的基础技能。

本文详解如何使用Flask框架连接并操作MySQL数据库。内容涵盖通过PyMySQL直接创建数据表、插入查询数据,以及利用SQLAlchemy进行ORM模型定义、用户增删查改接口开发。包含完整的代码示例与JSON返回格式说明,适合Python后端开发者参考。
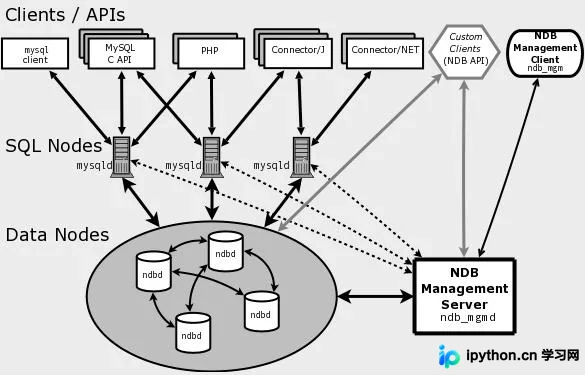
详解MySQL Cluster高可用架构,重点解析基于NDB内存存储引擎的数据同步机制。提供包含1个管理节点、2个数据节点和2个SQL节点的完整配置流程,涵盖config.ini与my.cnf关键参数设置、服务启动顺序及双向同步与故障恢复验证方法。
本文详细介绍在Ubuntu系统中从零搭建Nginx、PHP和MySQL运行环境的步骤。涵盖软件安装、Nginx与PHP-FastCGI的配置、权限设置及开机自启,解决“No input file specified”等常见报错,帮助你快速构建本地开发或生产服务器。